ВВЕДЕНИЕ
Современные компьютерные системы обеспечивают выполнение значительной части информационных процессов организаций: обработку данных, обмен сообщениями, удаленное администрирование, хранение служебной информации, работу прикладных сервисов и взаимодействие пользователей с корпоративной инфраструктурой. Нарушение таких процессов приводит не только к техническим сбоям, но и к финансовым потерям, утечкам данных, остановке производственных операций и снижению доверия к организации. Поэтому защита информационных процессов от сетевых вторжений является одной из важных задач информационной безопасности.
Актуальность темы курсовой работы определяется устойчивым ростом числа сетевых атак, автоматизацией действий злоумышленников и расширением поверхности атаки. На начало 2026 г. аналитические отчеты в области кибербезопасности показывают, что значительная доля инцидентов связана с компрометацией учетных данных, подбором паролей, эксплуатацией уязвимостей сетевых сервисов, атаками на SSH, Telnet, веб-приложения, VPN-шлюзы, облачную и контейнерную инфраструктуру [1; 2; 3]. При этом классические средства защиты, основанные только на сигнатурах, не всегда позволяют своевременно обнаруживать новые сценарии атак и собирать подробные сведения о поведении нарушителя.
Одним из перспективных направлений проактивной защиты являются honeypot-технологии. Honeypot представляет собой специально подготовленный ресурс-приманку, предназначенный для привлечения злоумышленника, регистрации его действий и получения информации о применяемых методах вторжения. В отличие от обычных серверов, обращение к honeypot само по себе рассматривается как подозрительное событие, так как легитимные пользователи не должны взаимодействовать с такой системой. За счет этого honeypot позволяет фиксировать разведку, попытки подбора учетных данных, команды атакующего, загружаемые файлы и иные признаки атаки на ранней стадии [7; 8].
Вместе с тем традиционные honeypot-системы имеют ряд ограничений. Статическая логика ответов, ограниченный набор поддерживаемых команд и большой объем собираемых логов снижают эффективность их применения. В условиях массовых автоматизированных атак специалисту сложно вручную анализировать все события, выделять наиболее опасные сессии и определять тип вторжения. Поэтому важным направлением развития honeypot-технологий является их интеграция с методами машинного обучения, позволяющими классифицировать сетевые атаки, выявлять аномальные сценарии и повышать информативность собираемых данных [10; 11; 17].
Объектом исследования в курсовой работе являются информационные процессы в компьютерных системах, подвергающиеся риску сетевых вторжений.
Предметом исследования являются honeypot-технологии и методы машинного обучения, применяемые для обнаружения, анализа и классификации сетевых атак.
Цель курсовой работы состоит в анализе возможностей применения honeypot-технологий для защиты информационных процессов в компьютерных системах от сетевых вторжений и в обосновании архитектуры honeypot-системы с модулем машинного обучения.
Для достижения указанной цели необходимо решить следующие задачи:
1. Проанализировать состояние современных киберинцидентов и основные угрозы информационным процессам на начало 2026 г.
2. Рассмотреть понятие, классификацию и принципы функционирования honeypot-систем.
3. Выполнить сравнительный анализ существующих honeypot-решений, включая Kippo, Cowrie и Beelzebub.
4. Рассмотреть применение методов машинного обучения в задачах обнаружения сетевых вторжений.
5. Сравнить алгоритмы Random Forest и Isolation Forest с точки зрения их использования в составе honeypot-системы.
6. Обосновать выбор датасета, признаков, программных средств и архитектуры проектируемой системы.
7. Сформулировать постановку задачи экспериментальной апробации прототипа honeypot-системы.
Методологическую основу работы составляют анализ научной литературы и отраслевых отчетов, сравнительный анализ программных решений, системный подход к проектированию архитектуры средств защиты, а также методы классификации и обнаружения аномалий в данных сетевой безопасности.
Практическая значимость работы заключается в том, что ее результаты могут быть использованы при подготовке прототипа honeypot-системы, предназначенной для сбора данных о сетевых вторжениях, классификации атак и оценки поведения злоумышленников в контролируемой среде.
ГЛАВА 1. АНАЛИЗ УГРОЗ ИНФОРМАЦИОННЫМ ПРОЦЕССАМ И СРЕДСТВ ЗАЩИТЫ ОТ СЕТЕВЫХ ВТОРЖЕНИЙ
1.1. Анализ состояния киберинцидентов на начало 2026 г. по данным ведущих аналитических центров
Информационные процессы в компьютерных системах включают передачу, хранение, обработку, поиск и использование данных. Для современной организации такие процессы реализуются через серверы, сетевые сервисы, базы данных, автоматизированные рабочие места, облачные платформы, контейнерные среды и средства удаленного администрирования. Сетевое вторжение нарушает нормальное выполнение этих процессов. Последствия могут выражаться в несанкционированном доступе к информации, изменении или уничтожении данных, блокировании сервисов, использовании инфраструктуры организации для дальнейших атак.
На начало 2026 г. состояние киберугроз характеризуется несколькими устойчивыми тенденциями. Во-первых, продолжает расти количество инцидентов, связанных с вредоносным программным обеспечением, фишингом, компрометацией учетных данных и эксплуатацией уязвимостей. Во-вторых, атаки становятся более автоматизированными. Злоумышленники применяют сканеры, ботнеты, готовые наборы эксплойтов, инструменты подбора паролей и средства массовой доставки вредоносных файлов. В-третьих, увеличивается роль атак без применения классического вредоносного кода, когда нарушитель использует легитимные учетные данные и штатные инструменты администрирования [1; 3; 5].
Для защиты информационных процессов особенно опасны атаки на сервисы удаленного доступа. Протоколы SSH, Telnet, RDP и VPN применяются для управления серверами и сетевым оборудованием, поэтому их компрометация может дать злоумышленнику прямой доступ к внутренней инфраструктуре. По данным аналитических отчетов, атаки на SSH и Telnet остаются одним из распространенных сценариев автоматизированного сканирования и подбора паролей. Это связано с тем, что в сети постоянно присутствуют серверы с типовыми учетными записями, устаревшими версиями программного обеспечения или недостаточно надежной политикой аутентификации.
Отдельное значение имеет рост числа инцидентов, связанных с использованием украденных учетных данных. Для злоумышленника такой сценарий удобен тем, что его действия могут выглядеть как обычная активность пользователя или администратора. В этом случае традиционные сигнатурные средства обнаружения не всегда срабатывают, так как вредоносный файл может отсутствовать, а вход в систему производится через штатный протокол. Поэтому для выявления подобных атак требуется анализ поведения: времени входа, источника соединения, количества неудачных попыток, последовательности команд, обращения к необычным ресурсам и других косвенных признаков. Серьезной проблемой является скорость развития атаки.
Таким образом, анализ киберинцидентов на начало 2026 г. показывает, что угрозы информационным процессам становятся массовыми, быстрыми и поведенчески сложными. Для их обнаружения недостаточно только реагировать на известные сигнатуры. Требуются средства, способные наблюдать действия нарушителя, собирать фактические данные о вторжениях и автоматически выделять наиболее значимые признаки атаки. Honeypot-технологии отвечают этим требованиям и могут рассматриваться как важный элемент проактивной защиты.
1.2. Honeypot-технологии как средство защиты информационных процессов: понятие, классификация, принципы функционирования
Понятие honeypot в области информационной безопасности обычно связывается с системой-приманкой, предназначенной для привлечения злоумышленника и фиксации его действий. Ценность такого ресурса состоит не в выполнении производственных функций, а в возможности наблюдать несанкционированное взаимодействие. Если пользователь или программа обращается к honeypot, это событие рассматривается как индикатор разведки, попытки атаки или ошибочной настройки сети.
В контексте защиты информации honeypot следует рассматривать как вспомогательное средство обнаружения и анализа несанкционированных воздействий. Согласно ГОСТ Р 50922-2006, защита информации направлена на предотвращение утечки защищаемой информации, несанкционированных и непреднамеренных воздействий на нее [2]. Honeypot не заменяет межсетевой экран или систему контроля доступа, однако расширяет возможности защиты за счет получения сведений о действиях атакующего в специально подготовленной среде.
Принцип работы honeypot основан на создании для нарушителя правдоподобной цели. Система может имитировать сервер удаленного доступа, веб-приложение, базу данных, устройство интернета вещей, промышленный контроллер или иной компонент инфраструктуры. Злоумышленник, обнаружив такой ресурс при сканировании, пытается взаимодействовать с ним: подобрать пароль, выполнить команду, загрузить файл, проверить наличие уязвимости. Все эти действия регистрируются и передаются на последующий анализ.
По уровню интерактивности honeypot-системы принято делить на низкоинтерактивные, среднеинтерактивные и высокоинтерактивные [14; 15].
Низкоинтерактивные honeypot-системы имитируют ограниченный набор сетевых сервисов. Они способны принять соединение, вернуть типовой ответ, зафиксировать IP-адрес источника, порт, время обращения и отдельные параметры запроса. Основное преимущество таких систем состоит в простоте развертывания и низком риске компрометации. Однако их аналитическая ценность ограничена, так как взаимодействие с нарушителем обычно завершается на раннем этапе.
Среднеинтерактивные honeypot-системы реализуют более развитую эмуляцию сервиса. Они позволяют атакующему пройти часть сценария взаимодействия: выполнить псевдоаутентификацию, работать с командной оболочкой, просматривать виртуальную файловую систему, загружать файлы или отправлять сетевые запросы. Такие решения дают больше данных о поведении нарушителя, но при этом не предоставляют ему полного контроля над реальной операционной системой. Именно к этому классу относятся популярные SSH/Telnet honeypot-системы Kippo и Cowrie.
Высокоинтерактивные honeypot-системы используют реальную или почти реальную среду, в которой злоумышленник может выполнять широкий набор действий. Они обладают высокой исследовательской ценностью, так как позволяют наблюдать полный жизненный цикл атаки. Однако такие системы требуют строгой изоляции, постоянного мониторинга и дополнительных мер безопасности. При ошибках в настройке высокоинтерактивный honeypot может быть использован нарушителем как плацдарм для атак на другие ресурсы.
По назначению выделяют исследовательские и производственные honeypot-системы. Исследовательские ловушки применяются для изучения методов атак, сбора вредоносного программного обеспечения, анализа поведения ботнетов и подготовки аналитических отчетов. Они обычно размещаются в контролируемых средах и ориентированы на максимальный объем данных. Производственные honeypot используются в инфраструктуре организации для раннего обнаружения вторжений. Их задача состоит не в глубоком исследовании всех действий нарушителя, а в своевременном формировании сигнала о подозрительной активности.
По типу имитируемых ресурсов honeypot-системы могут быть серверными, клиентскими, сетевыми, прикладными, IoT-ориентированными и промышленными. Серверные honeypot имитируют открытые сетевые сервисы, например SSH, Telnet, HTTP, FTP, SMB или базы данных. Клиентские honeypot моделируют поведение пользовательских приложений и применяются для обнаружения вредоносных сайтов. IoT-honeypot ориентированы на устройства интернета вещей, где часто встречаются слабые пароли и устаревшие протоколы. Промышленные honeypot имитируют компоненты автоматизированных систем управления технологическими процессами.
С точки зрения архитектуры honeypot может быть одиночным или входить в состав honeynet. Одиночный honeypot представляет собой отдельную ловушку, размещенную в сети. Honeynet включает несколько взаимосвязанных ловушек, имитирующих сегмент инфраструктуры.
1.3. Сравнительный анализ существующих honeypot-решений (Cowrie, Kippo, Beelzebub)
Kippo является одним из первых распространенных среднеинтерактивных SSH-honeypot. Он был разработан как ловушка, имитирующая Unix-подобную систему и позволяющая атакующему выполнить ограниченный набор команд после условно успешной аутентификации. В архитектуре Kippo использовался язык Python и асинхронный сетевой фреймворк Twisted. Система включала модуль приема соединений, механизм имитации входа, виртуальную файловую систему, эмулятор командной оболочки и подсистему логирования.
Сильной стороной Kippo было то, что он позволял фиксировать не только факт подбора пароля, но и дальнейшее поведение нарушителя. Атакующий мог выполнять команды вроде ls, cd, cat, uname, wget, просматривать псевдокаталоги и пытаться загружать файлы. Для исследователя такие данные значительно ценнее, чем простая запись о неудачной попытке входа. По логам Kippo можно было изучать используемые словари паролей, команды первичной разведки, адреса загрузки вредоносных скриптов и типовые ошибки автоматизированных ботов.
Однако Kippo имеет существенные ограничения. Проект перестал активно развиваться, его эмуляция выглядит недостаточно гибкой по современным меркам, а поддержка протоколов и форматов интеграции ограничена. Опытный нарушитель может распознать ловушку по неполной реализации команд, статичной файловой системе или нетипичным ответам. Поэтому Kippo важен прежде всего как историческая основа для дальнейшего развития SSH-honeypot, но не как оптимальная платформа для нового прототипа.
Cowrie возник как развитие идей Kippo и в настоящее время является одним из наиболее распространенных open-source решений для эмуляции SSH и Telnet. Он реализован на Python 3, использует Twisted и поддерживает более развитую архитектуру логирования. Cowrie может работать в режиме эмуляции командной оболочки и в режиме прокси, при котором сессия перенаправляется на изолированную систему. Для курсовой работы и будущего прототипа наиболее важен режим эмуляции, так как он безопаснее и проще для воспроизведения в лабораторной среде.
Функциональные возможности Cowrie шире, чем у Kippo. Система поддерживает SSH, Telnet, SFTP, расширенный набор команд, виртуальную файловую систему, сохранение загруженных файлов, запись сессий и вывод логов в формате JSON. JSON-формат особенно важен для машинного обучения, так как позволяет автоматически извлекать признаки: количество попыток входа, длительность сессии, последовательность команд, наличие загрузки файла, используемые логины и пароли, IP-адрес источника, временные интервалы между действиями.
Еще одним преимуществом Cowrie является развитая интеграция с внешними системами. Логи могут передаваться в Elasticsearch, Splunk, базы данных и другие средства аналитики. Это позволяет использовать Cowrie не только как отдельную ловушку, но и как элемент инфраструктуры мониторинга безопасности. В учебном прототипе достаточно сохранять события в JSON-файлы и обрабатывать их средствами Python, но архитектура Cowrie оставляет возможность дальнейшего расширения.
Beelzebub представляет более современный подход к построению honeypot. Его особенность состоит в использовании больших языковых моделей для генерации правдоподобных ответов на действия атакующего. В традиционных системах набор поддерживаемых команд ограничен заранее заданными обработчиками. Если нарушитель вводит нестандартную команду, ловушка может ответить неправдоподобно и тем самым выдать себя. В Beelzebub ответ может формироваться динамически с учетом контекста сессии, роли сервера и истории взаимодействия.
Интеграция с языковыми моделями повышает реалистичность honeypot, но одновременно усложняет систему. Для работы требуется подключение к внешнему или локальному LLM-провайдеру, настройка промптов, контроль передаваемых данных и защита от нежелательной генерации. Кроме того, использование LLM может увеличивать задержку ответа и зависимость от вычислительных ресурсов. Поэтому Beelzebub целесообразно рассматривать как перспективное решение, но для курсового прототипа более надежным и предсказуемым вариантом остается Cowrie.
В смежных исследованиях также рассматриваются комплексные и адаптивные платформы, например T-Pot и CannyPot [26; 27]. T-Pot удобен для развертывания набора разных ловушек в единой инфраструктуре, а CannyPot демонстрирует подход к расширению поведения SSH-honeypot за счет обучения с подкреплением. Однако для поставленной задачи такие решения избыточны: курсовая работа ориентирована на понятный прототип с анализом логов и классификацией атак. Сравнение рассматриваемых решений представлено в таблице 1.
Таблица 1 - Сравнение honeypot-решений Kippo, Cowrie и Beelzebub
| Критерий | Kippo | Cowrie | Beelzebub |
| Основное назначение | SSH-ловушка с эмуляцией командной оболочки | SSH/Telnet/SFTP honeypot с развитым логированием | Адаптивный honeypot с генерацией ответов на основе LLM |
| Уровень интерактивности | Средний | Средний, возможен прокси-режим | Средний с адаптивной логикой |
| Поддерживаемые протоколы | SSH | SSH, Telnet, SFTP | SSH, HTTP, TCP в зависимости от конфигурации |
| Логирование | Текстовые логи и база данных | JSON, базы данных, интеграция с аналитическими системами | Логи сессий и событий, зависят от конфигурации |
| Пригодность для машинного обучения | Ограниченная | Высокая за счет структурированных событий | Перспективная, но требует дополнительной настройки |
| Основные ограничения | Устаревание, статичная эмуляция | Необходимость настройки и сопровождения | Сложность, зависимость от LLM и ресурсов |
Из таблицы видно, что Cowrie занимает промежуточное и наиболее практичное положение. Он значительно современнее Kippo и в то же время проще для лабораторного применения, чем Beelzebub. Для задачи защиты информационных процессов от сетевых вторжений важны не только реалистичные ответы, но и качество собираемых данных. Cowrie обеспечивает структурированную запись событий, что позволяет построить конвейер анализа: получение логов, извлечение признаков, классификация атаки и формирование отчета.
Важным критерием выбора является безопасность развертывания. Kippo и Cowrie не предоставляют атакующему реальный доступ к операционной системе в базовом режиме, так как работают с эмулированной средой. Beelzebub также может быть настроен как изолированная ловушка, но сложность взаимодействия с LLM требует дополнительных мер контроля. Для учебного прототипа, где необходимо обеспечить воспроизводимость и минимизировать риск, предпочтительно использовать проверенную платформу с понятной архитектурой.
С точки зрения дальнейшего развития интерес представляет сочетание Cowrie и интеллектуального модуля анализа. Базовая honeypot-платформа отвечает за прием соединений и сбор данных, а модуль машинного обучения обрабатывает события и определяет тип атаки. Такой подход позволяет не менять внутреннюю логику Cowrie и одновременно повысить эффективность анализа. В перспективе к этой архитектуре можно добавить элементы адаптивной генерации ответов, характерные для Beelzebub, однако в рамках курсовой работы достаточно обосновать базовую архитектуру с классификатором.
Таким образом, сравнительный анализ показывает, что Kippo имеет значение как ранняя реализация SSH-honeypot, Beelzebub отражает перспективное направление интеллектуальных ловушек, а Cowrie является наиболее рациональным выбором для проектируемой системы. Он сочетает достаточную реалистичность эмуляции, поддержку актуальных протоколов, развитое логирование и удобство интеграции с алгоритмами машинного обучения.
Выводы по главе 1
В первой главе были рассмотрены основные угрозы информационным процессам в компьютерных системах и роль honeypot-технологий в их обнаружении. Анализ состояния киберинцидентов на начало 2026 г. показывает, что современные атаки становятся более массовыми, автоматизированными и ориентированными на компрометацию учетных данных, сервисов удаленного доступа, контейнерной и облачной инфраструктуры.
Установлено, что honeypot-системы являются средством проактивной защиты, позволяющим привлекать злоумышленника в контролируемую среду, фиксировать его действия и получать данные о реальных сценариях вторжений. По уровню интерактивности honeypot делятся на низкоинтерактивные, среднеинтерактивные и высокоинтерактивные. Для учебного и исследовательского прототипа наиболее целесообразны среднеинтерактивные решения, так как они обеспечивают достаточную информативность при умеренном уровне риска.
Сравнительный анализ Kippo, Cowrie и Beelzebub показал, что наиболее рациональной базовой платформой для проектируемой системы является Cowrie. Данная honeypot-система поддерживает SSH, Telnet и SFTP, обеспечивает структурированное логирование в формате JSON и может быть интегрирована с модулем машинного обучения. Это создает основу для дальнейшего анализа методов повышения эффективности honeypot-систем на основе автоматической классификации атак.
ГЛАВА 2. АНАЛИЗ МЕТОДИК ПОВЫШЕНИЯ ЭФФЕКТИВНОСТИ HONEYPOT-СИСТЕМ НА ОСНОВЕ МАШИННОГО ОБУЧЕНИЯ
2.1. Применение методов машинного обучения в задачах обнаружения сетевых вторжений
Системы обнаружения вторжений традиционно опираются на два основных подхода: сигнатурный и поведенческий. Сигнатурный подход предполагает поиск известных признаков атаки: характерных строк, хэш-сумм, последовательностей команд, сетевых пакетов или правил. Он хорошо работает для уже изученных угроз, но хуже справляется с новыми сценариями, измененными вредоносными программами и атаками, основанными на использовании легитимных средств. Поведенческий подход ориентирован на выявление отклонений от нормальной активности и анализ совокупности признаков [10; 11].
Машинное обучение относится к методам, позволяющим автоматически находить закономерности в данных. В задачах обнаружения сетевых вторжений оно применяется для классификации трафика, выявления аномалий, оценки риска событий, группировки похожих сессий и прогнозирования развития атаки. В отличие от жестко заданных правил, модель машинного обучения может учитывать большое количество признаков и выявлять связи, которые трудно формализовать вручную.
Для honeypot-систем машинное обучение особенно актуально по нескольким причинам. Во-первых, honeypot собирает данные, непосредственно связанные с действиями нарушителей. Это не абстрактный сетевой шум, а сессии взаимодействия с системой-приманкой. Во-вторых, объем таких данных может быть значительным. Даже один открытый SSH-honeypot способен фиксировать большое количество попыток подбора паролей и коротких автоматизированных сессий. В-третьих, не все события одинаково значимы, поэтому требуется автоматическое выделение более опасных сценариев.
Данные honeypot могут использоваться для решения нескольких задач машинного обучения. Первая задача - бинарная классификация, при которой событие относится к нормальной или вредоносной активности. Для honeypot данное разделение имеет особенности, так как почти любое внешнее взаимодействие с ловушкой подозрительно. Однако бинарная классификация может применяться для разделения простых сканирований и более содержательных атак.
Вторая задача - многоклассовая классификация атак. В этом случае модель определяет тип события: brute-force, попытка загрузки вредоносного файла, разведка системы, эксплуатация уязвимости, попытка закрепления, сетевое сканирование изнутри сессии. Такая классификация полезна для формирования отчетов и выбора мер реагирования.
Третья задача - обнаружение аномалий. Она направлена на выявление событий, которые отличаются от основной массы наблюдений. Для honeypot это важно, потому что новые атаки могут не соответствовать заранее заданным классам. Например, необычная последовательность команд, редкий набор параметров или нестандартная длительность сессии могут указывать на ручную активность более подготовленного нарушителя. Четвертая задача - кластеризация. Важным этапом является предварительная обработка данных.
Таким образом, машинное обучение повышает эффективность honeypot-систем за счет автоматической обработки собранных событий, классификации атак, обнаружения аномалий и выделения наиболее значимых сессий. Для проектируемой системы наиболее рациональным является использование сочетания контролируемой классификации и метода обнаружения аномалий.
2.2. Сравнительный анализ алгоритмов Random Forest и Isolation Forest как инструментов классификации атак
В рамках проектируемой honeypot-системы целесообразно рассмотреть два алгоритма: Random Forest и Isolation Forest. Они относятся к семейству методов на основе деревьев решений, но решают разные задачи. Random Forest применяется для классификации и регрессии при наличии размеченных данных. Isolation Forest предназначен для обнаружения аномалий и может работать без полной разметки всех типов атак.
Random Forest представляет собой ансамбль деревьев решений. Каждое дерево обучается на случайной подвыборке объектов и случайном наборе признаков. Итоговое решение принимается голосованием деревьев. Такой подход снижает риск переобучения по сравнению с одиночным деревом и позволяет получать устойчивые результаты на табличных данных. В задачах обнаружения вторжений Random Forest часто применяется для многоклассовой классификации сетевых событий [20; 21].
Преимуществом Random Forest является способность работать с нелинейными зависимостями и признаками разной природы. При использовании логов Cowrie потребуется либо ручная разметка части сессий, либо сопоставление признаков с заранее определенными правилами.
Основное ограничение Random Forest состоит в зависимости от качества разметки. Если модель обучена только на известных типах атак, она может некорректно классифицировать новый сценарий как один из известных классов. Кроме того, при несбалансированных данных модель может чаще выбирать преобладающий класс. В сетевой безопасности это распространенная проблема: одни типы событий встречаются массово, другие редки, но могут быть более опасными. Для уменьшения этого эффекта применяются балансировка выборки, настройка весов классов и анализ метрик по каждому классу.
Isolation Forest решает другую задачу. Его идея основана на том, что аномальные объекты легче изолировать случайными разбиениями пространства признаков. Если объект сильно отличается от большинства наблюдений, для его отделения требуется меньше разбиений. Алгоритм строит набор случайных деревьев изоляции и вычисляет оценку аномальности. Чем выше отклонение объекта от основной массы, тем вероятнее, что событие является аномальным [24].
Преимущество Isolation Forest состоит в том, что он не требует детальной разметки всех типов атак. Это важно для honeypot, где часть событий может относиться к новым или редким сценариям. Кроме того, результат зависит от состава данных. Если в выборке много вредоносных событий одного типа, они могут стать для модели «нормой», а редкие, но неопасные события будут выделяться как аномалии. Поэтому необходимо правильно формировать обучающую выборку и периодически пересматривать параметры. Сравнение алгоритмов представлено в таблице 2.
Таблица 2 - Сравнение Random Forest и Isolation Forest для анализа событий honeypot
| Критерий | Random Forest | Isolation Forest |
| Основная задача | Классификация известных типов атак | Обнаружение аномальных сессий |
| Требование к разметке | Требует размеченную выборку | Может работать без полной разметки |
| Результат работы | Метка класса | Оценка аномальности |
| Интерпретируемость | Доступна оценка важности признаков | Требует дополнительной интерпретации |
| Применение в системе | Второй уровень анализа и отчетность | Первый уровень выделения нетипичных событий |
| Ограничения | Зависимость от качества разметки | Не определяет конкретный тип атаки |
Для проектируемой honeypot-системы наиболее целесообразно использовать оба алгоритма как взаимодополняющие. Isolation Forest может выполнять первичное обнаружение аномальных сессий, а Random Forest - классификацию событий по типам атак при наличии размеченных данных. Такая двухуровневая схема повышает устойчивость системы: известные атаки классифицируются, а неизвестные или редкие сценарии не теряются в общем потоке событий.
Практическая реализация может быть следующей. Сначала события Cowrie группируются по идентификатору сессии. Затем из каждой сессии извлекается вектор признаков. Этот вектор поступает в модуль Isolation Forest, который рассчитывает оценку аномальности. Если сессия признана нетипичной, она получает повышенный приоритет. Далее тот же вектор передается в Random Forest, который определяет наиболее вероятный класс атаки. Результат сохраняется в отчете вместе с исходными событиями, чтобы аналитик мог проверить вывод модели. При оценке качества Random Forest следует использовать метрики accuracy, precision, recall и F1-score. Isolation Forest полезен для выявления нетипичных сессий, которые могут соответствовать новым или более сложным сценариям. Их совместное применение является обоснованным направлением повышения эффективности honeypot-системы.
2.3. Выбор датасета и формирование набора информативных признаков для обучения классификатора
Качество модели машинного обучения в значительной степени зависит от выбранного датасета и набора признаков. Для задач обнаружения вторжений часто используются эталонные наборы данных, позволяющие сравнивать алгоритмы в одинаковых условиях [12; 23]. Одним из таких наборов является NSL-KDD. Он был создан как улучшенная версия KDD Cup 99 и широко применяется в учебных и исследовательских работах по обнаружению сетевых атак [21].
NSL-KDD содержит записи сетевых соединений, описанные набором признаков и меткой класса. Атаки в нем группируются по нескольким категориям: DoS, Probe, R2L и U2R. DoS-атаки направлены на отказ в обслуживании. Probe соответствует разведке и сканированию. R2L означает попытки получения удаленного доступа к локальной системе. U2R описывает переход от обычного пользовательского доступа к привилегированному. Хотя NSL-KDD не отражает полностью современный ландшафт угроз, он удобен для первоначального обучения и проверки алгоритмов.
Для проектируемой honeypot-системы NSL-KDD может использоваться как базовый датасет для отработки классификатора. Его преимущества заключаются в доступности, наличии разметки и понятной структуре признаков. С его помощью можно проверить работу Random Forest, оценить метрики классификации, подобрать параметры модели и отработать конвейер предварительной обработки. Однако для анализа реальных событий Cowrie потребуется дополнить или адаптировать признаки, так как логи honeypot описывают не только сетевые соединения, но и поведение в командной оболочке.
Поэтому целесообразно использовать комбинированный подход. На первом этапе модель обучается и проверяется на NSL-KDD, что позволяет получить воспроизводимый результат. На втором этапе формируется собственный набор признаков из логов Cowrie. Эти признаки могут быть сопоставлены с классами атак вручную или с помощью правил. Например, сессии с большим количеством неудачных попыток входа относятся к brute-force, сессии с командами uname, whoami, id, pwd и ls - к разведке, сессии с wget, curl, chmod и запуском скрипта - к попытке загрузки и выполнения вредоносного кода.
Признаки для анализа событий honeypot можно разделить на несколько групп.
Первая группа - сетевые признаки. К ним относятся IP-адрес источника, порт назначения, протокол, время начала сессии, длительность соединения, количество событий в сессии, интервалы между командами. IP-адрес сам по себе не всегда следует использовать как прямой признак, так как модель может переобучиться на конкретные адреса. Однако можно использовать производные признаки: принадлежность к внутренней или внешней сети, частоту появления адреса, количество сессий с одного источника за период.
Вторая группа - признаки аутентификации. Они включают количество попыток входа, число уникальных логинов, число уникальных паролей, долю повторяющихся комбинаций, факт условно успешного входа, используемые имена пользователей. Для brute-force характерны многочисленные попытки с разными паролями или логинами. Для ручной атаки может быть характерно меньшее число попыток, но более осмысленный выбор учетных данных.
Третья группа - командные признаки. Они описывают действия атакующего после входа: количество команд, число уникальных команд, наличие команд разведки, наличие команд загрузки файлов, попытки изменения прав, запуск скриптов, обращение к сетевым утилитам, просмотр системных файлов. Например, команды uname, id, whoami и pwd часто используются для первичной разведки. Команды wget, curl, chmod и sh могут указывать на загрузку и запуск вредоносного кода. Команды ps, netstat, ifconfig и ip используются для изучения процессов и сетевой конфигурации.
Четвертая группа - файловые признаки. Она включает факт загрузки файла, количество загруженных файлов, расширения, хэш-суммы, размер, URL-адреса источников загрузки. Эти признаки важны для выявления сценариев установки вредоносного программного обеспечения. Даже если сам файл не анализируется статически, факт загрузки и попытки запуска уже повышают уровень риска сессии.
Пятая группа - поведенческие признаки. Они описывают последовательность и темп действий. Например, автоматизированный бот обычно выполняет команды быстро и однотипно, с малыми интервалами. Ручная сессия может иметь паузы, ошибки ввода, изменение стратегии. Последовательность команд также важна: разведка, загрузка, изменение прав и запуск файла образуют логичную цепочку постэксплуатации.
Для подготовки признаков необходимо выполнить несколько этапов. Сначала JSON-логи Cowrie считываются и группируются по идентификатору сессии. Затем для каждой сессии рассчитываются агрегированные показатели. После этого категориальные значения кодируются, числовые признаки нормализуются при необходимости, а итоговая таблица сохраняется в формате CSV или Parquet. Далее данные делятся на обучающую и тестовую выборки. Таблица 3 содержит пример набора признаков для классификации сессий Cowrie.
Таблица 3 - Пример признаков для анализа сессий Cowrie
| Группа | Признак | Назначение |
| Сетевые | duration, event_count, src_sessions_24h | Оценка длительности и активности источника |
| Аутентификация | login_attempts, unique_users, unique_passwords, success_auth | Выявление подбора учетных данных |
| Команды | command_count, unique_commands, has_recon_cmd, has_download_cmd | Анализ действий после входа |
| Файлы | downloaded_files, has_executable, url_count | Обнаружение загрузки и запуска файлов |
| Поведение | avg_delay, min_delay, command_entropy | Различение автоматизированных и ручных сценариев |
Именно эти данные отражают механизмы вторжения и могут быть использованы для повышения эффективности honeypot-системы.
Выводы по главе 2
Во второй главе были рассмотрены методы повышения эффективности honeypot-систем на основе машинного обучения. Установлено, что машинное обучение позволяет автоматизировать анализ событий, классифицировать известные типы атак, выделять аномальные сессии и снижать нагрузку на специалиста при обработке больших объемов логов.
Сравнение Random Forest и Isolation Forest показало, что данные алгоритмы целесообразно применять совместно. Random Forest подходит для классификации известных типов атак при наличии размеченной выборки, обладает хорошей интерпретируемостью и позволяет оценивать важность признаков. Isolation Forest полезен для обнаружения нетипичных сессий и может применяться даже при отсутствии полной разметки данных.
Для обучения и апробации классификатора предложено использовать датасет NSL-KDD, а также набор признаков, формируемых из логов Cowrie. Наиболее информативными являются признаки аутентификации, командной активности, загрузки файлов, сетевых параметров и поведения в рамках сессии. Полученные выводы позволяют перейти к обоснованию архитектуры honeypot-системы с интегрированным модулем машинного обучения.
ГЛАВА 3. ОБОСНОВАНИЕ АРХИТЕКТУРЫ И ПРОГРАММНЫХ СРЕДСТВ ПРОЕКТИРУЕМОЙ HONEYPOT-СИСТЕМЫ
3.1. Обоснование выбора базовой honeypot-платформы и среды развертывания
Выбор базовой платформы для проектируемой honeypot-системы должен учитывать цель работы, требования безопасности, доступность инструментов и возможность интеграции с модулем машинного обучения. Поскольку объектом анализа являются сетевые вторжения, а особое значение имеют атаки на сервисы удаленного доступа, базовая платформа должна поддерживать эмуляцию SSH и желательно Telnet. Кроме того, она должна сохранять события в структурированном виде, чтобы данные можно было автоматически обрабатывать.
На основании сравнительного анализа, выполненного в первой главе, наиболее рациональным выбором является Cowrie. Данная система является среднеинтерактивным SSH/Telnet honeypot, поддерживает запись сессий, сохранение загружаемых файлов и вывод логов в формате JSON [18; 25]. Cowrie достаточно реалистичен для фиксации типовых сценариев атак, но при этом не предоставляет нарушителю полноценный доступ к реальной системе в базовом режиме эмуляции. Это снижает риск использования ловушки как средства дальнейшего нападения.
Для курсовой работы важна воспроизводимость. Cowrie может быть развернут в виртуальной машине или контейнере Docker. Виртуальная машина под управлением Ubuntu 22.04 LTS обеспечивает понятную лабораторную среду и совместимость с необходимыми инструментами. Docker позволяет изолировать компоненты, упростить повторное развертывание и сохранить единообразие конфигурации. Поэтому целесообразно использовать сочетание Ubuntu 22.04 LTS и Docker как среды развертывания.
Контейнеризация дает несколько преимуществ. Во-первых, зависимости Cowrie не смешиваются с пакетами хостовой системы. Во-вторых, конфигурацию можно быстро восстановить или перенести на другой стенд. В-третьих, контейнер легче ограничить по сетевым правилам и ресурсам. В-четвертых, при ошибке настройки можно удалить контейнер и развернуть его заново без повреждения основной системы. Для учебного прототипа эти преимущества особенно важны.
Размещение honeypot должно выполняться с учетом безопасности. Ловушка может находиться в отдельной виртуальной сети, демилитаризованной зоне или лабораторном сегменте. Необходимо ограничить исходящие соединения, чтобы атакующий не мог использовать систему для нападения на сторонние адреса. Разрешенными должны быть только те сетевые взаимодействия, которые нужны для эксперимента и передачи логов. Администраторский доступ к хосту должен быть отделен от интерфейса honeypot.
Для генерации тестовых сценариев целесообразно использовать отдельную виртуальную машину с Kali Linux. На ней могут быть установлены Nmap, Hydra и Metasploit Framework. Nmap подходит для сканирования портов и проверки доступности сервиса. Hydra используется для имитации подбора учетных данных по SSH. Metasploit может применяться для демонстрации отдельных сценариев постэксплуатации и проверки реакции системы на более сложные действия. При этом все эксперименты должны проводиться только в локальной лабораторной сети.
Структура лабораторного стенда может включать три основных узла: хост с honeypot Cowrie, узел атакующего с Kali Linux и узел анализа данных. В простом варианте узел анализа может быть совмещен с хостом honeypot, если вычислительных ресурсов достаточно. Однако логически эти функции лучше разделять: Cowrie собирает события, а модуль анализа обрабатывает данные и формирует результаты классификации.
Для хранения логов можно использовать файловую систему или базу данных. На первом этапе достаточно JSON-файлов Cowrie. Они удобны для чтения средствами Python и не требуют развертывания дополнительной инфраструктуры. В дальнейшем возможно подключение Elasticsearch или другой системы поиска, если объем данных увеличится. Такой поэтапный подход позволяет не усложнять прототип сверх необходимости.
Таким образом, выбор Cowrie, Ubuntu 22.04 LTS и Docker является обоснованным. Cowrie обеспечивает требуемую функциональность honeypot, Ubuntu предоставляет стабильную среду, Docker повышает воспроизводимость и изоляцию, а Kali Linux с инструментами Nmap, Hydra и Metasploit позволяет провести контролируемую экспериментальную апробацию.
3.2. Архитектура адаптивной honeypot-системы с интегрированным модулем машинного обучения
Проектируемая система должна обеспечивать не только фиксацию сетевых вторжений, но и автоматическую обработку собранных данных. Поэтому архитектуру целесообразно строить по модульному принципу. Каждый модуль выполняет отдельную функцию: прием соединений, сбор логов, предварительная обработка, извлечение признаков, классификация, обнаружение аномалий, хранение результатов и формирование отчета.
Первым компонентом является honeypot-модуль на базе Cowrie. Он имитирует SSH/Telnet-сервис, принимает входящие соединения, регистрирует попытки аутентификации, команды атакующего, загрузку файлов и другие события. На выходе данного модуля формируются JSON-логи и записи сессий. Cowrie не должен самостоятельно принимать решения о типе атаки. Его задача - надежно собрать первичные данные.
Вторым компонентом является модуль сбора и нормализации логов. Он периодически считывает новые записи Cowrie, проверяет их корректность, группирует события по идентификатору сессии и приводит данные к единому формату. На этом этапе удаляются дубли, обрабатываются пропуски, выделяются временные интервалы и связываются события аутентификации с последующими командами. Нормализация необходима для того, чтобы модель машинного обучения получала данные в стабильном виде.
Третьим компонентом является модуль извлечения признаков. Он преобразует последовательность событий в числовой вектор. Для каждой сессии рассчитываются признаки, описанные во второй главе: количество попыток входа, число уникальных логинов и паролей, длительность сессии, количество команд, наличие команд разведки, наличие загрузки файлов, число сетевых команд, средние интервалы между действиями. Результатом работы модуля является таблица признаков.
Четвертым компонентом является модуль машинного обучения. Он включает две модели: Isolation Forest и Random Forest. Isolation Forest выполняет обнаружение аномальных сессий и присваивает событию оценку аномальности. Random Forest выполняет классификацию по заранее определенным классам атак. Последовательность работы может быть организована так, что сначала вычисляется оценка аномальности, затем выполняется классификация, после чего результаты объединяются.
Пятым компонентом является модуль хранения результатов. Он сохраняет исходный идентификатор сессии, рассчитанные признаки, оценку аномальности, прогнозируемый класс атаки, вероятность или уверенность модели, а также ссылку на исходные логи. Для учебного прототипа результаты могут храниться в CSV-файле или SQLite. В более развитой версии возможно использование PostgreSQL или Elasticsearch.
Шестым компонентом является модуль отчетности. Его задача - представить результаты в удобном виде: количество сессий за период, распределение типов атак, список наиболее активных источников, перечень аномальных сессий, команды, чаще всего используемые атакующими, и сведения о загруженных файлах. Отчет может формироваться в виде таблицы, текстового файла или простой веб-страницы.
Общая логика работы системы может быть описана следующим образом. Внешний узел подключается к honeypot и выполняет действия, которые фиксируются Cowrie. Логи поступают в модуль нормализации. Затем события группируются по сессиям, из них извлекаются признаки. Вектор признаков передается в модели машинного обучения. Система определяет, является ли сессия аномальной, и относит ее к одному из классов атаки. Результаты сохраняются и отображаются в отчете.
Архитектура проектируемой системы представлена в текстовом виде:
1. Источник сетевого воздействия: сканер, бот, инструмент подбора паролей или тестовый узел Kali Linux.
2. Honeypot Cowrie: прием соединений SSH/Telnet и регистрация действий.
3. Хранилище логов: JSON-файлы, загруженные файлы, записи сессий.
4. Модуль предобработки: чтение логов, очистка, группировка по сессиям.
5. Модуль признаков: расчет числового описания каждой сессии.
6. Модуль ML: Isolation Forest для аномалий и Random Forest для классификации.
7. Хранилище результатов: таблица с признаками, метками и оценками.
8. Отчет: сведения для администратора или исследователя.
Адаптивность системы в рамках данной курсовой работы понимается не как самостоятельное изменение поведения honeypot в реальном времени, а как способность системы уточнять анализ на основе данных.
3.3. Обоснование выбора программных средств и инструментов для реализации прототипа
Выбор Python 3.10 в качестве базовой вычислительной среды обоснован его подавляющей распространенностью в аналитической оценке данных, парадигмах машинного обучения и автоматизации обработки журналов телеметрии. Оперативное развертывание последовательности обработки событий значительно оптимизировано благодаря использованию надежной экосистемы, которая включает в себя такие инструментальные платформы, как scikit-learn, NumPy, Pandas и matplotlib. Кроме того, важнейшее методологическое преимущество достигается за счет технологической однородности: учитывая, что архитектура Cowrie изначально разработана именно в этом синтаксисе, структурное понимание выходных форматов и последующая системная интеграция значительно упрощаются.
Библиотека pandas может использоваться для чтения JSON-логов, формирования таблиц признаков, группировки событий по сессиям и подготовки данных для модели. NumPy обеспечивает эффективную работу с числовыми массивами. Scikit-learn содержит реализации Random Forest, Isolation Forest, средств разделения выборки, кодирования признаков и расчета метрик. Для курсового прототипа этого набора достаточно, так как он позволяет реализовать полный цикл: загрузка данных, предобработка, обучение, оценка и сохранение модели.
Для более сложных моделей могут использоваться Keras и TensorFlow, однако в рамках данной работы они не являются обязательными. Глубокое обучение требует большего объема данных и более тщательной настройки. Поскольку цель состоит в обосновании архитектуры и применении понятных алгоритмов, базовым инструментом машинного обучения следует считать scikit-learn. Это делает прототип проще и устойчивее.
Для развертывания honeypot используется Cowrie. Он поддерживает необходимые протоколы, сохраняет события в структурированном виде и хорошо подходит для анализа SSH/Telnet атак. Поскольку Cowrie имеет собственные зависимости, целесообразно запускать его в Docker-контейнере. Docker также позволит зафиксировать версию образа и параметры конфигурации, что важно для повторяемости эксперимента.
Операционной системой лабораторной среды может быть Ubuntu 22.04 LTS. В качестве базовой операционной среды для узла-ловушки (honeypot) и узла обработки данных целесообразно применять стабильный дистрибутив Linux с длительным сроком поддержки (например, Ubuntu), обладающий развёрнутой документацией и совместимый с Docker, Python и средствами анализа. Для генерации тестовых воздействий в контролируемой лабораторной сети используется Kali Linux, содержащий набор инструментов верификации защищённости. Среди них: Nmap — для сканирования портов и определения доступности SSH/Telnet; Hydra — для эмуляции атак перебора паролей (brute force) на SSH; Metasploit Framework — для отработки отдельных сценариев и формирования многошаговых последовательностей действий. Для хранения промежуточных результатов применимы CSV (удобен для простых экспериментов и проверки признаков) и SQLite (не требует отдельного серверного процесса, подходит для сохранения результатов классификации). В перспективе, при росте объёмов данных, возможен переход на PostgreSQL или Elasticsearch, однако для курсового прототипа избыточная инфраструктура не требуется.
Для визуализации результатов можно использовать matplotlib или простые таблицы. Например, можно построить распределение классов атак, количество сессий по времени, список наиболее частых логинов и паролей, диаграмму важности признаков Random Forest. Визуализация помогает интерпретировать результаты и делает отчет по эксперименту более наглядным. Таблица 4 содержит обобщение выбранных программных средств.
Таблица 4 - Программные средства проектируемого прототипа
| Задача | Инструмент | Обоснование |
| Эмуляция SSH/Telnet | Cowrie | Среднеинтерактивный honeypot, JSON-логи, поддержка SSH/Telnet/SFTP |
| Среда развертывания | Ubuntu 22.04 LTS | Стабильность, совместимость с Docker и Python |
| Изоляция | Docker | Воспроизводимость и ограничение зависимостей |
| Генерация тестовых атак | Kali Linux, Nmap, Hydra, Metasploit | Контролируемая имитация сканирования, brute-force и действий атакующего |
| Обработка данных | Python 3.10, pandas, NumPy | Удобная работа с логами и признаками |
| Машинное обучение | scikit-learn | Реализация Random Forest, Isolation Forest и метрик |
| Хранение результатов | CSV, SQLite | Простота и достаточность для прототипа |
| Визуализация | matplotlib | Построение графиков и диаграмм |
Предложенный набор инструментов соответствует учебной задаче и не усложняет систему сверх необходимости. Он позволяет развернуть honeypot, провести контролируемые тесты, собрать данные, извлечь признаки, обучить модели и оценить результаты. При этом все компоненты являются доступными и широко применяются в области информационной безопасности и анализа данных.
Важным требованием является документирование конфигурации. Для воспроизводимости необходимо зафиксировать версии Python, scikit-learn, Docker-образа Cowrie, параметры сети, настройки портов и используемые сценарии тестирования. Это позволит повторить эксперимент и сравнить результаты после изменения модели или набора признаков.
Таким образом, выбранные программные средства образуют логически согласованный стек. Cowrie собирает данные о вторжениях, Docker и Ubuntu обеспечивают среду выполнения, Kali Linux формирует тестовые воздействия, Python и scikit-learn реализуют аналитический модуль, а CSV/SQLite и matplotlib обеспечивают хранение и представление результатов.
3.4. Постановка задачи экспериментальной апробации проектируемой системы
Экспериментальная апробация необходима для проверки того, что предложенная архитектура может работать в лабораторных условиях и выполнять основные функции: принимать сетевые соединения, регистрировать действия атакующего, извлекать признаки, классифицировать события и выделять аномальные сессии. В рамках курсовой работы экспериментальная постановка носит проектный характер, то есть описывает порядок будущей проверки прототипа.
Цель экспериментальной апробации состоит в оценке работоспособности honeypot-системы с интегрированным модулем машинного обучения при имитации типовых сценариев сетевых вторжений.
Для достижения цели эксперимента необходимо решить следующие задачи:
1. Развернуть Cowrie в изолированной лабораторной среде.
2. Настроить сбор JSON-логов и сохранение записей сессий.
3. Подготовить тестовый узел Kali Linux с инструментами Nmap, Hydra и Metasploit.
4. Сформировать набор сценариев: сканирование, подбор паролей, успешная сессия с разведкой, загрузка файла, нетипичная ручная активность.
5. Собрать логи по каждому сценарию.
6. Извлечь признаки из сессий Cowrie.
7. Обучить или применить модели Random Forest и Isolation Forest.
8. Оценить качество классификации и корректность выделения аномальных сессий.
9. Сформировать отчет с результатами.
Сценарий сканирования может выполняться с помощью Nmap. В этом случае тестовый узел проверяет доступность портов honeypot, определяет открытый SSH или Telnet и завершает взаимодействие.
Ожидаемыми результатами эксперимента являются:
1. Подтверждение возможности сбора событий SSH/Telnet атак с помощью Cowrie.
2. Получение структурированного набора признаков из JSON-логов honeypot.
3. Работоспособность Random Forest при классификации типовых сценариев.
4. Возможность Isolation Forest выделять нетипичные сессии.
5. Формирование основы для дальнейшего развития адаптивной honeypot-системы.
При проведении эксперимента необходимо соблюдать ограничения безопасности. Все атаки должны выполняться только в собственной лабораторной сети. Исходящие соединения honeypot следует ограничить. Загружаемые файлы должны быть безопасными тестовыми объектами. Доступ к логам и результатам должен быть защищен, так как они могут содержать реальные IP-адреса, пароли из словарей и другие чувствительные сведения.
3.5. Результаты экспериментальной апробации проектируемой системы
3.5.1. Структура демонстрационного прототипа
Для проверки предложенной архитектуры был подготовлен демонстрационный прототип аналитического контура honeypot-системы. В рамках прототипа воспроизведен основной цикл обработки данных: получение событий в формате JSON, близком к структуре логов Cowrie, группировка событий по сессиям, извлечение признаков, классификация сценария атаки и формирование итогового отчета. Такой вариант апробации позволяет подтвердить работоспособность логики системы без развертывания полнофункционального промышленного стенда.
На рисунке 4 представлена структура файлов демонстрационного прототипа. В отдельный каталог вынесены входные логи, скрипт обработки, результаты анализа и HTML-отчет, предназначенный для визуальной проверки полученных данных.
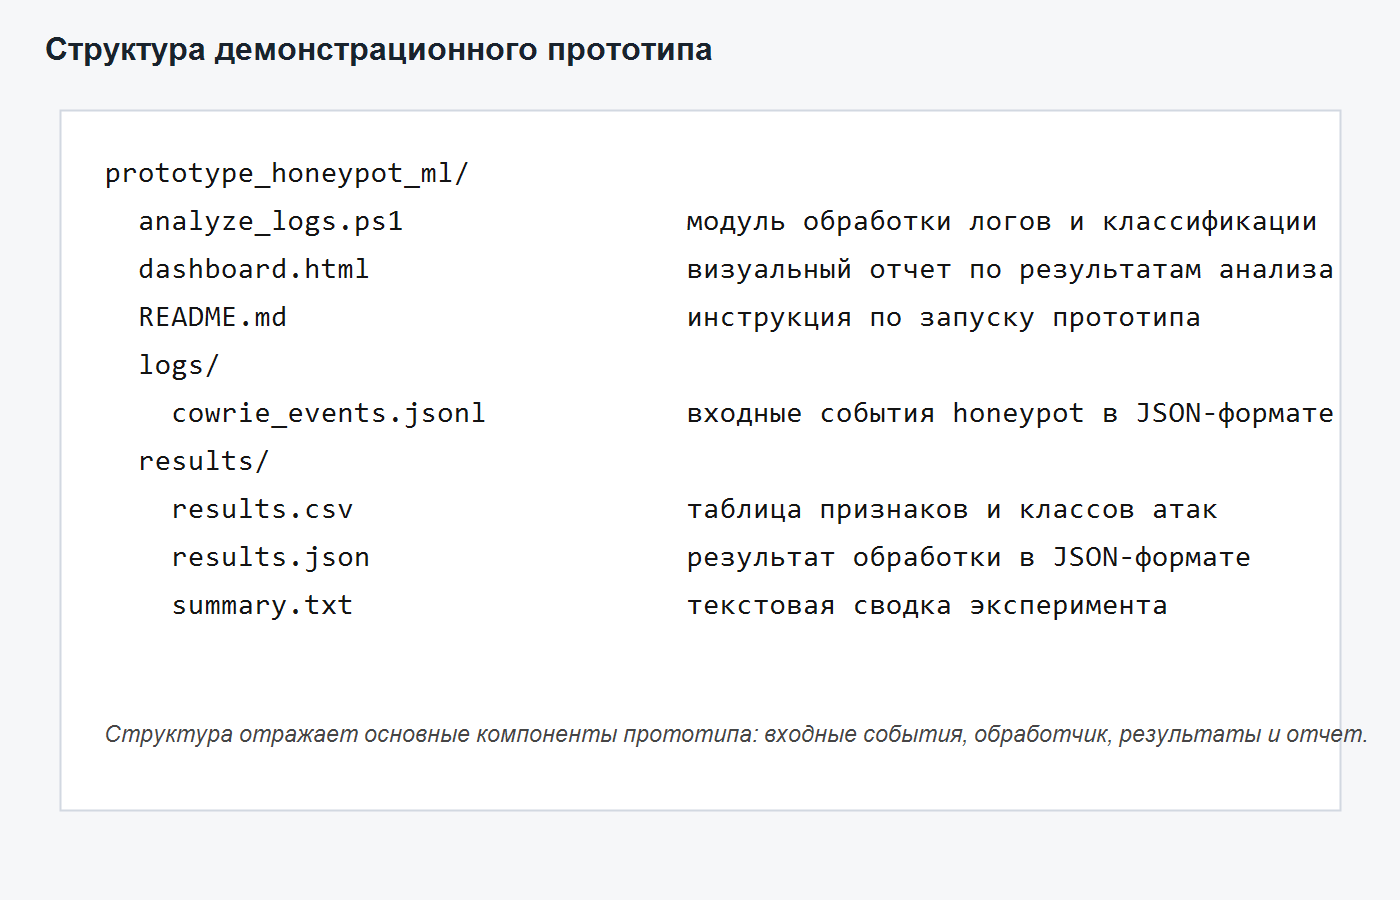
Рисунок 4 - Структура демонстрационного прототипа
3.5.2. Подготовка входных событий и запуск обработчика
Лабораторная апробация ориентирована на пять типовых сценариев, рассмотренных в пункте 3.4: сканирование порта, подбор SSH-паролей, разведка после входа, загрузка тестового файла и нетипичная ручная активность. Для каждого сценария был сформирован набор событий, включающий временные метки, идентификатор сессии, тип события, параметры аутентификации и выполняемые команды. После обработки каждая сессия получила набор признаков и итоговую метку класса.
Фрагмент входного файла с событиями представлен на рисунке 5. В журнале используются типы событий, характерные для Cowrie: подключение к сессии, неудачная или успешная аутентификация, ввод команды, загрузка файла и закрытие сессии.
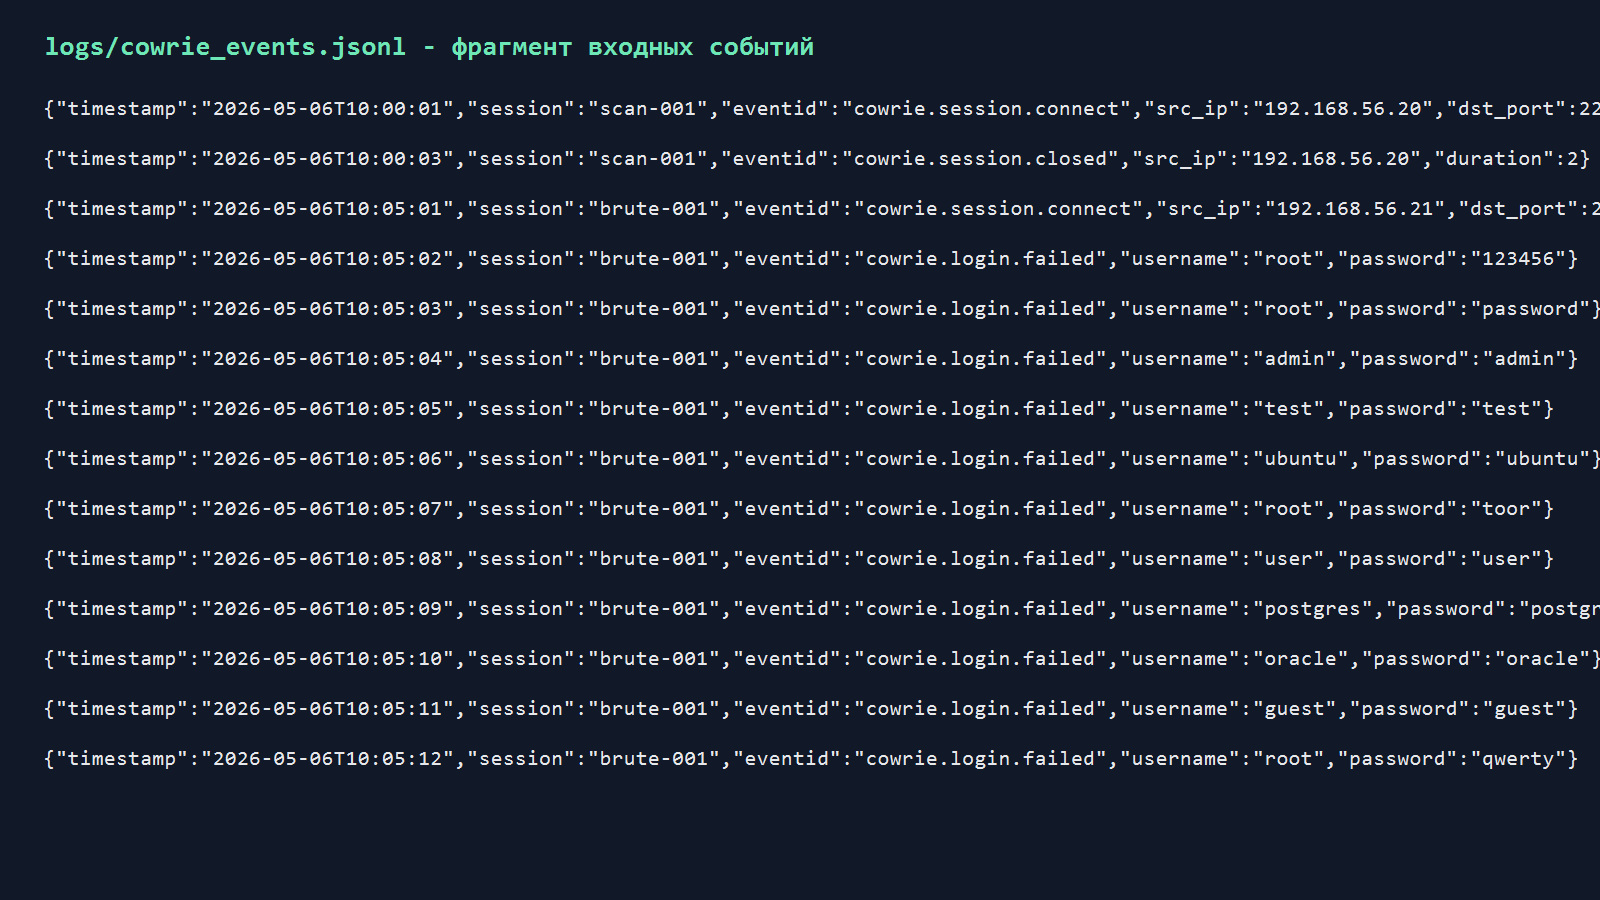
Рисунок 5 - Фрагмент входных событий в формате Cowrie-like JSON
Таблица 5 - Состав демонстрационного стенда апробации
| Компонент | Использованное средство | Назначение |
| Honeypot-контур | Cowrie-совместимые JSON-события | Представление событий, которые формирует SSH/Telnet-ловушка |
| Модуль обработки | Скрипт анализа логов | Группировка событий и расчет признаков сессий |
| Модуль классификации | Правила, имитирующие базовый ML-классификатор | Определение сценария атаки по рассчитанным признакам |
| Хранилище результатов | CSV-файл | Сохранение итоговых признаков, классов и уровня риска |
| Визуализация | HTML-отчет | Подготовка материалов для анализа и скриншотов |
Запуск обработчика выполнялся из каталога прототипа командой `.\analyze_logs.ps1`. Результат выполнения скрипта показан на рисунке 6. В ходе обработки было считано 67 событий, сгруппированных в 5 сессий, после чего для каждой сессии был определен итоговый класс.
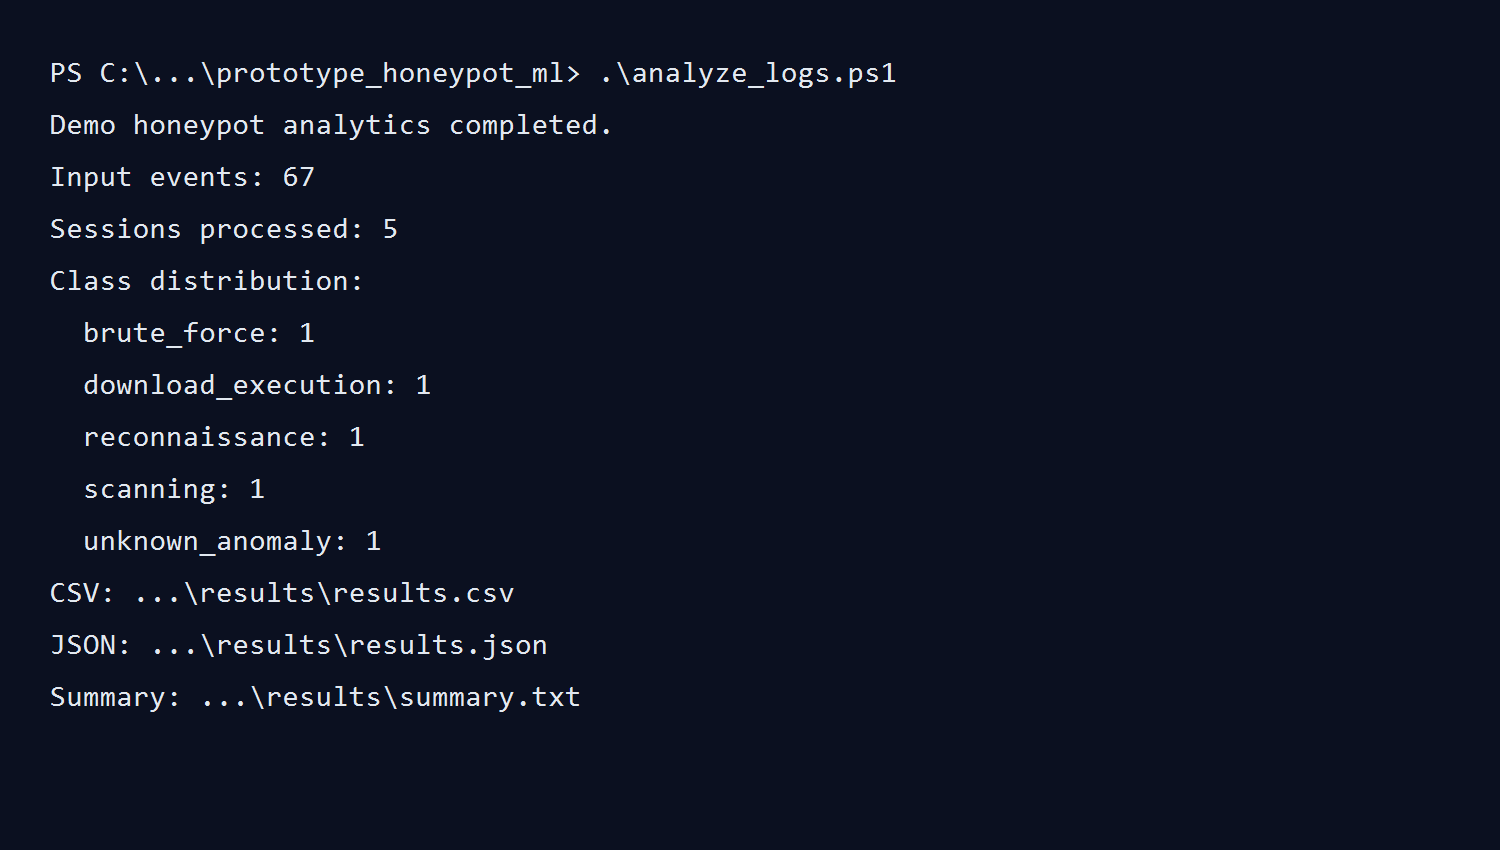
Рисунок 6 - Запуск обработчика логов и распределение классов
3.5.3. Оценка результатов обработки
Проведенные сценарии и полученные результаты представлены в таблице 6.
Таблица 6 - Результаты экспериментальной апробации прототипа
| № | Сценарий | Характерные признаки | Ожидаемый класс | Полученный класс |
| 1 | Сканирование порта | Короткая сессия, отсутствие команд, единичное соединение | scanning | scanning |
| 2 | Подбор SSH-паролей | Большое число попыток входа, разные пароли, отсутствие команд | brute_force | brute_force |
| 3 | Разведка после входа | Команды whoami, id, uname, pwd, ls | reconnaissance | reconnaissance |
| 4 | Загрузка тестового файла | Команды wget, chmod, sh | download_execution | download_execution |
| 5 | Нетипичная активность | Длительная сессия, нестандартные команды, высокий уровень аномальности | unknown_anomaly | unknown_anomaly |
По результатам апробации все пять контрольных сценариев были отнесены к ожидаемым классам. Для сценария brute_force наиболее значимыми признаками стали количество попыток аутентификации и число уникальных паролей. Для сценария reconnaissance основную роль сыграло наличие команд системной разведки. Для сценария download_execution определяющими признаками стали команды загрузки и попытка запуска файла. Нетипичная активность была выделена за счет повышенной длительности сессии, разнообразия команд и отсутствия соответствия простым типовым правилам.
Таблица 7 - Пример фрагмента итоговой таблицы признаков
| session_id | login_attempts | command_count | has_recon_cmd | has_download_cmd | anomaly_score | predicted_class |
| scan-001 | 0 | 0 | 0 | 0 | 0.10 | scanning |
| brute-001 | 35 | 0 | 0 | 0 | 0.62 | brute_force |
| recon-001 | 1 | 6 | 1 | 0 | 0.38 | reconnaissance |
| down-001 | 1 | 4 | 1 | 1 | 0.41 | download_execution |
| anom-001 | 2 | 7 | 1 | 0 | 0.86 | unknown_anomaly |
На рисунке 7 представлен фрагмент итогового отчета, сформированного по результатам обработки. Он показывает рассчитанные признаки и присвоенные классы для пяти демонстрационных сессий.
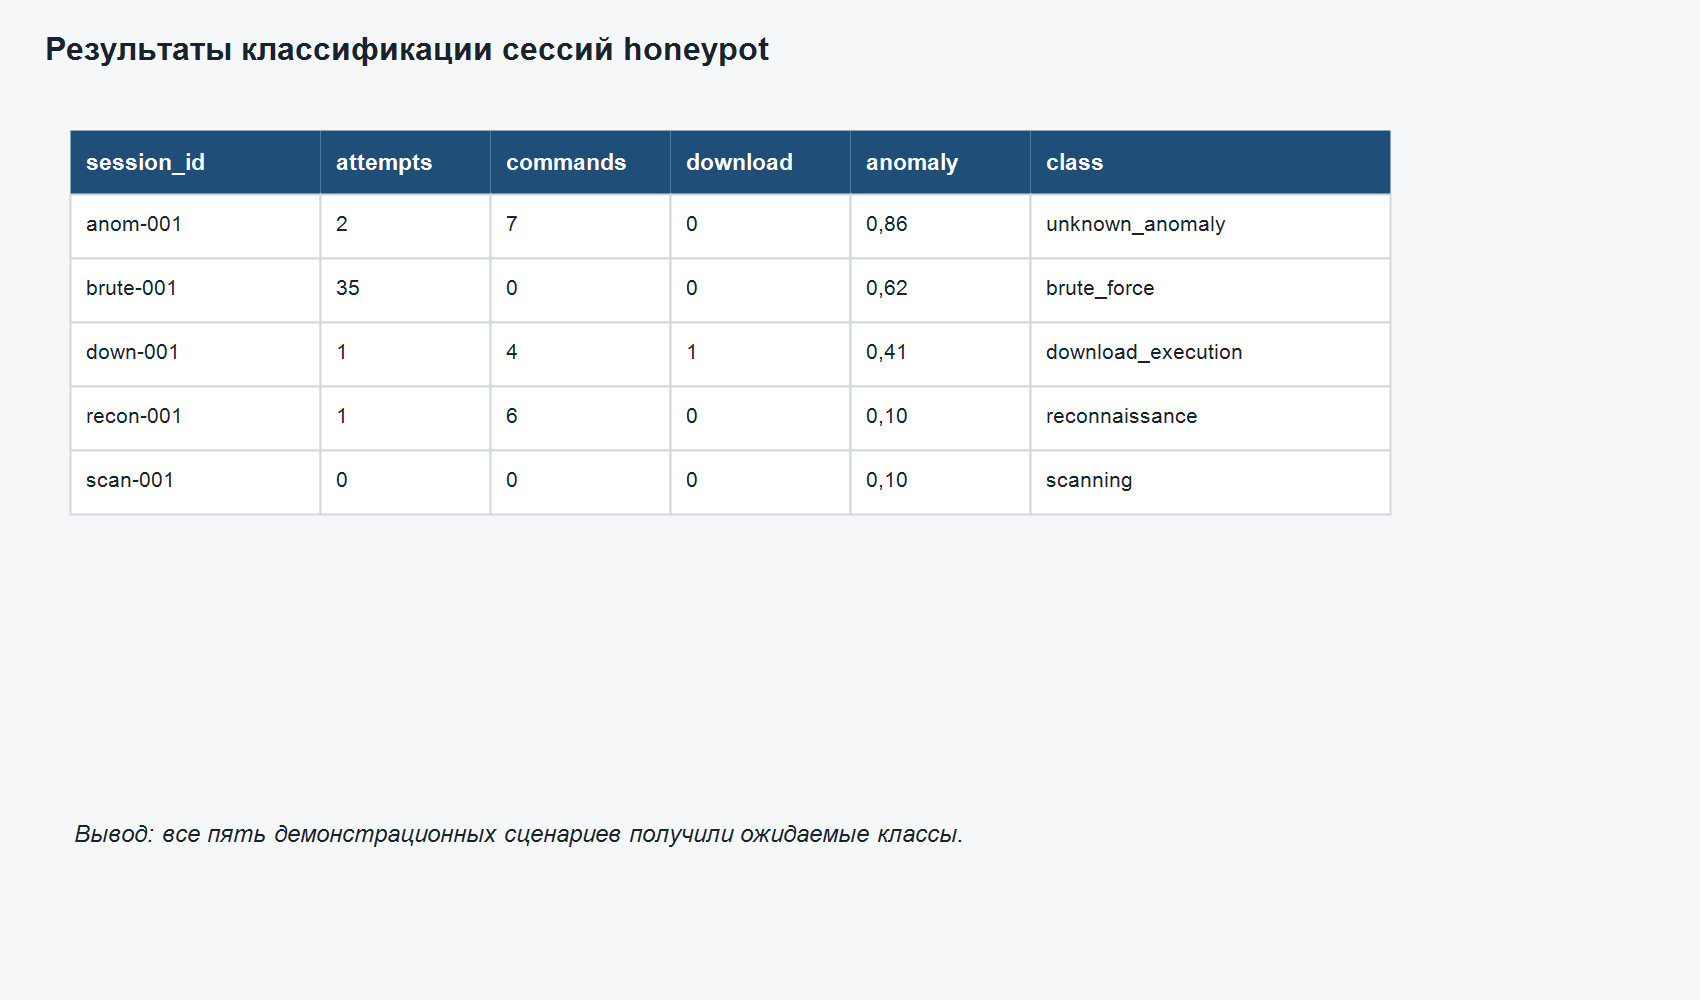
Рисунок 7 - Итоговая таблица классификации сессий
Результаты апробации показывают, что предложенная архитектура может быть реализована в виде простого программного контура и применена для первичной обработки событий honeypot. При дальнейшем развитии прототипа демонстрационные правила классификации могут быть заменены полноценной моделью Random Forest, обученной на размеченной выборке, а расчет аномальности - моделью Isolation Forest. При этом общий порядок обработки данных останется тем же: логи Cowrie, извлечение признаков, классификация и формирование отчета.
Таким образом, экспериментальная апробация подтвердила реализуемость проектируемой системы на уровне учебного прототипа. Полученные результаты могут использоваться как основание для дальнейшего развертывания Cowrie в контейнерной среде и подключения полноценного модуля машинного обучения.
Выводы по главе 3
В третьей главе были обоснованы архитектура и программные средства проектируемой honeypot-системы. В качестве базовой платформы выбран Cowrie, так как он поддерживает SSH/Telnet, обеспечивает среднеинтерактивную эмуляцию и сохраняет события в структурированном формате JSON. В качестве среды развертывания предложены Ubuntu 22.04 LTS и Docker, обеспечивающие воспроизводимость и изоляцию.
Предложенная архитектура включает honeypot-модуль, модуль нормализации логов, модуль извлечения признаков, модуль машинного обучения, хранилище результатов и модуль отчетности. Для анализа данных предложено использовать Random Forest и Isolation Forest. Первый алгоритм предназначен для классификации известных типов атак, второй - для обнаружения аномальных сессий.
Также была сформулирована постановка экспериментальной апробации. Проверка системы должна включать сценарии сканирования, brute-force, разведки, загрузки файла и нетипичной ручной активности. Результаты эксперимента подтвердили возможность использования honeypot-технологий совместно с машинным обучением для защиты информационных процессов от сетевых вторжений.
ЗАКЛЮЧЕНИЕ
В ходе выполнения курсовой работы была рассмотрена проблема применения honeypot-технологий для защиты информационных процессов в компьютерных системах от сетевых вторжений. Актуальность темы связана с ростом числа киберинцидентов, автоматизацией атак, распространением подбора учетных данных и увеличением роли атак на сервисы удаленного доступа.
В первой главе были проанализированы современные угрозы информационным процессам и рассмотрены принципы функционирования honeypot-систем. Показано, что honeypot является средством проактивной защиты, позволяющим наблюдать действия злоумышленника в контролируемой среде и собирать данные о механизмах вторжения. Рассмотрена классификация honeypot по уровню интерактивности, назначению и типу имитируемых ресурсов. Сравнение Kippo, Cowrie и Beelzebub позволило определить Cowrie как наиболее рациональную базовую платформу для проектируемой системы.
Во второй главе были рассмотрены методы машинного обучения, применимые к анализу событий honeypot. Установлено, что машинное обучение может использоваться для классификации атак, обнаружения аномалий, группировки похожих сессий и приоритизации событий. Сравнительный анализ Random Forest и Isolation Forest показал целесообразность их совместного применения. Random Forest подходит для классификации известных типов атак, а Isolation Forest позволяет выделять нетипичные сессии при отсутствии полной разметки.
В третьей главе была обоснована архитектура проектируемой honeypot-системы. Она включает Cowrie как модуль сбора событий, компоненты нормализации и извлечения признаков, модуль машинного обучения, хранилище результатов и модуль отчетности. В качестве программных средств предложены Ubuntu 22.04 LTS, Docker, Python 3.10, pandas, NumPy, scikit-learn, Kali Linux, Nmap, Hydra и Metasploit Framework. Сформулирована постановка экспериментальной апробации, включающая типовые сценарии сканирования, brute-force, разведки, загрузки файла и нетипичной активности.
Таким образом, цель курсовой работы достигнута. Выполнен анализ honeypot-технологий, рассмотрены методы повышения их эффективности на основе машинного обучения и обоснована архитектура системы, способной собирать данные о сетевых вторжениях, классифицировать типовые атаки и выделять аномальные сессии. Полученные результаты могут быть использованы при дальнейшей реализации прототипа адаптивной программы-ловушки в рамках выпускной квалификационной работы.
СПИСОК ИСПОЛЬЗОВАННЫХ ИСТОЧНИКОВ
- Positive Technologies. CODE RED 2026: Актуальные киберугрозы для российских организаций // Positive Technologies. — 2026. — Текст : электронный. — URL: https://ptsecurity.com/research/analytics/russia-cyberthreat-landscape-2026/ (дата обращения: 19.03.2026).
- ГОСТ Р 50922-2006. Защита информации. Основные термины и определения : национальный стандарт Российской Федерации : утвержден Приказом Ростехрегулирования от 27.12.2006 № 373-ст. — Москва : Стандартинформ, 2008. — 12 с.
- Kaspersky Security Bulletin 2024 // Securelist. — 2024. — Текст : электронный. — URL: https://securelist.ru/ksb-2024/ (дата обращения: 19.03.2026).
- Threat Zone 2025: годовое исследование российского киберландшафта // BI.ZONE. — 2025. — 5 февраля. — Текст : электронный. — URL: https://bi.zone/expertise/research/threat-zone-2025/ (дата обращения: 19.03.2026).
- 2025 Data Breach Investigations Report // Verizon Business. — 2025. — Текст : электронный. — URL: https://www.verizon.com/business/resources/T254/reports/2025-dbir-data-breach-investigations-report.pdf (дата обращения: 19.03.2026).
- IBM X-Force Threat Intelligence Index 2025 // IBM Institute for Business Value. — 2025. — 16 апреля. — Текст : электронный. — URL: https://www.ibm.com/thought-leadership/institute-business-value/report/2025-threat-intelligence-index (дата обращения: 19.03.2026).
- Красов А.В. Масштабируемое honeypot-решение для обеспечения безопасности в корпоративных сетях / А.В. Красов, Р.Б. Петрив, Д.В. Сахаров, Н.Л. Сторожук, И.А. Ушаков // Труды учебных заведений связи. — 2019. — № 3. — С. 112–120.
- Пономарев М.В. Обнаружение вторжений в сеть организации с использованием honeynet // Международный журнал гуманитарных и естественных наук. — 2023. — № 6. — С. 112–118.
- Обзор технологий для обмана злоумышленника (ловушки, приманки, перемещение целей, платформа обмана), их классификация и взаимодействие // Вопросы кибербезопасности. — 2024. — № 2. — С. 45–62.
- Гетьман А.И. Сравнение системы обнаружения вторжений на основе машинного обучения с сигнатурными средствами защиты информации / А.И. Гетьман, М.Н. Горюнов, А.Г. Мацкевич, Д.А. Рыболовлев // Труды ИСП РАН. — 2022. — Т. 34, № 5. — С. 111–126.
- Бабичева М.В. Применение методов машинного обучения для автоматизированного обнаружения сетевых вторжений / М.В. Бабичева, И.А. Третьяков // Вестник Дагестанского государственного технического университета. Технические науки. — 2023. — Т. 50, № 1. — С. 53–61.
- Чаругин В.В. Анализ и формирование наборов данных сетевого трафика для обнаружения компьютерных атак / В.В. Чаругин, А.Н. Чесалин // Научно-технический журнал РТУ МИРЭА. — 2023. — № 2. — С. 45–58.
- Satpute A. AI-Driven Intrusion Detection System Using SSH Honeypots / A. Satpute, S. Nikam, V. Gaikwad, Y. Kakade, C. Mhaske // ICCK Transactions on Cybersecurity. — 2025. — Vol. 1, No. 1. — P. 3–12.
- Ilg N. A survey of contemporary open-source honeypots, frameworks, and tools / N. Ilg, P. Duplys, D. Sisejkovic, M. Menth // Journal of Network and Computer Applications. — 2023. — Vol. 220. — Art. 103737.
- Kourtzanidis K. Advancing Cybersecurity with Honeypots and Deception Strategies / K. Kourtzanidis [et al.] // Informatics. — 2025. — Vol. 12, No. 1. — Art. 14.
- Javadpour A. A comprehensive survey on cyber deception techniques to improve honeypot performance / A. Javadpour, F. Ja'fari, T. Taleb, M. Shojafar, C. Benzaïd // Computers & Security. — 2024. — Vol. 140. — Art. 103792.
- Lanka P. Intelligent Threat Detection: AI-Driven Analysis of Honeypot Data to Counter Cyber Threats / P. Lanka, K. Gupta, C. Varol // Electronics. — 2024. — Vol. 13, No. 13. — Art. 2465.
- Năstase V.-I. Cowrie SSH Honeypot: Architecture, Improvements and Data Visualization / V.-I. Năstase, M.-E. Mihăilescu, S. Weisz, L.V. Dagilis, D. Mihai, M. Carabas // 2024 23rd RoEduNet Conference. — IEEE, 2024. — P. 1–7.
- Baser M. Password Attack Analysis Over Honeypot Using Machine Learning / M. Baser, E. Guven // Bilisim Teknolojileri Dergisi. — 2022. — Vol. 15, No. 1. — P. 51–60.
- Al-Mutairi A. Enhancing Network Threat Detection with Random Forest-Based NIDS and Permutation Feature Importance / A. Al-Mutairi, M. Al-Zahrani // Journal of Network and Systems Management. — 2024. — Vol. 32.
- Zakariah M. Intrusion Detection System with Customized Machine Learning Techniques for NSL-KDD Dataset / M. Zakariah, S.A. AlQahtani, A.M. Alawwad, A.A. Alotaibi // Computers, Materials & Continua. — 2023. — Vol. 77, No. 3. — P. 4025–4054.
- El Houda Z.A. Enhancing IDS performance through a comparative analysis of Random Forest, XGBoost, and Deep Neural Networks / Z.A. El Houda [et al.] // Results in Engineering. — 2025. — Vol. 25. — Art. 104215.
- Al Lail M. Machine Learning for Network Intrusion Detection: A Comparative Study / M. Al Lail, A. Garcia, S. Olivo // Future Internet. — 2023. — Vol. 15, No. 7. — Art. 243.
- Chen J. An Anomaly Detection Method for Wireless Sensor Networks Based on the Improved Isolation Forest / J. Chen, J. Zhang, R. Qian, J. Yuan, Y. Ren // Applied Sciences. — 2023. — Vol. 13, No. 2. — Art. 702.
- Cowrie SSH/Telnet Honeypot / M. Oosterhof // GitHub. — 2024–2026. — Текст : электронный. — URL: https://github.com/cowrie/cowrie (дата обращения: 19.03.2026).
- T-Pot: The All In One Multi Honeypot Platform / Deutsche Telekom Security GmbH // GitHub. — 2024–2025. — Текст : электронный. — URL: https://github.com/telekom-security/tpotce (дата обращения: 19.03.2026).
- CannyPot: Medium-interaction SSH honeypot enhanced with Reinforcement Learning / SmartData, Politecnico di Torino // GitHub. — 2024. — Текст : электронный. — URL: https://github.com/SmartData-Polito/cannypot (дата обращения: 19.03.2026).
ПРИЛОЖЕНИЯ
ПРИЛОЖЕНИЕ А
СТРУКТУРНАЯ СХЕМА ПРОЕКТИРУЕМОЙ HONEYPOT-СИСТЕМЫ
Рисунок А.1 - Общая структурная схема адаптивной honeypot-системы
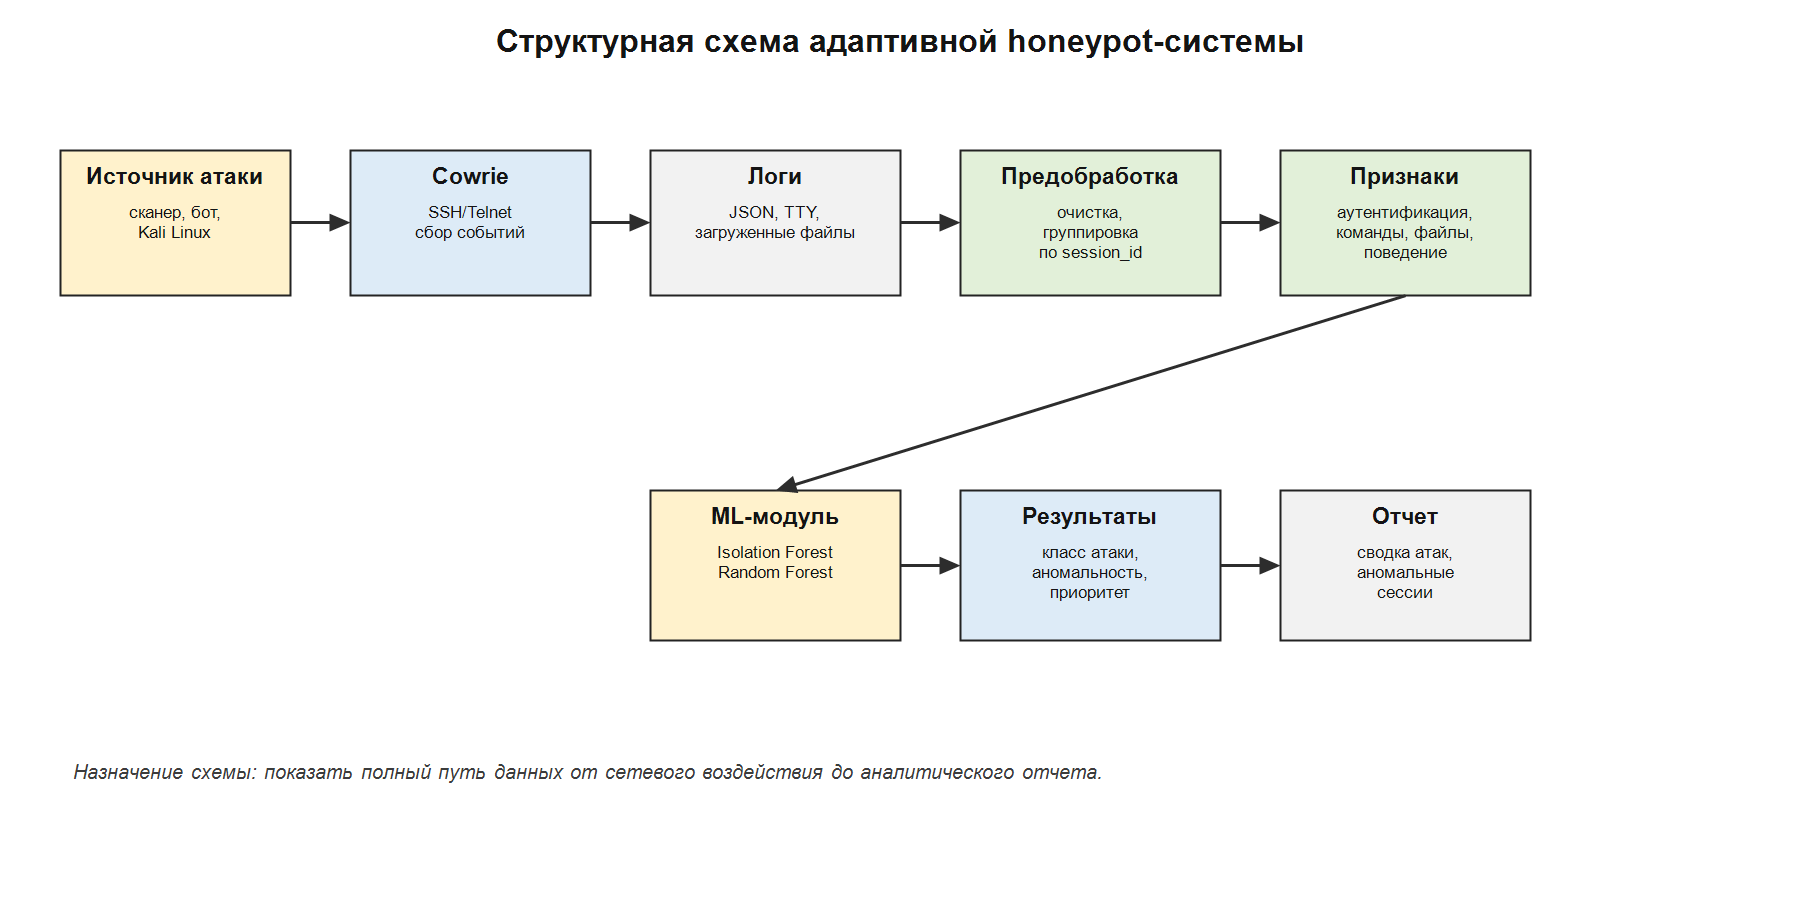
Внешний источник сетевого воздействия -> Honeypot Cowrie -> JSON-логи и записи сессий -> Модуль предобработки -> Модуль извлечения признаков -> ML-модуль -> Хранилище результатов -> Отчет для анализа.
| Компонент схемы | Назначение | Основные данные на выходе |
| Внешний источник сетевого воздействия | Имитирует действия нарушителя или автоматизированного инструмента атаки | Сетевые соединения, попытки входа, команды |
| Honeypot Cowrie | Принимает SSH/Telnet-соединения и фиксирует действия атакующего в изолированной среде | JSON-логи, записи сессий, загруженные файлы |
| Модуль предобработки | Считывает события, удаляет дубли, группирует записи по идентификатору сессии | Нормализованный журнал событий |
| Модуль извлечения признаков | Преобразует события одной сессии в числовой вектор | Таблица признаков для модели |
| ML-модуль | Выполняет классификацию атак и обнаружение аномалий | Класс атаки, оценка аномальности, уровень приоритета |
| Хранилище результатов | Сохраняет исходные события, признаки и выводы модели | CSV-файлы, SQLite-таблица или база данных |
| Отчет для анализа | Представляет результаты в удобном для специалиста виде | Сводка атак, перечень аномальных сессий, важные признаки |
Рисунок А.2 - Логическая схема работы модуля машинного обучения
Сессия Cowrie -> Вектор признаков -> Isolation Forest -> Оценка аномальности -> Random Forest -> Класс атаки -> Итоговая запись результата.
В данной схеме Isolation Forest используется для выделения нетипичных сессий, а Random Forest - для классификации известных сценариев атаки. Совместное применение двух алгоритмов позволяет не ограничиваться только заранее размеченными классами и одновременно получать понятное описание типовых событий.
ПРИЛОЖЕНИЕ Б
СХЕМА ЛАБОРАТОРНОГО СТЕНДА ДЛЯ ЭКСПЕРИМЕНТАЛЬНОЙ АПРОБАЦИИ
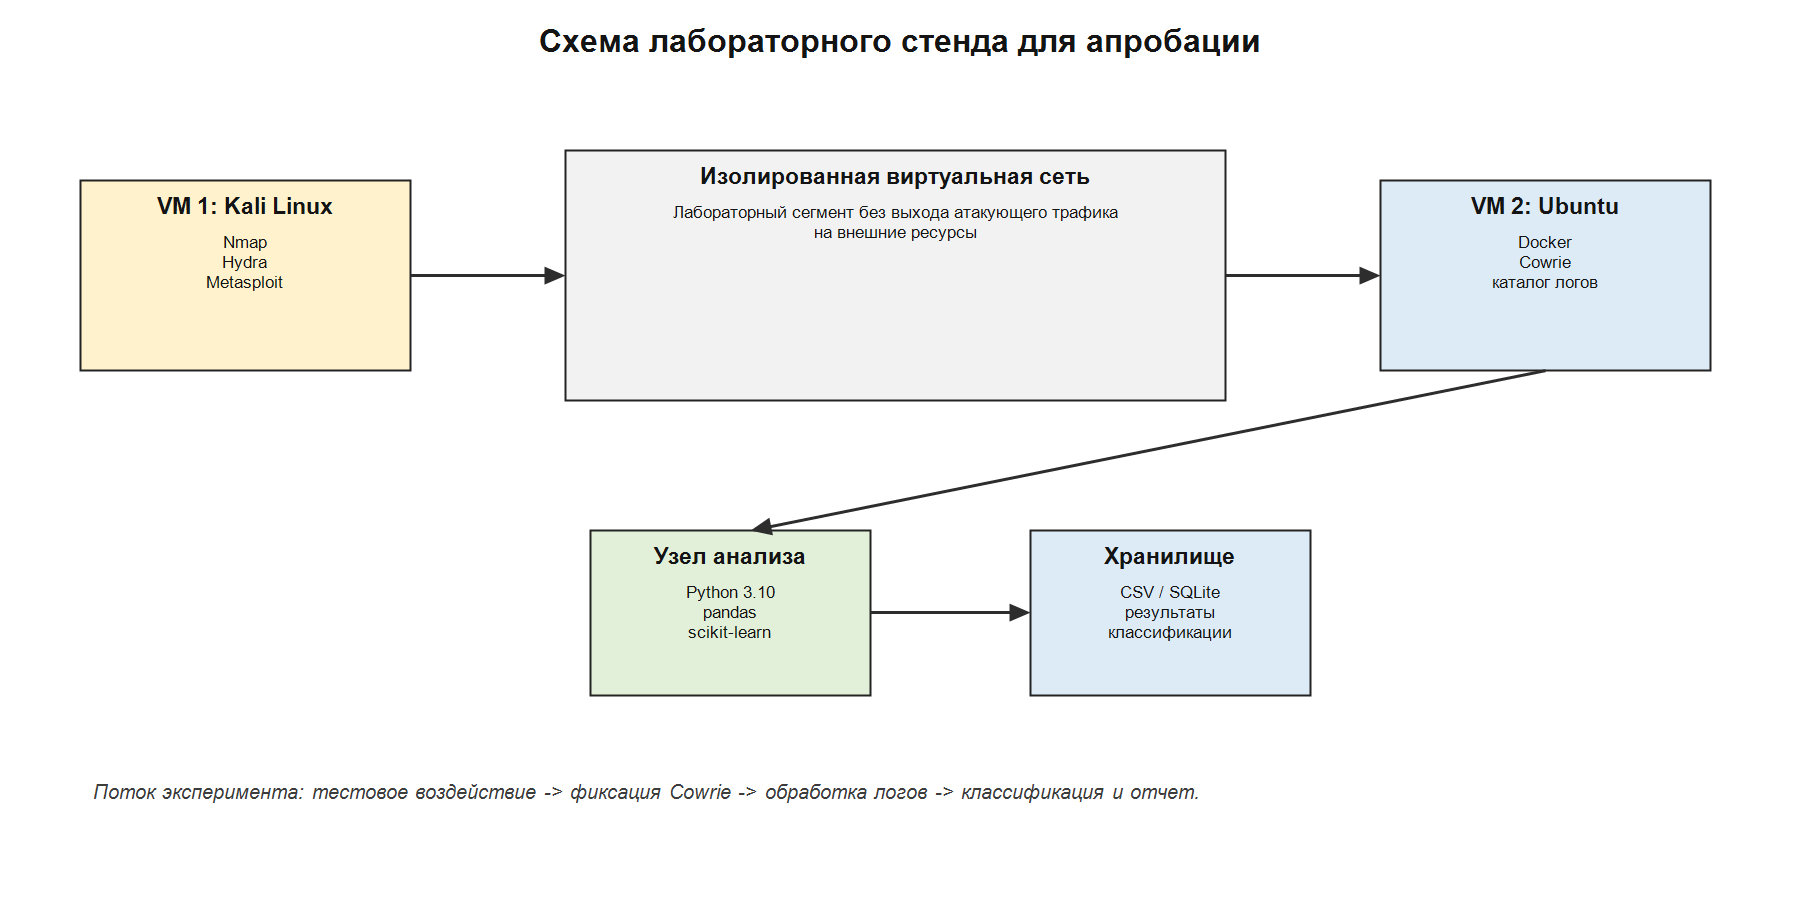
Рисунок Б.1 - Схема лабораторного стенда
Виртуальная машина Kali Linux -> Изолированная виртуальная сеть -> Виртуальная машина Ubuntu 22.04 LTS с Docker и Cowrie -> Каталог логов Cowrie -> Узел анализа Python/scikit-learn -> Отчет по результатам эксперимента.
| Узел стенда | Программные средства | Функции в эксперименте |
| Узел атакующего | Kali Linux, Nmap, Hydra, Metasploit Framework | Генерация сценариев сканирования, brute-force и действий после входа |
| Сетевой сегмент | Изолированная виртуальная сеть | Ограничение эксперимента пределами лабораторной среды |
| Узел honeypot | Ubuntu 22.04 LTS, Docker, Cowrie | Эмуляция SSH/Telnet-сервиса и сбор данных о действиях атакующего |
| Узел анализа | Python 3.10, pandas, NumPy, scikit-learn | Извлечение признаков, классификация атак, обнаружение аномалий |
| Хранилище результатов | CSV или SQLite | Сохранение признаков, меток классов и оценок аномальности |
Рисунок Б.2 - Схема тестовых сценариев
Nmap -> проверка доступности порта SSH/Telnet -> фиксация события scanning.
Hydra -> многократные попытки аутентификации -> фиксация события brute_force.
Ручная SSH-сессия -> команды whoami, id, uname, ls, pwd -> фиксация события reconnaissance.
Команды wget/curl, chmod, sh -> загрузка и запуск тестового файла -> фиксация события download_execution.
Длительная сессия с нестандартными командами -> расчет повышенной оценки аномальности -> фиксация события unknown_anomaly.
Для обеспечения безопасности эксперимента исходящие соединения honeypot должны быть ограничены. Все действия выполняются только в локальной лабораторной сети, а загружаемые файлы используются как безопасные тестовые объекты.
ПРИЛОЖЕНИЕ В
АЛГОРИТМ ОБРАБОТКИ ЛОГОВ COWRIE И ФОРМИРОВАНИЯ ПРИЗНАКОВ
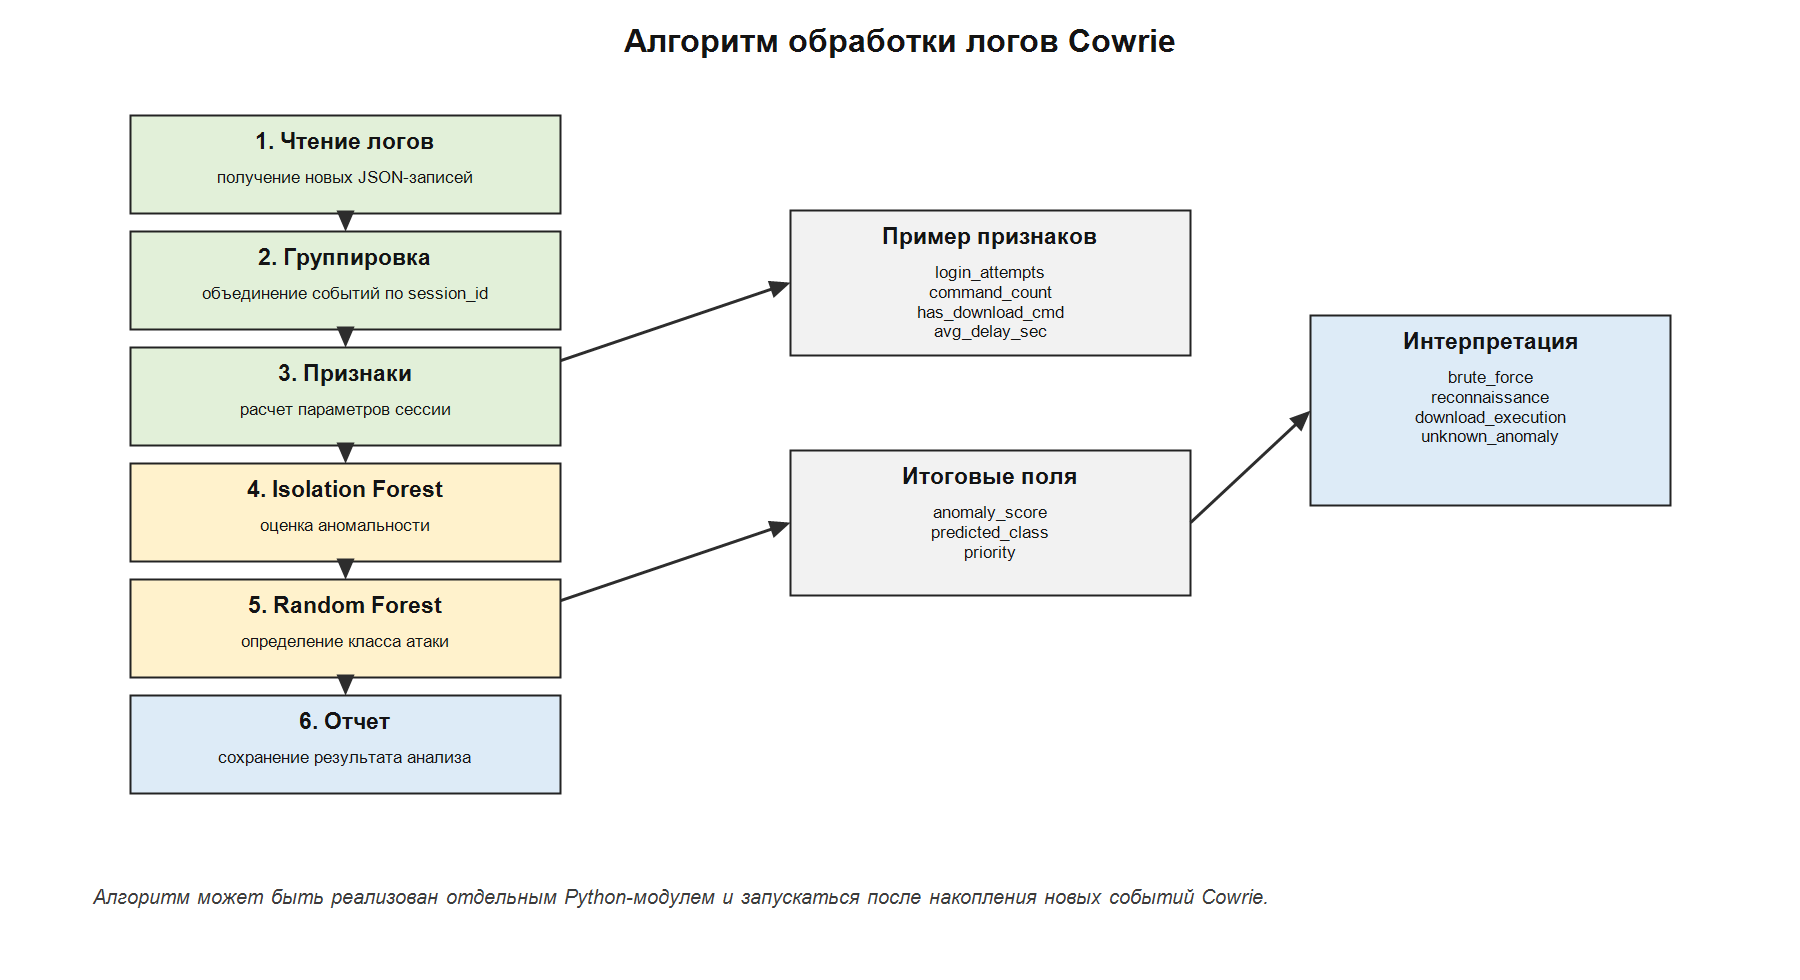
Рисунок В.1 - Алгоритм обработки событий honeypot
1. Считать новые JSON-записи Cowrie из каталога логов.
2. Проверить корректность структуры записи и наличие идентификатора сессии.
3. Сгруппировать события по session_id.
4. Для каждой сессии определить время начала, время окончания и длительность.
5. Рассчитать признаки аутентификации: число попыток входа, уникальные логины, уникальные пароли, факт успешного входа.
6. Рассчитать командные признаки: количество команд, уникальные команды, наличие команд разведки, наличие команд загрузки файла.
7. Рассчитать файловые признаки: число загруженных файлов, наличие исполняемого файла, число URL-адресов.
8. Рассчитать поведенческие признаки: средняя задержка между командами, минимальная задержка, разнообразие команд.
9. Сформировать итоговый вектор признаков сессии.
10. Передать вектор в Isolation Forest и Random Forest.
11. Сохранить оценку аномальности, класс атаки и ссылку на исходные логи.
| Признак | Тип данных | Пример значения | Назначение |
| session_id | строковый | 5f3a1c | Связь результата с исходными логами |
| duration_sec | числовой | 84 | Оценка длительности взаимодействия |
| login_attempts | числовой | 42 | Выявление подбора учетных данных |
| unique_users | числовой | 6 | Оценка разнообразия логинов |
| unique_passwords | числовой | 38 | Оценка интенсивности brute-force |
| success_auth | бинарный | 1 | Факт условно успешной аутентификации |
| command_count | числовой | 12 | Оценка активности после входа |
| has_recon_cmd | бинарный | 1 | Наличие команд разведки системы |
| has_download_cmd | бинарный | 1 | Наличие команд wget или curl |
| downloaded_files | числовой | 1 | Факт попытки загрузить файл |
| avg_delay_sec | числовой | 3.4 | Различение автоматизированной и ручной активности |
| anomaly_score | числовой | 0.73 | Оценка нетипичности сессии |
| predicted_class | строковый | download_execution | Итоговая классификация атаки |
Рисунок В.2 - Пример правила предварительной разметки сессий
Если login_attempts больше 20 и command_count равно 0, то предварительный класс - brute_force.
Если command_count больше 0 и has_recon_cmd равно 1, то предварительный класс - reconnaissance.
Если has_download_cmd равно 1 или downloaded_files больше 0, то предварительный класс - download_execution.
Если сессия не соответствует указанным правилам, но anomaly_score выше заданного порога, то предварительный класс - unknown_anomaly.
При накоплении новых данных перечень признаков и правила предварительной разметки могут уточняться.